제1절 VAR에서 VARX로
산업 n개의 실질부가가치 성장률을 한 벡터 y(t)로 묶으면, 벡터자기회귀(VAR)는 각 산업의 성장률을 자신과 다른 산업들의 과거 성장률로 설명한다. 여기에 3장의 외생변수 6종 x(t)를 더한 것이 VARX이다.
y(t) = c + A(1) y(t−1) + … + A(p) y(t−p) + B x(t) + u(t)
외생변수는 산업모형 안에서 설명되지 않고 시나리오별 경로로 주어진다. 따라서 같은 산업모형에 다섯 시나리오의 외생 경로를 넣으면 시나리오별 산업 전망이 나온다.
제2절 계수 사전분포 — 미네소타 대 산업연관표
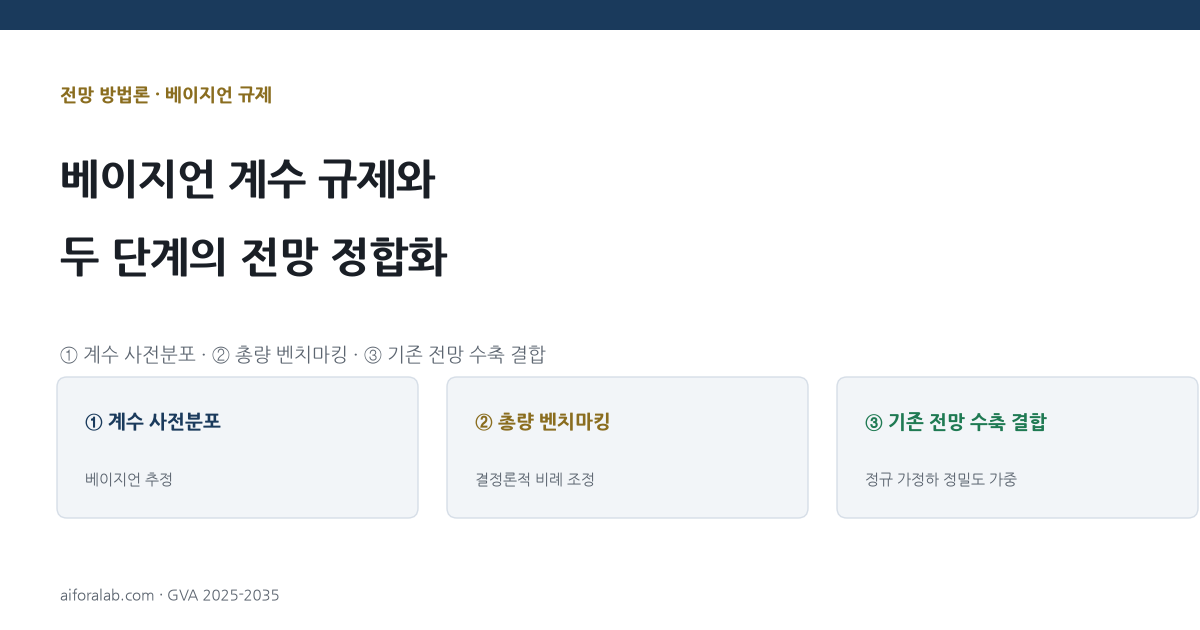
산업 수가 많으면 추정할 계수가 표본보다 많아진다. 62개 산업 VAR에 1기 시차만 넣어도 계수 행렬 A(1)의 원소가 3,844개인데 분기 표본은 104개뿐이다. 베이지언 VARX는 계수에 사전분포를 두어 대부분의 계수를 0 근처로 규제하고, 자료가 강하게 지지하는 계수만 0에서 멀어지게 한다.
두 가지 사전분포를 비교하였다. 미네소타 사전분포는 각 산업이 자기 과거값을 중심으로 움직이고 다른 산업의 계수와 먼 시차의 계수는 0에 가깝다고 본다. 모든 산업 쌍을 같은 강도로 규제한다는 한계가 있다. 산업연관표 사전분포는 산업연관표의 생산유발계수(한 산업의 수요가 다른 산업의 생산을 직간접으로 유발하는 정도)가 큰 산업 쌍의 계수는 덜 규제하고, 연계가 거의 없는 쌍의 계수는 강하게 규제한다. 예를 들어 자동차 식에서 1차 금속·전자부품 계수는 느슨하게, 교육서비스 계수는 강하게 0으로 묶는다.
제3절 열두 개 후보와 표본 분할
명세 3개(로그차분·로그수준·벡터오차수정모형), 사전분포 2개(미네소타·산업연관표), 외생변수 포함 여부 2개(VARX·VAR)를 교차한 12개 후보를 36·62·69개 산업 단위마다 추정하였다. 표본은 학습 구간(2000년 1분기–2021년 4분기, 88분기), 검증 구간(2022년 1분기–2023년 4분기, 8분기), 시험 구간(2024년 1분기–2025년 4분기, 8분기)으로 나누고, 검증·시험 구간의 시점외 예측오차로 후보를 비교하였다.
제4절 선택 결과
세 산업 단위 모두에서 로그차분 명세 + 산업연관표 사전분포 + 외생변수 포함(VARX) 이 검증 구간의 예측오차(RMSE)가 가장 작아 선택되었다(36·62·69분류 각각 6.74·6.18·6.23). 시험 구간에서도 오차가 작았으나(3.11·3.31·3.45), 세 분류 모두 외생변수를 뺀 VAR가 조금 더 작았다(2.92·3.27·3.44). 따라서 외생변수는 예측 정확도를 크게 높인다기보다 시나리오가 산업에 전달되는 통로로서 의미가 크다. 총량(실질 GDP 한 계열)은 수준 명세의 VAR가 검증 구간 오차가 가장 작다(0.414). 5장은 총량 모형을 시나리오 간 차이를 내는 데만 쓴다.
선택 결과의 강건성도 점검하였다. 로그차분과 VARX는 규제 강도(λ = 0.05–0.4)와 관계없이 우위를 유지하였다. 반면 62·69분류에서 산업연관표 사전분포가 미네소타 사전분포보다 낫다는 결과는 λ = 0.2에서만 성립하고 차이도 작다(62분류 0.007, 69분류 0.002). 한편 고정 비중으로 나눈 하위 산업은 상위 산업과 과거 성장률이 같으므로, 62·69개 패널의 서로 다른 성장률 계열은 각각 32·34개이다. 분류 간 예측오차를 직접 비교하는 데는 이 점을 감안해야 한다.
이 비교표는 실질금리를 1차 차분으로 넣은 2026년 10월 정비판 외생변수(3장)로 계산하였다. 실질금리를 수준으로 넣은 이전 판과 비교하면 검증 구간 RMSE의 차이는 산업 패널에서 최대 0.05, 총량에서 0.06이며, 네 단위 모두 선택 결과가 같다. 후보별 예측오차와 이전 판 대비 표는 재현 패키지에 정리하였다.
실질금리를 차분으로 바꾸자 계수의 체계적인 양(+)의 부호가 사라졌다. 선택 모형을 전체 표본으로 적합했을 때 실질금리 계수 합계가 음(−)인 산업의 비율은 62분류에서 19%에서 45%로 늘고, 부가가치 가중평균 계수 합계는 +0.195에서 +0.015로 0에 가까워졌다(36분류 +0.213 → +0.119, 69분류 +0.198 → +0.010). 다만 뚜렷한 음(−)으로 바뀌지는 않아, 실질금리 상승이 산업 성장을 낮춘다는 이론적 방향이 자료에서 강하게 확인되지는 않는다.
제5절 전망의 요인 분해(SHAP)
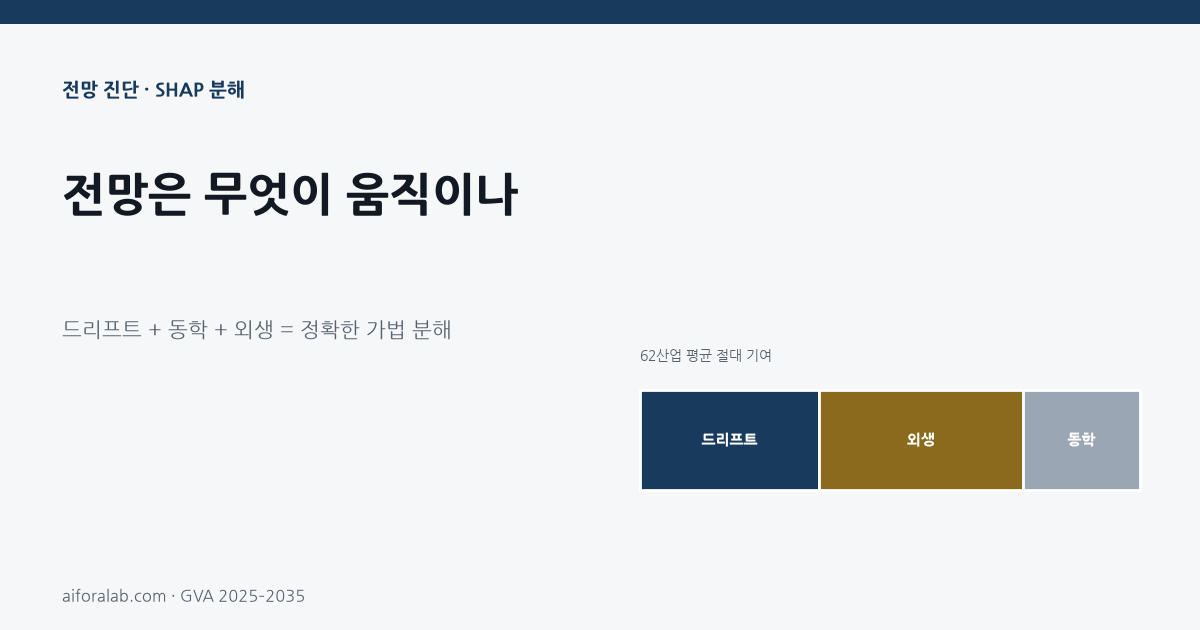
선택한 모형의 10년 전망을 세 부분으로 나눈다. 드리프트는 상수항이 만드는 평균 추세 성장, 동학은 산업 간 상호작용과 과거값의 영향, 외생 기여는 외생변수 6종 각각의 기여이다. 선형 모형이므로 외생 기여는 '계수 × 외생 경로'로 정확히 나뉘며, 기여의 합이 전망과 일치한다. 이 분해는 6장의 외생변수 진단에 쓴다.
자세히 보기
이 장에 속한 포털 페이지 9개
방법론 4개
재현 패키지
2026-10 정비판. 입수 → 분석 → 결과 세 노트북이 정비판 외생(실질금리 1차 차분)으로 36·62·69개 산업과 총량의 베이지언 VARX 12개 옵션을 다시 추정하고, 이전 판 공표 그리드도 재현하며, 실질금리 계수의 부호를 점검한다. 마지막 검증 셀이 정비판 기록 그리드·이전 판 공표 그리드(각 144개)와 선택 옵션·핵심 수치 등 308개 항목을 대조한다.
필요한 것: 인증키·비공개 자료 불필요(2장·3장 산출물 사본 동봉)
R 사용: R은 쓰지 않는다. 모든 계산은 닫힌 형태의 선형대수(numpy)이다.
실행: pip install -r requirements.txt 후 python run_all.py. 마지막 노트북의 검증 셀이 원고 수치와 대조하며, 다르면 실행이 멈춘다.
분석
묶음 파일 51개와 SHA-256
| 01_입수.ipynb | b5a951856720e9c3… |
| 02_분석.ipynb | 09f8e2b72870b484… |
| 03_결과.ipynb | 994c49eca563ff4b… |
| README.md | bd9fc3b631e7e783… |
| config.py | 797306d4a0497c1a… |
| data/inputs/PROVENANCE.md | 82af935580e4b79c… |
| data/inputs/exog_hist_v2.csv | d142ff2992b5ae3e… |
| data/inputs/exog_hist_v2_20260828.csv | e0b0064e0c7cd600… |
| data/inputs/io_linkage_62.csv | 3f747a97c3804541… |
| data/inputs/io_linkage_69.csv | 1f57d01c6867b456… |
| data/inputs/io_linkage_W.csv | cf11efc744586d35… |
| data/inputs/levels_62.csv | 00469e892aac4742… |
| data/inputs/levels_69.csv | c8a5adcedfa4635c… |
| data/inputs/levels_agg.csv | f04021ff282e5387… |
| data/inputs/levels_sa.csv | ccfc8dad3c8cd7b0… |
| data/published/grid_summary_36.csv | 69127ac44e7ff3de… |
| data/published/grid_summary_62.csv | 4cdcec47502d294c… |
| data/published/grid_summary_69.csv | 1dbd1343396a68ba… |
| data/published/grid_summary_AGG.csv | a08f670cc131b6c1… |
| data/published_prev/grid_summary_36.csv | dcaaf085b1aa4f66… |
| data/published_prev/grid_summary_62.csv | ed55591b7b4f4ca3… |
| data/published_prev/grid_summary_69.csv | b0b5bd1539ebd296… |
| data/published_prev/grid_summary_AGG.csv | 5a269aaaa3dac67d… |
| output/check_io36_normalized.csv | fc393ccc716ea136… |
| output/check_prev_vs_new.csv | 8f19af88f19cb875… |
| output/check_prev_vs_new_summary.csv | 0ca816884a7a22ef… |
| output/decomposition_check_62.csv | 539ccbb66eba4c22… |
| output/fig1_rmse_69.png | ab1cdbaaac9da34b… |
| output/fig2_valid_heatmap.png | 61197aa65bb1ab9a… |
| output/grid_36.csv | ffd1b2a1427fef50… |
| output/grid_62.csv | 4ee67c17960a4032… |
| output/grid_69.csv | 22fb0044861240f2… |
| output/grid_AGG.csv | b2017d16653cb5cb… |
| output/grid_prev_36.csv | 7763f7bdcfb0a97e… |
| output/grid_prev_62.csv | a18f56ff5664f2e7… |
| output/grid_prev_69.csv | 6c9db2c4e0ef13c2… |
| output/grid_prev_AGG.csv | 3e0fad0e8fe807a0… |
| output/lambda_sensitivity.csv | 0fbefeee6c37650f… |
| output/real_rate_coef.csv | cc5d069c0980dfcb… |
| output/real_rate_sign.csv | a529baccaea28c5c… |
| output/run_log.txt | 1b51dbb82342db12… |
| output/table1_grid_rmse.csv | d75e4aaa9bf29df3… |
| output/table2_selected.csv | f13dfbf86ff455fe… |
| output/table3_axis_means.csv | 2d6f70ad8961e381… |
| output/table4_checks.csv | ed1e95c43ed2f14a… |
| output/table5_vs_prev.csv | e3f7440381def153… |
| output/table6_real_rate_sign.csv | 3ea1654ef08a5dd5… |
| output/verification.csv | 9f90ae57736b6a37… |
| requirements.txt | 130280ce781a4e17… |
| run_all.py | 2a5dbd80df3b2248… |
| src/varx_grid.py | abcbcd102d3e544b… |