← 포털 · GVA 2025–2035 · 챕터 2 / 5
BVAR 완성 — 미네소타 vs 산업연관표 prior
미네소타 수축을 산업연관 구조로 차등화한 사전분포를 만들어, 같은 36개 산업 BVAR을 두 prior로 추정·비교한다.
- ▶ Colab 노트북(주석·셀번호 포함): I-O 설계
 ch2_io_prior.ipynb 프라이어 비교 ch2_bvar_compare.ipynb — 배지=GitHub 게시 시 원클릭, 또는 .ipynb 내려받아 Colab에 업로드
- 설계: code/ch2_io_prior.py → 매핑·연계강도 W·차등 ω
- 비교: code/ch2_bvar_compare.py → 미네소타 vs I-O prior 추정·검증
- 데이터: dlog_rates_sa.csv, io_production_inducement_long.csv
- 실행:
python code/ch2_io_prior.py→python code/ch2_bvar_compare.py
요약 (먼저 읽기)
- 아이디어
- 미네소타는 모든 교차항을 균등 수축. I-O prior는 산업연관 연계가 강한 쌍은 느슨, 약한 쌍은 0으로 더 수축.
- 설계
- 생산유발계수(2023)로 연계강도 W → 미네소타 대비 차등계수 ω∈[0.2,5]. 60% 쌍이 추가 수축, 8%가 느슨.
- 예측력
- 동일 test에서 미네소타와 대등(1단계 4.51 vs 4.53, 1년 4.57 vs 4.56). 산업별 승패도 18/36·15/36으로 반반.
- 구조
- I-O prior의 계수는 더 희소(교차 |A₁| 0.055→0.043)하고 경제적 연계쌍에 집중된다.
- 결론
- I-O prior의 값은 예측 향상이 아니라 구조·해석 — 산업연관과 정합하는 더 간결한 계수. (원 논문의 "I-O가 적합도↑" 주장과 구별됨.)
I-O prior 설계
부문 매핑: 산업연관표(30부문)와 GDP(36산업)의 분류가 달라 매핑이 필요하다. 대부분 1:1이며, 건설(F)→4개·전력가스(D)→2개·정보통신(J)→2개는 같은 I-O 연계를 하위 산업에 복제한다(36/36 완료).
연계강도·차등화: 생산유발계수(Leontief 역행렬)로 산업쌍 연계강도 W를 만들고, 미네소타 교차항 사전분산을 × ω_ij로 차등한다:
연계 강한 쌍은 ω>1(느슨 → 계수 허용), 약한 쌍은 ω<1(→0으로 강수축). 총수축량은 미네소타와 맞추고(오프대각 평균 1) 배분만 차등한다.

두 prior 예측력 비교 (동일 test)
같은 방식(방정식별 Bayesian ridge)으로 미네소타·I-O 두 prior만 바꿔 추정하고, 동일 test 구간에서 확장창 예측 RMSE를 잰다. 아래 표와 그림 2는 같은 수치다.
| prior | 1단계 RMSE | 1년앞(4Q) RMSE | I-O 우세 산업 |
|---|---|---|---|
| 미네소타 | 4.507 | 4.565 | — |
| I-O prior | 4.533 | 4.555 | 1단계 18/36 · 1년 15/36 |

계수 구조 — I-O prior의 진짜 효과
예측은 대등해도 추정된 계수의 모양은 다르다. I-O prior는 연계 약한 산업쌍의 교차계수를 더 강하게 0으로 눌러, 계수를 더 희소하고 산업연관 구조에 정합하게 만든다(교차 |A₁| 평균 0.055 → 0.043).

수준 환산 — 10년 전망
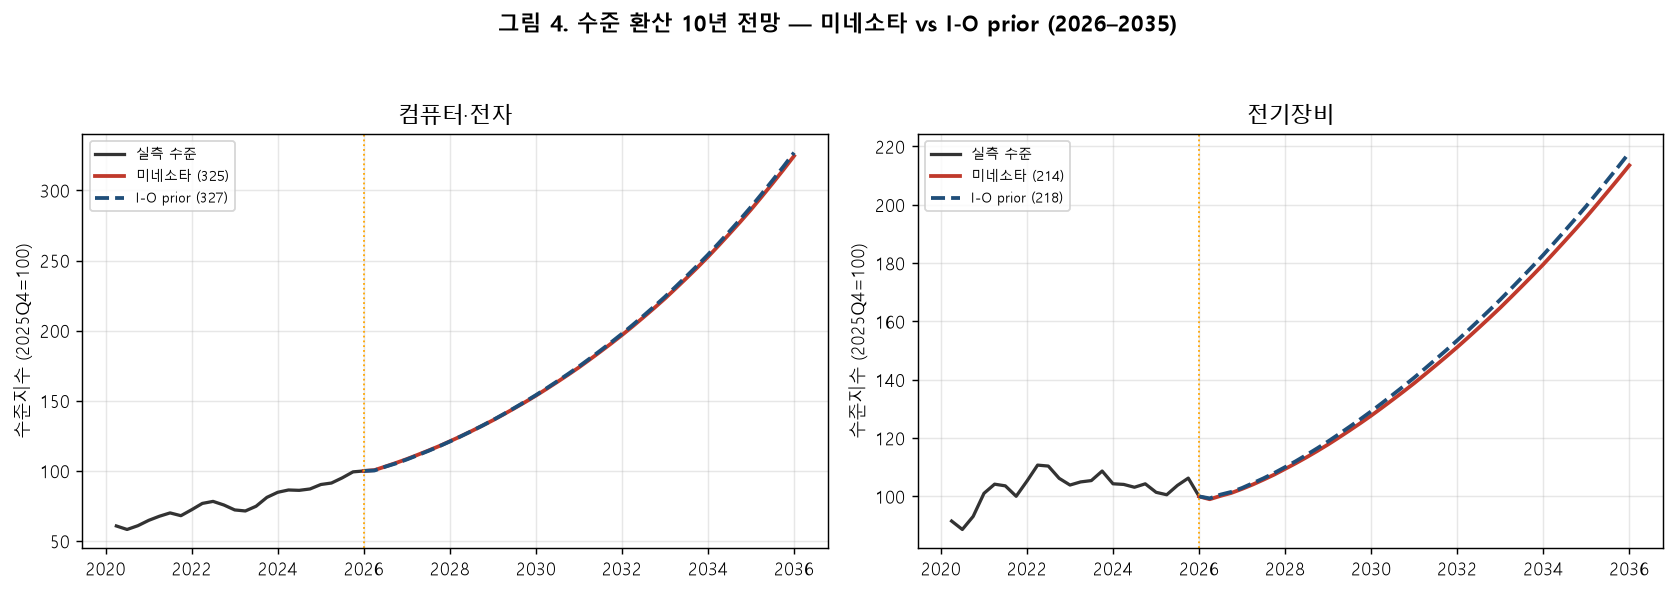
두 사전분포를 전 표본으로 재적합해 2026–2035년 40분기를 전망하고, 성장률을 누적해 수준지수(2025Q4=100)로 환산한다. 미네소타와 I-O prior의 수준 경로는 거의 겹친다 — 앞서 본 예측 대등성이 수준에서도 확인된다(I-O prior의 값은 구조·해석이지 예측이 아니다). 아래 표와 그림 4는 같은 수치.
| 사전분포 | 컴퓨터·전자 | 전기장비 |
|---|---|---|
| 미네소타 | 325 | 214 |
| I-O prior | 327 | 218 |
결론 · 다음
- I-O prior는 예측력은 미네소타와 대등하나, 계수를 더 희소·구조적으로 만들어 해석과 정합성을 높인다.
- 이는 원 논문이 말한 "산업연관표 사전정보가 적합도를 높인다"는 주장과 구별된다 — 그 적합도 개선은 (챕터 3의) 외생 거시블록에서 온다.
- 다음 챕터 3(BVARX): 유가·교역·금리·환율·노동을 외생변수로 결합해 시나리오 엔진을 만든다.
방법론 메모 · 모든 수치는 첨부 코드로 재현 가능 · 방정식별 Bayesian ridge, λ=0.1, 윈저화 ±30%.