제1절 왜 대안을 계산하는가
4장의 AI 확산 시나리오는 산업별 프리미엄을 기준 성장률에 직접 더한다(2장). 이 방식은 단순하고 투명하지만 두 가지 질문에 답하지 못한다. 첫째, 한 산업의 AI 효과가 산업 간 동학을 거쳐 다른 산업으로 퍼지면 결과가 어떻게 달라지는가. 둘째, 산업 배분을 설문 대신 특허·논문·뉴스 같은 객관 자료나 이전 전망으로 정하면 결과가 어떻게 달라지는가.
이 보론은 두 질문을 보고서1 산업모형(62분류 베이지언 VARX) 안에서 다룬다. 특허·논문·뉴스로 AI 확산 총량 지수와 업종별 AI 노출 지수를 만들고, AI 확산을 산업모형의 외생 항으로 넣는 두 대안을 계산한다. 4장의 전망과 기준 시나리오는 그대로 두며, 대안은 비교용이다. 모든 사양은 2035년 전산업 프리미엄을 Λ = 0.5%p로 맞추므로 사양 간 차이는 산업 간 배분과 파급에서만 생긴다.
제2절 AI 확산 총량 지수
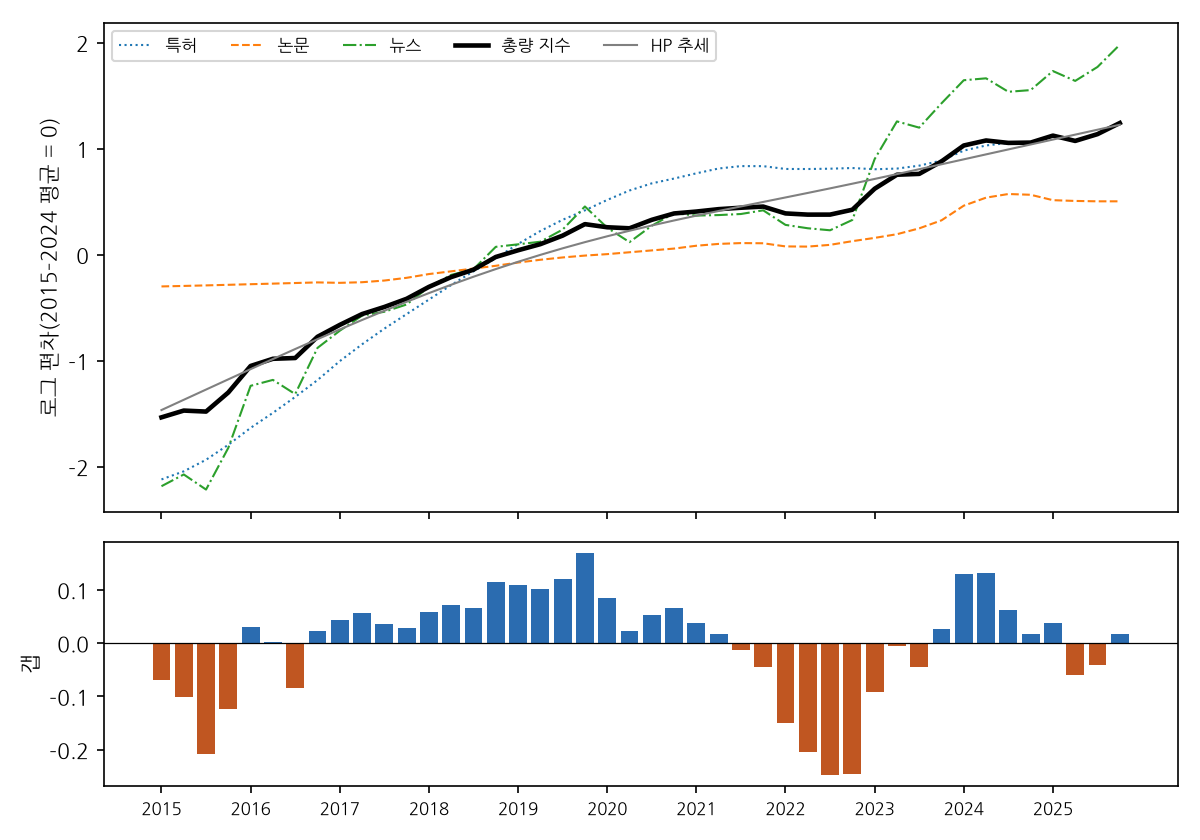
총량 지수는 세 자료원의 공통 흐름이다. 특허는 5개국(한국·미국·중국·일본·유럽) AI 핵심 분류(IPC G06N) 출원, 논문은 OpenAlex의 인공지능 개념 논문, 뉴스는 Event Registry의 영문 'artificial intelligence' 기사이다(1장과 같은 자료). 자료원마다 로그 수준에서 2015–2024년 평균을 빼고 분기로 맞춘 뒤 평균한다. 연간 자료인 특허·논문은 연 중앙에 로그 수준을 두고 분기로 보간하며, 특허는 공개 지연 때문에 2024년까지만 쓴다.
총량 지수는 2015년 1분기 −1.53에서 2025년 4분기 +1.24로 올라 10년 사이 약 16배가 되었다. 세 자료원의 분기 흐름은 서로 높게 상관된다(0.85–0.94). 총량 지수에서 HP 추세(평활 모수 1600)를 뺀 값을 AI 확산 갭이라 부른다. 추세보다 빨리 퍼진 시기(2019년 말, 2024년 상반기)는 양(+), 느린 시기(2022년)는 음(−)이다. 갭은 대안 2에서 과거 자료의 AI 변수로 쓴다.
제3절 업종별 AI 노출 지수
노출 지수는 설문 21개 업종마다 세 지표를 모은다.
| 지표 | 정의 | 자료 |
|---|---|---|
| 뉴스 | 2025년 업종 키워드 기사 중 'artificial intelligence'를 함께 다룬 비율 | Event Registry, 업종당 2회 조회 |
| 논문 | 2023–2025년 업종에 대응하는 학문 분야의 AI 논문 비중 | OpenAlex 분야별 집계 |
| 특허 | 업종 부가가치 1조 원당 AI 특허(G06N, 2020–2025년)의 동시분류 건수 | FindIP 정확 건수 |
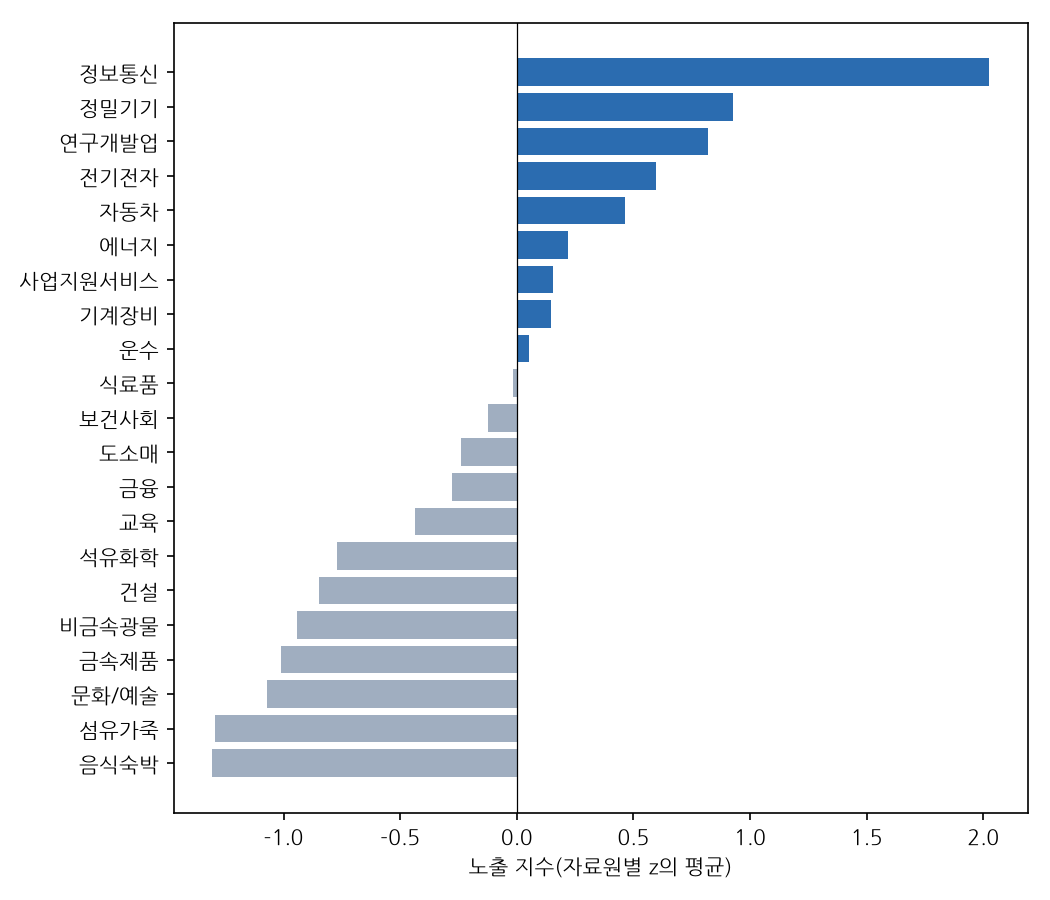
특허 지표는 G06N 특허가 함께 분류된 IPC를 업종에 대응시켜 센다. 집계 도구가 상위 20개 IPC만 돌려주므로, 그 밖의 IPC는 포함–배제 원리(|G06N ∩ X| = |G06N| + |X| − |G06N ∪ X|)로 정확히 구했다. 자료원마다 로그값을 업종 간 표준화하고 평균한다. 노출 지수는 정보통신(2.02)에서 가장 높고 음식숙박(−1.31)에서 가장 낮으며, 교육서비스는 −0.44로 중간 아래이다.
같은 질문에 대한 세 번째 자료로 한국고용정보원(2017)의 이전 인력수요 전망을 쓴다. 이 전망은 4차 산업혁명에 적극 대응하는 혁신전망과 기준전망의 산업별 부가가치 증가율을 함께 제시하였다. 두 전망의 차이를 업종별로 모으면 연구개발·정보통신·전기전자에서 크고 교육서비스에서 0에 가깝다. 전 산업 차이는 연 0.47%p로, Λ 중심값과 가깝다(2장).
[표 1] 세 자료의 업종 순위상관(21개 업종)
| 설문 E4-1 | 객관 노출 지수 | 한국고용정보원(2017) | |
|---|---|---|---|
| 설문 E4-1 | 1 | 0.49 | 0.05 |
| 객관 노출 지수 | 0.49 | 1 | 0.61 |
| 한국고용정보원(2017) | 0.05 | 0.61 | 1 |
세 자료는 정보통신·전기전자가 AI의 영향을 크게 받는다는 점에서 같다. 그러나 설문과 이전 전망의 업종 순위는 거의 무관하고, 객관 노출 지수는 두 자료와 모두 중간 정도로 상관된다. 가장 크게 어긋나는 업종은 교육서비스로, 사업체들은 AI의 영향이 크다고 답했지만 특허·논문·뉴스와 이전 전망에서는 작다. 설문은 인식이고, 객관 지표는 기술 공급과 관심의 크기이며, 이전 전망은 생성형 AI 이전의 모형 결과라는 성격 차이가 있다. 어느 하나가 정답이라기보다 배분의 불확실성이 크다는 증거로 읽는다.
제4절 대안 1 — 기존 계수를 고정하고 AI 항을 더하기
보고서1 산업모형의 계수는 그대로 두고, AI 확산 시나리오에서만 산업별 AI 항을 더한다. 기준 시나리오에서는 이 항이 0이므로 기존 전망은 정의상 바뀌지 않는다. AI 효과는 산업모형의 동학을 따라 다른 산업으로 퍼진다.
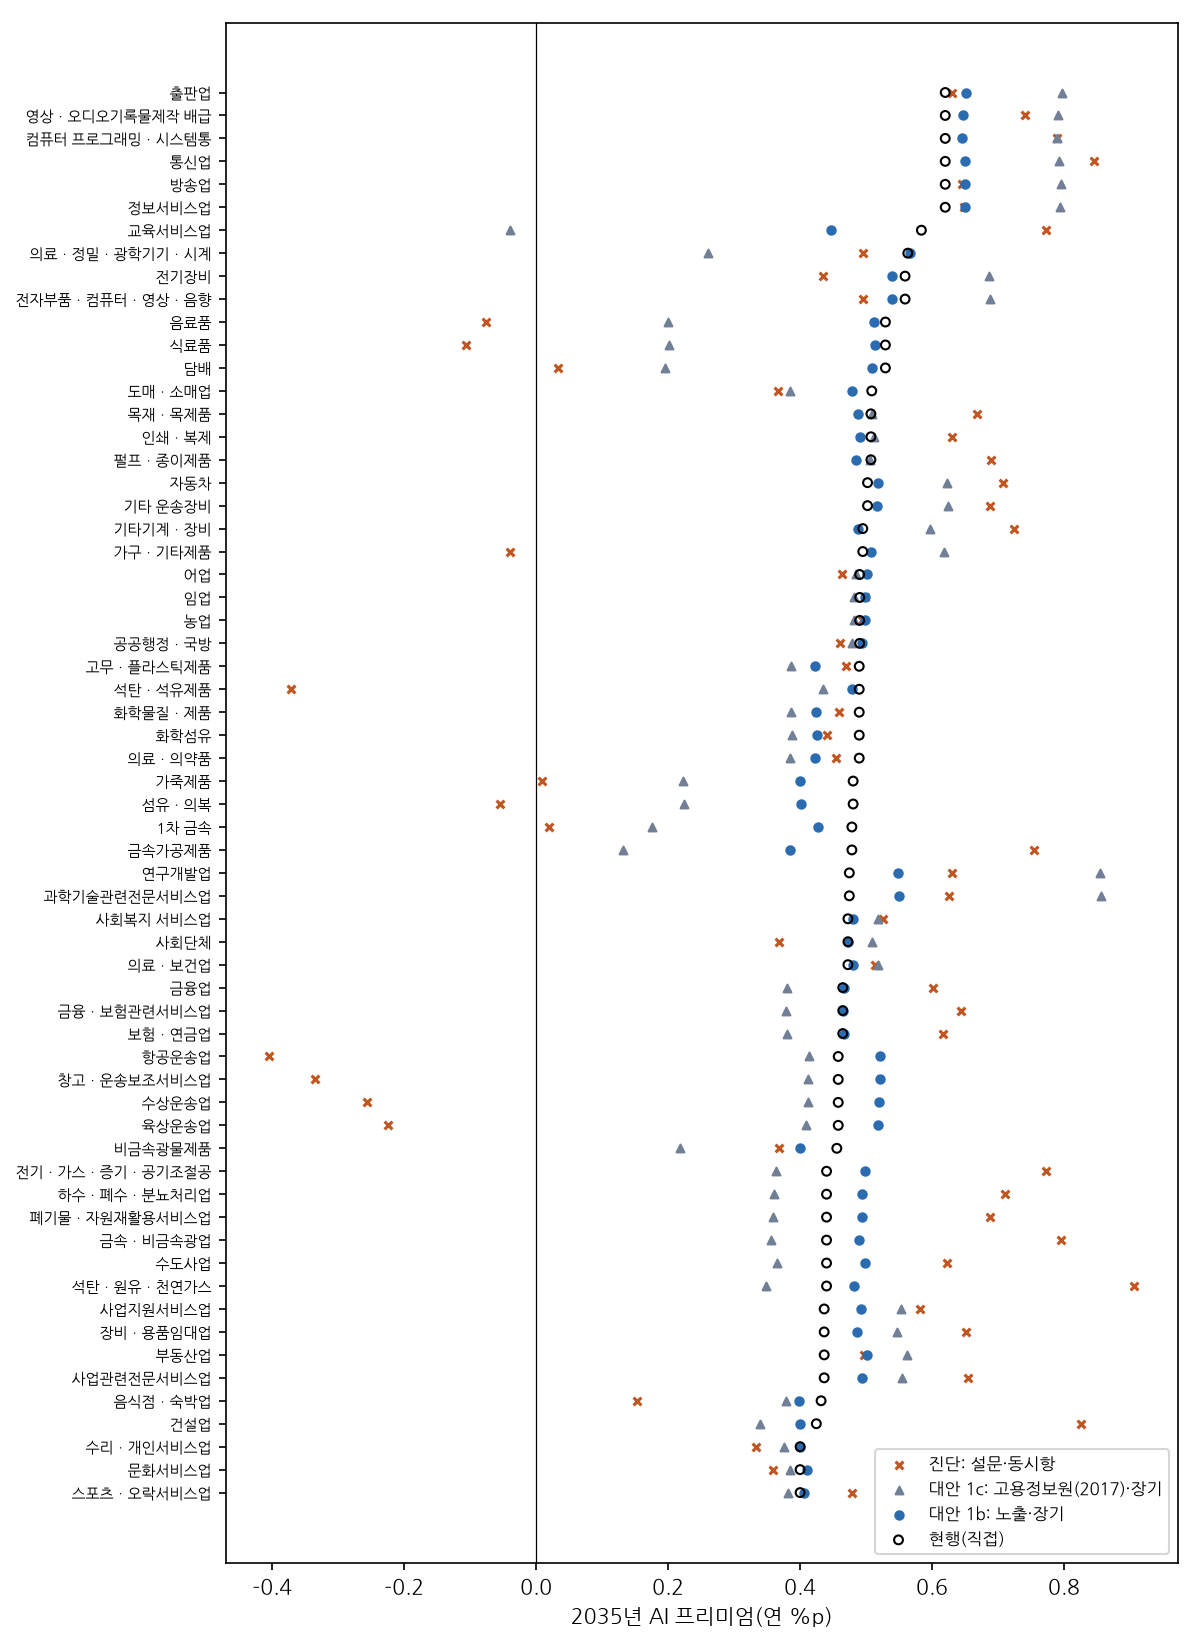
설문 E4-1은 2040년까지 AI가 매출에 미칠 누적 영향을 묻는다. 그래서 설문 정보는 AI 항의 당기 계수가 아니라 모형의 장기 반응에 둔다. 즉 산업모형의 동학을 거친 뒤의 장기 효과가 설문의 업종 배분과 같아지도록 당기 계수를 정한다. 배분 자료에 따라 세 사양을 계산하였다. 1a는 설문, 1b는 객관 노출 지수, 1c는 한국고용정보원(2017) 혁신전망이다. 1b는 객관 지표의 업종 간 차이가 설문보다 훨씬 크므로(정보통신의 특허 밀도는 다른 업종의 수십 배), 설문 배분의 평균과 산업 간 표준편차는 유지하고 순위와 간격만 노출 지수로 바꾸었다. 1c는 이미 증가율 차이(%p)이므로 그대로 쓴다.
[표 2] 사양별 AI 확산 효과(2035년 프리미엄 Λ = 0.5%p, 2025–2035년)
| 사양 | 산업모형 계수 | 배분 자료 | 연평균 차이(%p) | 산업 프리미엄 범위(%p) | 음(−)인 산업 | 기존 전망 |
|---|---|---|---|---|---|---|
| 현행(4장) | — | 설문 | 0.32 | 0.40 ~ 0.62 | 0 | — |
| 대안 1a | 고정 | 설문 | 0.31 | 0.39 ~ 0.62 | 0 | 변화 없음 |
| 대안 1b | 고정 | 객관 노출 지수 | 0.31 | 0.38 ~ 0.65 | 0 | 변화 없음 |
| 대안 1c | 고정 | 한국고용정보원(2017) | 0.31 | −0.04 ~ 0.86 | 1 | 변화 없음 |
| 대안 2 | 재추정 | 설문(사후분포) | 0.31 | 0.39 ~ 0.62 | 0 | 산업별 −0.30 ~ +0.86% |
대안 1a의 산업별 프리미엄은 현행과 최대 0.05%p 다르다. 장기 효과를 설문에 맞추면 산업모형의 동학은 효과가 나타나는 속도만 조금 늦출 뿐이어서, 연평균 차이가 0.32%p에서 0.31%p로 낮아진다. 현행 방식은 산업모형 안에서도 같은 결과를 주는 셈이다.
배분 자료를 바꾸면 결과가 달라진다. 1b에서는 교육서비스의 프리미엄이 현행보다 0.14%p 낮아지고 연구개발·과학기술서비스가 높아진다. 1c에서는 범위가 −0.04%p(교육서비스)에서 0.86%p(과학기술서비스)까지 넓어지고, 연구개발도 0.85%p이다. 전산업 효과가 같아도 산업별 프리미엄은 배분 자료에 따라 크게 다를 수 있으므로, 인력 수요를 산업별로 쓸 때는 1b·1c를 배분의 민감도로 함께 보는 것이 좋다.
제5절 진단 — 설문 배분을 당기 계수에 그대로 넣으면
설문 배분을 AI 항의 당기 계수에 그대로 넣고 산업모형의 동학이 효과를 퍼뜨리게 두면, 전산업 효과는 0.31%p로 같지만 9개 산업의 프리미엄이 음(−)이 된다. 항공운송(−0.40%p), 석탄·석유제품, 창고·운송보조, 수상·육상운송, 식료품이 그렇다. 반대로 석탄·원유·천연가스, 통신, 건설은 0.8–0.9%p로 높아진다.
원인은 산업모형의 교차 시차계수이다. 이 계수는 분기 성장률 사이의 단기 공행을 요약한 축약형 계수이며, 공급망 관계를 나타내지 않는다. 교차계수 합의 46%가 음(−)이고, 이 비율은 산업연관 연계가 강한 산업 쌍에서도 낮아지지 않는다. 영구적인 효과의 장기 파급으로 나누어 보면 10개 산업의 장기 효과가 음(−)이며, 가장 크게 끌어내리는 파급원은 부동산업(5개 산업)과 공공행정·국방(5개 산업)이다. 두 산업은 성장률이 매끄럽고 경기와 반대로 움직이는 경향이 있어, 단기 공행에서는 운수·석유 같은 경기 민감 산업과 음(−)으로 묶인다. 이런 단기 관계를 AI 같은 영구적인 생산성 효과의 전파 경로로 읽을 근거는 없다. 대안 1을 장기 반응 기준으로 정한 이유이다.
제6절 대안 2 — AI 확산 갭을 일곱째 외생으로 넣어 다시 추정하기
과거 AI 확산 갭(2015년 이전은 0)을 일곱째 외생변수로 넣어 산업모형을 다시 추정한다. AI 계수의 사전분포는 설문 배분에 비례하는 평균과 설문 표본오차에 비례하는 폭을 갖는다. 평균의 공통 척도 β는 자료로 정한다(경험적 베이즈). 자료가 설명하지 못하는 산업별 차이를 따로 두는 계층 사전분포도 함께 계산하였다.
먼저 자료만으로 무엇을 알 수 있는지 보았다. AI 계수에 정보가 없는 사전분포를 두면 62개 산업 가운데 5% 수준에서 유의한 계수는 1개로, 우연히 기대되는 수(3.1개)보다 적다. 설문 배분에 맞춘 공통 척도 β는 0.08(t = 0.90)이며, 설문으로 설명되지 않는 산업별 차이의 분산은 0으로 추정된다. 따라서 두 사전분포의 결과가 같고, 사후평균에서 자료가 차지하는 비중은 0.1% 미만이다. AI 확산이 본격화된 기간이 표본 끝 몇 해뿐이고 같은 시기에 코로나19 충격이 겹쳐, 과거 자료로는 산업별 AI 효과를 식별할 수 없다. 범용 기술의 생산성 효과가 늦게 나타난다는 문헌(Brynjolfsson, Rock, & Syverson, 2021)과 같은 방향이다.
재추정은 기존 전망을 조금 바꾼다. 미래 AI 갭을 0으로 둔 기준 시나리오에서 바텀업 합계는 2035년 0.26% 낮아지고, 5장과 같은 비례 벤치마킹을 거친 뒤 산업별 변화는 −0.30%(석탄·원유·천연가스)에서 +0.86%(석탄·석유제품) 사이이다. 사전분포가 AI 항으로 과거 성장의 일부를 설명하게 하므로 다른 계수가 그만큼 조정되기 때문이다. 설문 배분이 높은 교육·통신은 조금 낮아지고 운수·석유제품은 조금 높아진다. AI 확산 시나리오의 효과는 대안 1a와 같다(연 0.31%p).
제7절 해석과 활용
- 중심 전망은 4장을 유지한다. 산업모형 안에서 장기 효과를 설문에 맞추면(대안 1a) 4장과 사실상 같은 결과가 나온다. 과거 자료는 AI 계수에 대해 정보를 주지 못하므로(대안 2) 재추정으로 얻는 것이 없고, 기존 전망만 조금 흔들린다.
- 산업 간 파급은 축약형 동학으로 읽지 않는다. 단기 공행을 영구 효과의 전파로 쓰면 경제적으로 설명하기 어려운 음(−)의 효과가 생긴다(제5절). 산업 간 파급을 다루려면 산업연관표의 투입 구조처럼 구조적 경로를 써야 한다.
- 배분의 불확실성을 함께 제시한다. 설문·객관 지표·이전 전망의 업종 순위가 크게 다르므로(표 1), 산업별 인력 수요를 해석할 때 1b·1c를 민감도로 쓴다. 특히 교육서비스의 프리미엄은 자료에 따라 0.58%p에서 0에 가깝게까지 달라진다.
- AI 확산 총량 지수는 감시 지표로 쓴다. 지수의 추세 대비 위치(갭)는 AI 확산이 기준보다 빠른지를 분기마다 보여 준다. 표본이 쌓이면 대안 2를 다시 추정해 자료가 사전분포를 얼마나 고치는지 점검할 수 있다.
참고문헌
- Bańbura, M., Giannone, D., & Reichlin, L. (2010). Large Bayesian vector auto regressions. Journal of Applied Econometrics, 25(1), 71–92. https://doi.org/10.1002/jae.1137
- Brynjolfsson, E., Rock, D., & Syverson, C. (2021). The productivity J-curve: How intangibles complement general purpose technologies. American Economic Journal: Macroeconomics, 13(1), 333–372. https://doi.org/10.1257/mac.20180386
- Hamilton, J. D. (2018). Why you should never use the Hodrick-Prescott filter. Review of Economics and Statistics, 100(5), 831–843. https://doi.org/10.1162/rest_a_00706
- Hodrick, R. J., & Prescott, E. C. (1997). Postwar U.S. business cycles: An empirical investigation. Journal of Money, Credit and Banking, 29(1), 1–16. https://doi.org/10.2307/2953682
- Leban, G., Fortuna, B., Brank, J., & Grobelnik, M. (2014). Event Registry: Learning about world events from news. In Proceedings of the 23rd International Conference on World Wide Web (pp. 107–110). https://doi.org/10.1145/2567948.2577024
- Morris, C. N. (1983). Parametric empirical Bayes inference: Theory and applications. Journal of the American Statistical Association, 78(381), 47–55. https://doi.org/10.1080/01621459.1983.10477920
- Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts (arXiv:2205.01833). https://doi.org/10.48550/arXiv.2205.01833
- 한국고용정보원. (2017). 기술혁신을 반영한 중장기 인력수요 전망 2016~2030. 한국고용정보원.
- 한국고용정보원. (2026). AI 수용도가 고용변화에 미치는 영향: 사업체 조사 통계표(2026-04-17 검토본). 과제 참여기관 공유자료.
자세히 보기
이 장에 속한 포털 페이지 2개
재현 패키지
특허·논문·뉴스 스냅샷과 이 장에서 조회한 업종별 노출 자료(Event Registry·OpenAlex·FindIP 포함–배제), 한국고용정보원(2017) 혁신 시나리오 인쇄값으로 총량 지수·노출 지수를 만들고, 보고서1 산업모형을 다시 적합해 대안 1(1a·1b·1c)·진단·대안 2를 계산한다. 검증 셀이 본문 수치 40개와 4장 결과·보고서1 5장 바텀업 합계를 대조한다.
필요한 것: AI 수용도조사 통계표·원자료(비공개, 과제 참여기관 공유자료) · 재조회 시 EVENTREGISTRY_API_KEY(환경변수), OpenAlex는 키 없이 가능 · FindIP는 MCP 전용 — 조회 기록으로 재현
R 사용: R은 쓰지 않는다.
실행: pip install -r requirements.txt 후 python run_all.py. 마지막 노트북의 검증 셀이 원고 수치와 대조하며, 다르면 실행이 멈춘다.
입수
분석
- ipynb02_분석.ipynb총량 지수·HP 갭, 노출 지수·세 자료 순위상관, 보고서1 모형 적합, 대안 1a·1b·1c(장기 반응 기준), 당기 계수 진단과 파급 분해, 대안 2 경험적 베이즈·기존 전망 변화실행 결과 보기.ipynb
- pysrc/ai_index.py총량 지수·HP 갭·노출 지수파일
- pysrc/ai_varx.pyAI 항 전파·Λ 보정·장기 반응·파급 분해·재추정·경험적 베이즈파일
- pysrc/alt_run.py사양별 계산 묶음(노트북이 부르는 함수)파일
- pysrc/keis_prior.py한국고용정보원(2017) 혁신 시나리오 집계파일
- pysrc/varx_engine.py산업모형 엔진(보고서1 5장 패키지와 같은 파일)파일
묶음 파일 87개와 SHA-256
| 01_입수.ipynb | bde1c2a8c2390a13… |
| 02_분석.ipynb | 47a579fd78385964… |
| 03_결과.ipynb | e67ca2e619fce436… |
| README.md | a96e8ddc9854123e… |
| config.py | ced8603b014a6766… |
| data/crosswalk_21_62.csv | b8a95a20ae3be18c… |
| data/inputs/EVENTREGISTRY_QUERY.md | 95171d124f9bd6ed… |
| data/inputs/FINDIP_QUERY.md | 558b0617d22c2ec7… |
| data/inputs/PROVENANCE.md | 994a6988f33242f0… |
| data/inputs/RETRIEVED_AT.txt | 98da4d51b216984d… |
| data/inputs/base_va_62.csv | 81c0a99e7e67aad3… |
| data/inputs/eventregistry_ai_eng_daily.csv | edaf04ea090e175f… |
| data/inputs/eventregistry_ai_eng_daily_2014.csv | 19bb40a0aefe0d60… |
| data/inputs/eventregistry_industry_ai_share_2025.csv | 6e105511bea37791… |
| data/inputs/eventregistry_industry_panel_2014_2025.csv | 153edb4cdc544956… |
| data/inputs/exog_hist_v2.csv | d142ff2992b5ae3e… |
| data/inputs/exog_scen_v2.csv | f45f8007d7b88faf… |
| data/inputs/findip_g06n_by_year.csv | f6e79f9f95ebec5b… |
| data/inputs/findip_g06n_by_year_2000_2025.csv | 4000a938382d3881… |
| data/inputs/findip_g06n_coipc_5c_2020_2025.csv | f327ecb7e4d97dfe… |
| data/inputs/findip_g06n_coipc_supplement_2020_2025.csv | 59db0c342111bbb4… |
| data/inputs/findip_g06n_coipc_top20_by_period_2000_2025.csv | b474a71b4356f5de… |
| data/inputs/findip_industry69_by_year_2000_2024.csv | 59e408d5f6209351… |
| data/inputs/io_linkage_62.csv | 3f747a97c3804541… |
| data/inputs/keis_r14_va_scenarios.csv | 6f1ce507eb886c63… |
| data/inputs/levels_62.csv | 00469e892aac4742… |
| data/inputs/openalex_by_year.csv | 19811d9fa29793f3… |
| data/inputs/openalex_by_year_2000_2025.csv | 3e5104f14483a4c6… |
| data/inputs/openalex_field_ai_by_year_2000_2025.csv | e60d07d845b7c66c… |
| data/inputs/openalex_field_ai_share_2023_2025.csv | f14368ff7d0da4ab… |
| data/inputs/openalex_industry69_by_year_2000_2025.csv | 3ebf7a2021dc39c3… |
| data/map_ipc_to_survey21.csv | d3ac4755c89b8722… |
| data/map_keis11_to_survey21.csv | 7549ba5f4f173087… |
| data/map_openalex_field_to_survey21.csv | 272688feebc4d1b1… |
| data/naver_queries_69.csv | 49e57b3b0dc2fb26… |
| data/openalex_queries_69.csv | d8420041b3368a98… |
| data/patent_ipc_69.csv | 284a119242c9eb1f… |
| data/private/README.txt | fc614a643a645b74… |
| data/survey21_short_names.csv | b1640a05917d76c4… |
| output/ai_exposure_21.csv | 3ad90d9c5b50f9fe… |
| output/ai_index_quarterly.csv | 7b9ff400a17172c9… |
| output/alt2_baseline_change.csv | a38b00e458614845… |
| output/alt2_baseline_change_62.csv | b8baf031300dc905… |
| output/alt2_diagnostics.csv | 4bbfffc4034a3034… |
| output/exposure_rank_corr.csv | 082f9f5a88ad4fee… |
| output/fig1_ai_index.png | 35f70d8a4256467b… |
| output/fig2_exposure.png | 7b6bc9fcd44b046d… |
| output/fig3_premium_variants.png | d041edb6d60db4d0… |
| output/industry69/ai_index_quarterly.json | d69270e64fae8133… |
| output/industry69/papers_share_62.csv | 9e5e4b3e49fbb777… |
| output/industry69/papers_share_69.csv | c1716239e39afee0… |
| output/industry69/patents_share_62.csv | 27cd1519d3d6f3ab… |
| output/industry69/patents_share_69.csv | da90d403920304bb… |
| output/keis_r14_dva_21.csv | a6368c8dbe613bf5… |
| output/keis_r14_total.csv | 29ba5973f1fda425… |
| output/model_check.csv | 238529f7a05c6fd8… |
| output/paths_total_variants.csv | a45dff5390e149ea… |
| output/premium_62_variants.csv | 148eec229d5c1b32… |
| output/run_log.txt | 7dd9a439b0c87f8b… |
| output/spillover_diag.csv | 0e34fc6b961b98e3… |
| output/summary_variants.csv | 0966b70c1abc7ff8… |
| output/table1_variants.csv | 1f50d1c5750db8fd… |
| output/table2_baseline_change.csv | 4d92fa52cd8bb859… |
| output/table3_premium_diff.csv | 26691993594711cd… |
| output/triangulation_rank_corr.csv | 2bc3c54aa00a0064… |
| output/verification.csv | 7d97ecfcb9639e23… |
| requirements.txt | e3c3dd0bed2964ad… |
| run_all.py | 2a5dbd80df3b2248… |
| src/ai_forecast.py | 093841adc3e0d764… |
| src/ai_index.py | 809d6aa37436f7ab… |
| src/ai_index_quarterly.py | 4ad22202517e6ebe… |
| src/ai_industry69.py | a446cf46d0318905… |
| src/ai_panel.py | b4725fd9fd2ab15f… |
| src/ai_varx.py | 24a2e83c445610f7… |
| src/alt_run.py | 0630bf156266266e… |
| src/fetch.py | 662b5339b955e883… |
| src/keis_prior.py | 5ade1769d6028e40… |
| src/naver_backfill_est.py | a32b2f933239d8c3… |
| src/naver_collect.py | 5e7c91f15f04ba4f… |
| src/naver_filter.py | ec163788685d7695… |
| src/naver_industry.py | a77171fc2283820a… |
| src/naver_news.py | 012959172f8c406f… |
| src/naver_sample_quarter.py | 8f877c0e08ed6230… |
| src/varx_engine.py | 322c2d283b64e71a… |
| tools/ai_index_review_template.html | f500a93e3dcb6ee7… |
| tools/findip_industry69_record.py | b5da3e2b354977e0… |
| tools/make_ai_index_review.py | 76cfe68b52463abb… |