한국은행 동태예측모형 · BOKDPM
추정, 그림으로 읽기
관측 데이터에서 보이지 않는 파라미터를 알아내는 전 과정을, 상태공간에서 시작하여 칼만필터와 베이지언 MCMC까지 순서대로 정리한다. 각 장면은 한 장의 그림과 짧은 설명으로 이루어진다.
무엇을 하려는가. 우리가 가진 것은 2000–2025년의 관측 데이터 20개(GDP·물가·금리 등)이다. 알고자 하는 것은 모형의 파라미터 54개(행태계수 20 + 충격 표준편차 34)와, 직접 관측되지 않는 잠재상태들이다. 그 다리를 놓는 절차가 아래 아홉 장면이다.
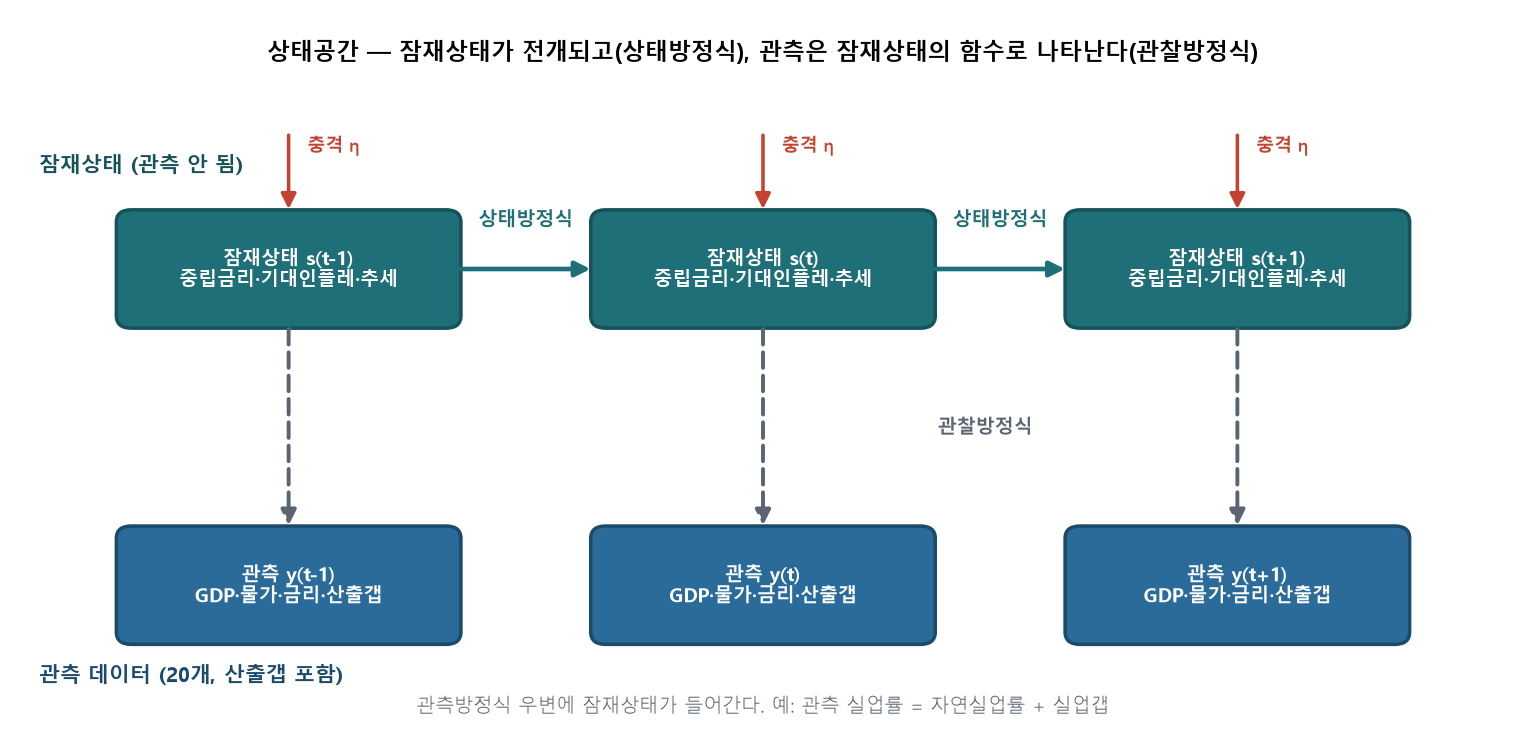
모형은 두 방정식으로 구성된다. 상태방정식은 관측되지 않는 잠재상태(중립금리·기대인플레이션·추세 등)가 시간에 따라 전개되는 규칙이고, 관찰방정식은 관측 데이터 20개를 잠재상태의 함수로 연결한다. 산출갭은 미리 측정되어 관측에 포함된다.
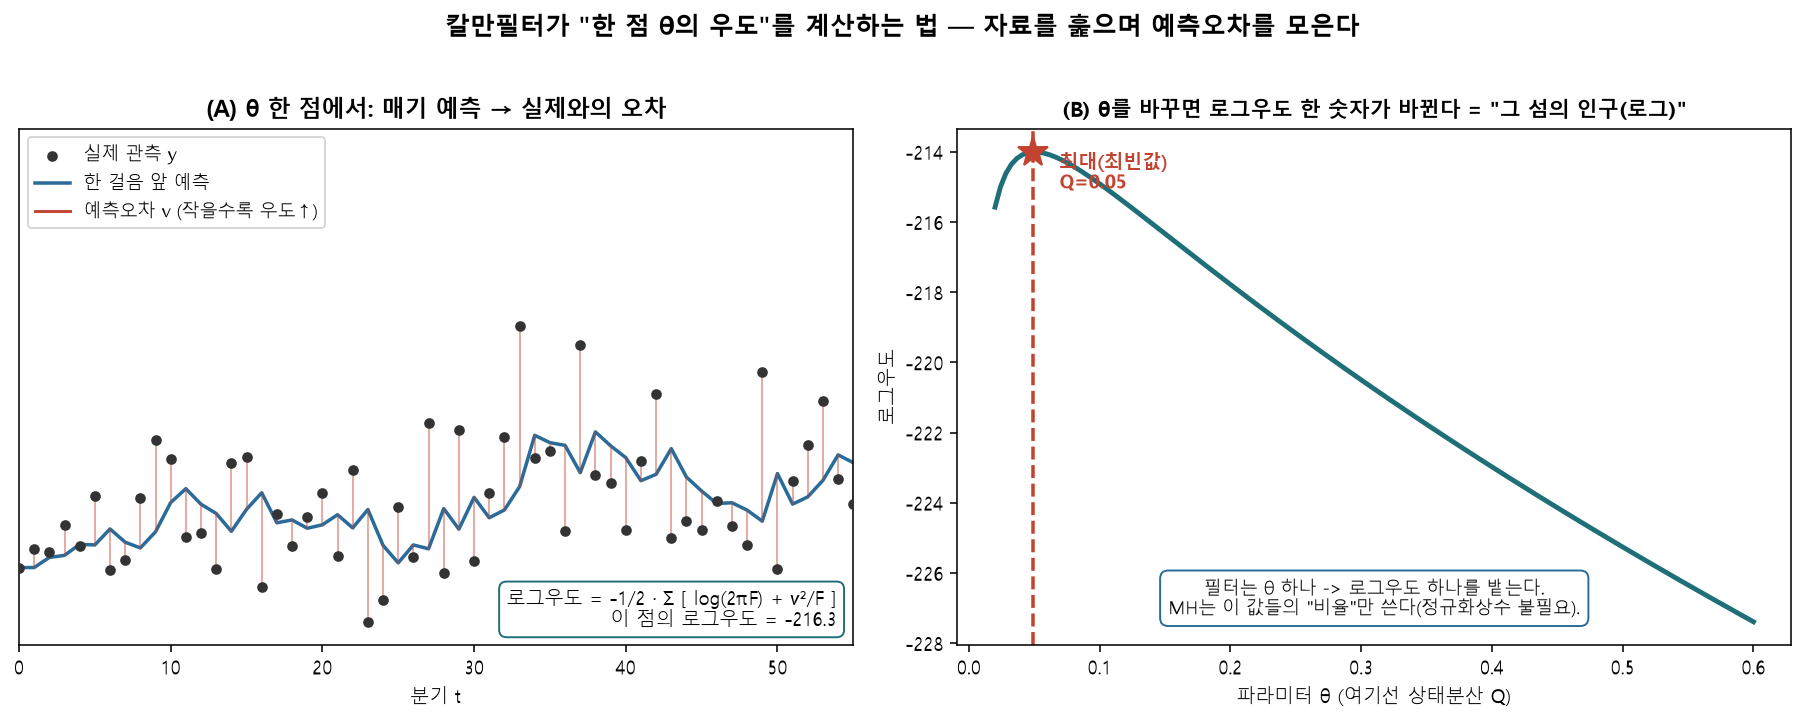
파라미터 한 벌을 넣으면, 칼만필터가 자료를 처음부터 끝까지 통과하며 매 분기 관측값을 예측하고 실제와의 예측오차를 모아 로그우도 한 값을 만든다. 예측오차가 작을수록 우도가 크다. 파라미터를 바꾸면 이 값이 바뀐다.
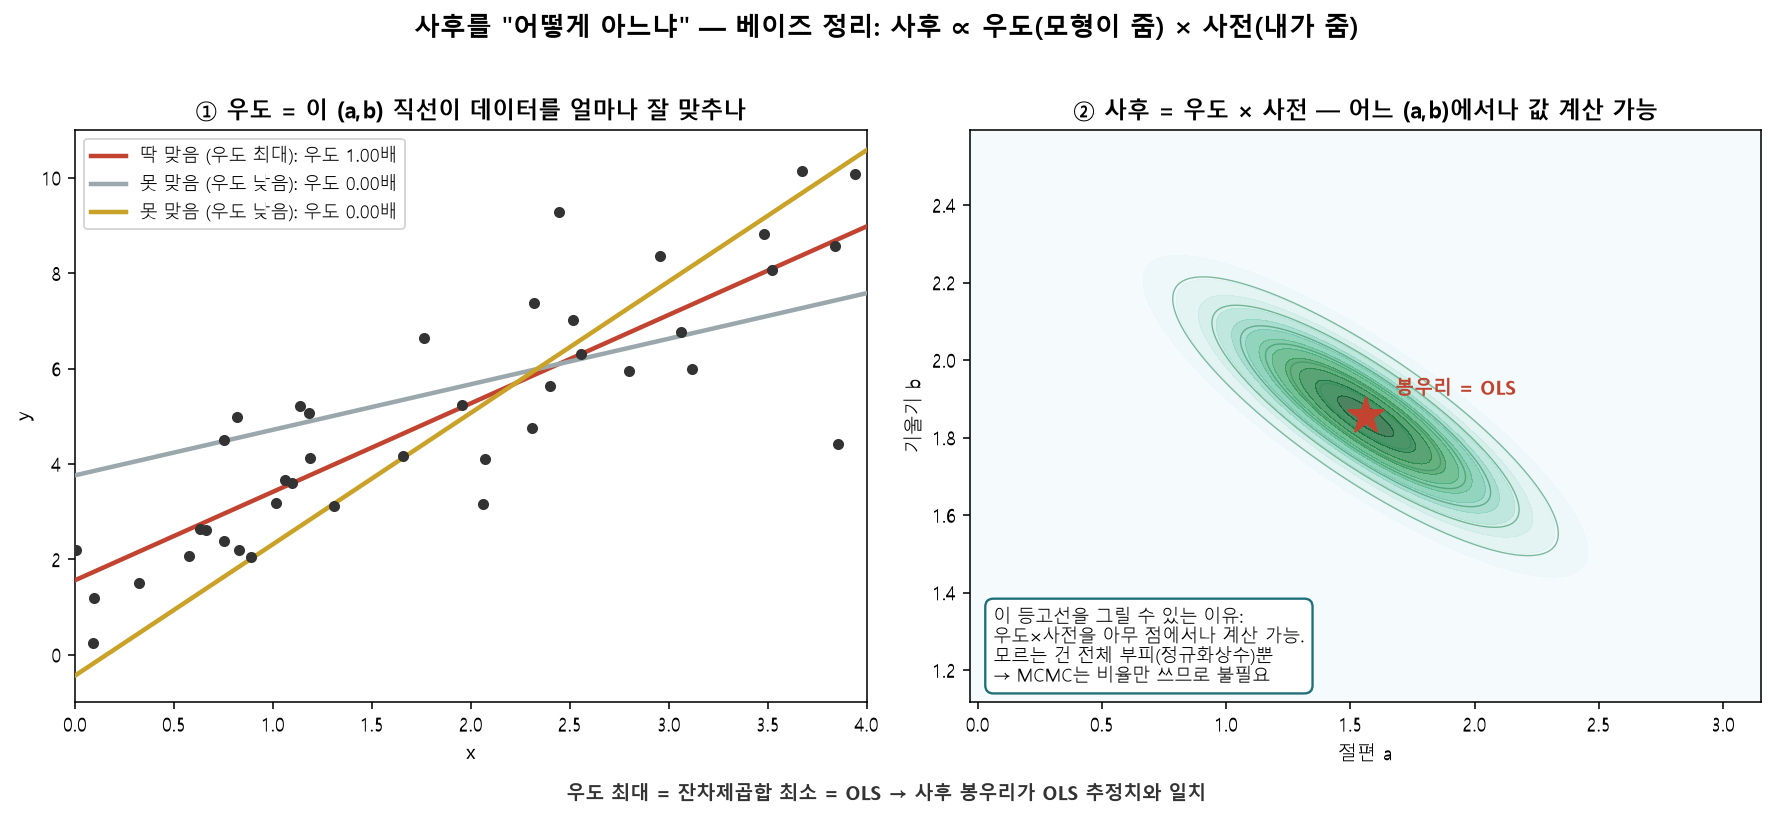
베이즈 정리에 따라 사후는 우도(모형이 정한 형태)와 사전(분석자가 정한 믿음)의 곱에 비례한다. 어느 파라미터 값에서나 이 곱은 계산할 수 있다. 모르는 것은 전체를 1로 만드는 정규화상수뿐이며, 이후 방법들은 그 상수를 필요로 하지 않는다.
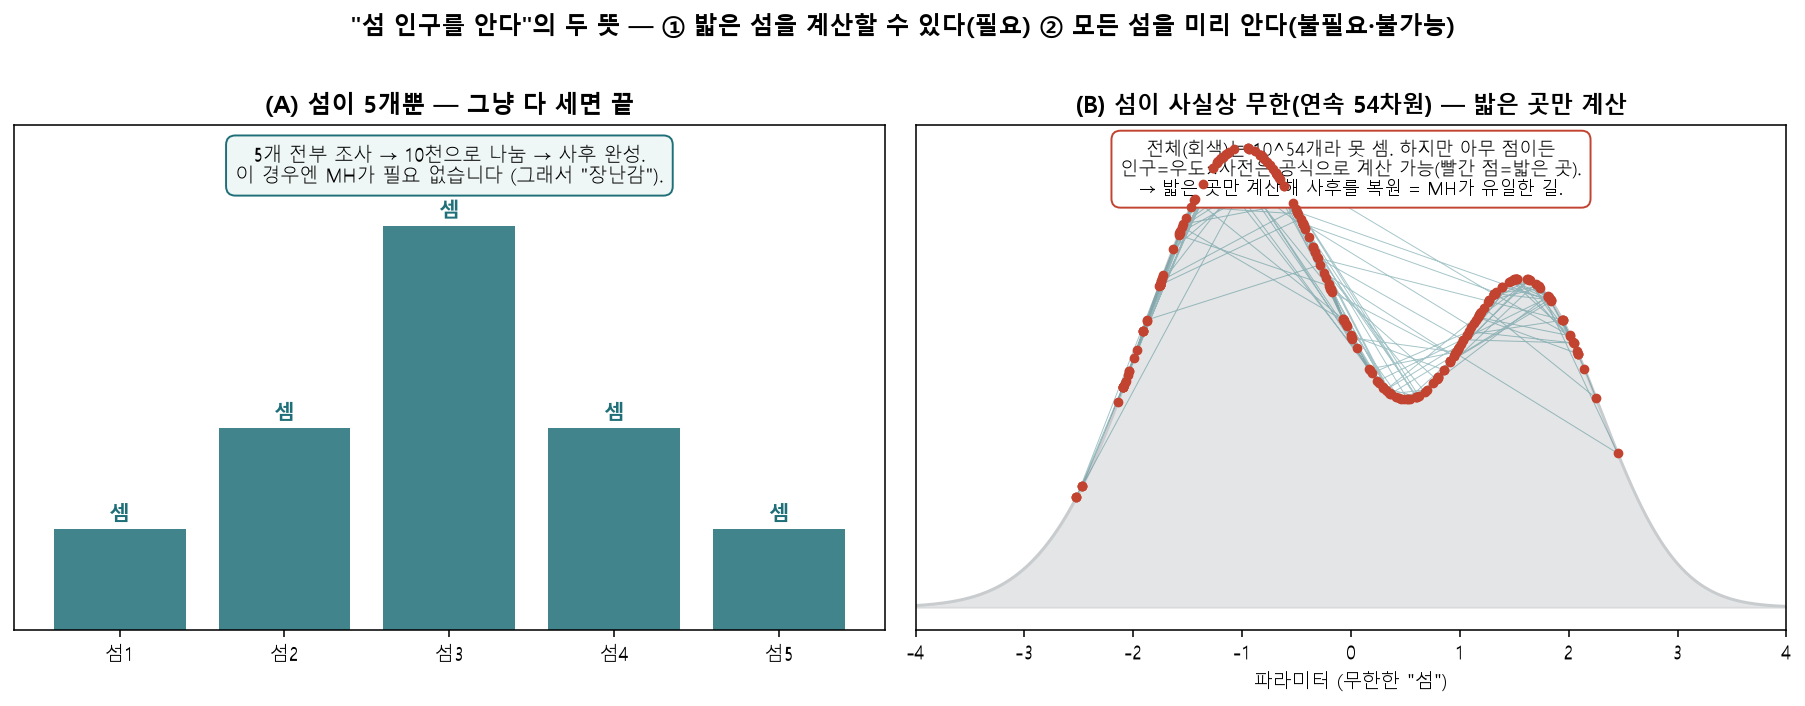
파라미터가 적으면 격자로 전부 계산하거나 공식으로 직접 표본을 얻을 수 있다. 그러나 파라미터가 54개로 늘면 격자는 계산량이 폭증하고 직접 표집도 불가능하다. 각 점의 값은 계산되지만, 전체를 다 셀 수는 없다.
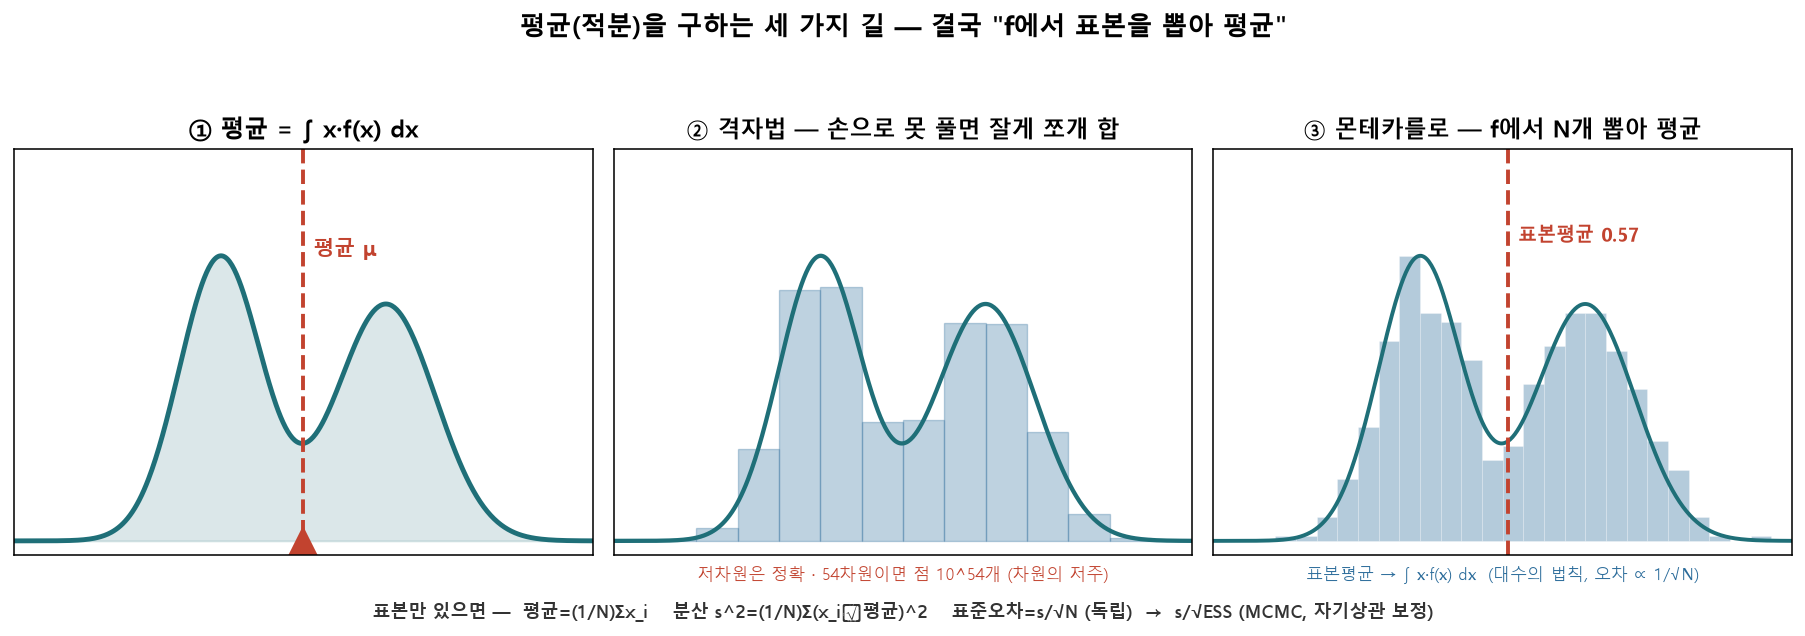
평균·분산 같은 값은 모두 적분이다. 적분을 손으로 풀 수 없을 때는, 분포에서 표본을 충분히 추출하여 그 표본의 평균으로 적분을 대신한다. 표본만 있으면 평균·분산·구간을 모두 계산할 수 있다.
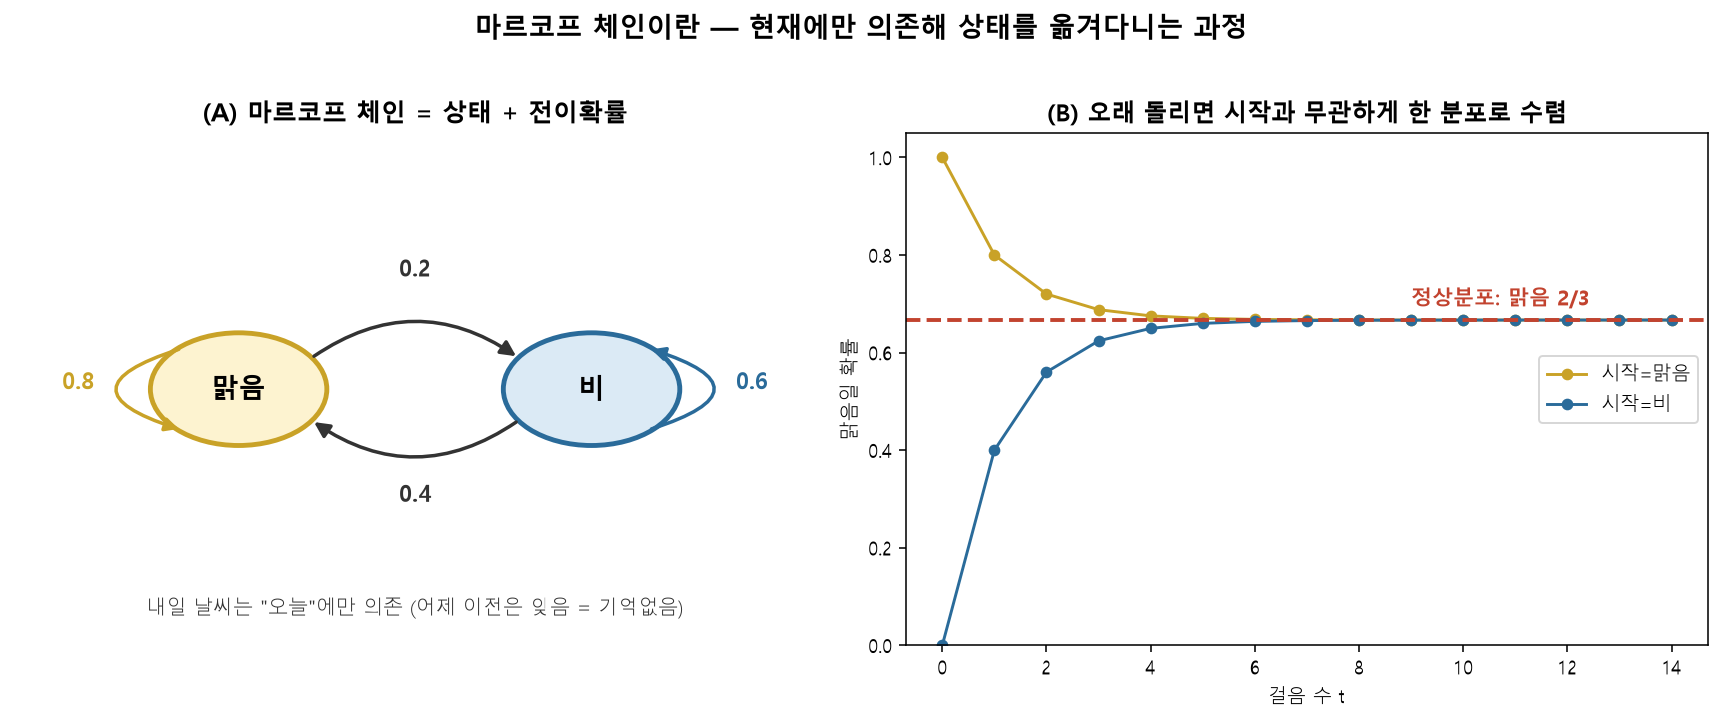
마르코프 체인은 다음 상태가 현재 상태에만 의존하는 과정이다. 전이규칙을 오래 반복하면, 시작점과 무관하게 각 상태의 방문 비율이 하나의 고정된 분포(정상분포)로 수렴한다. 이 성질을 이용해, 정상분포가 사후가 되도록 규칙을 설계한다.
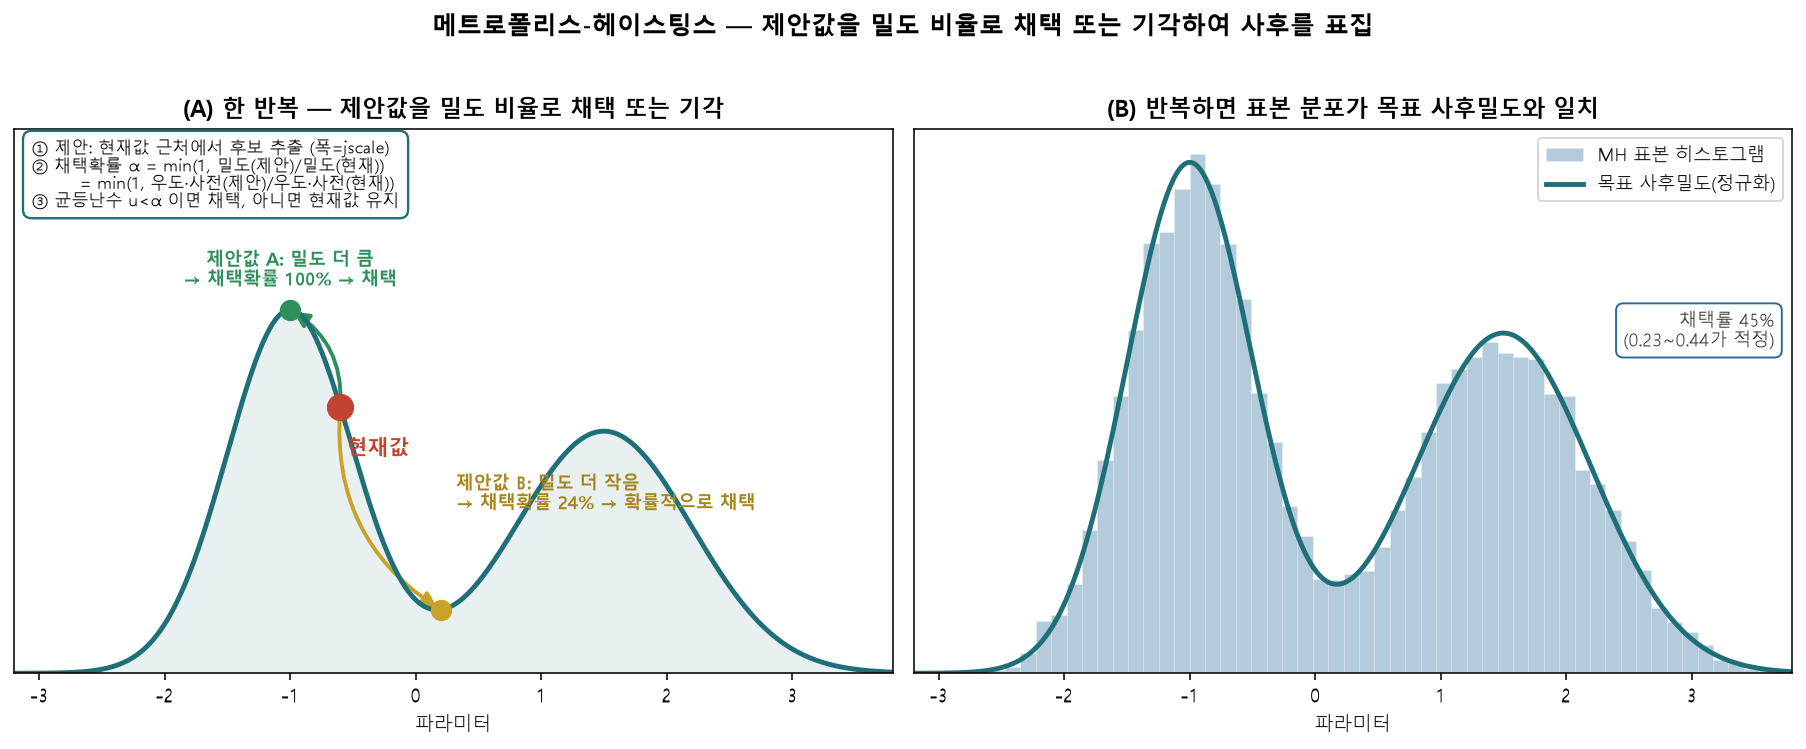
사후를 정상분포로 갖도록 만든 규칙이다. 현재값 근처에서 제안값을 추출하고, 두 값의 밀도 비율로 채택 여부를 정한다(밀도가 더 크면 채택, 작으면 확률적으로 채택). 비율에서 정규화상수가 소거되므로 우도×사전만으로 표집할 수 있고, 반복하면 표본 분포가 사후와 일치한다.
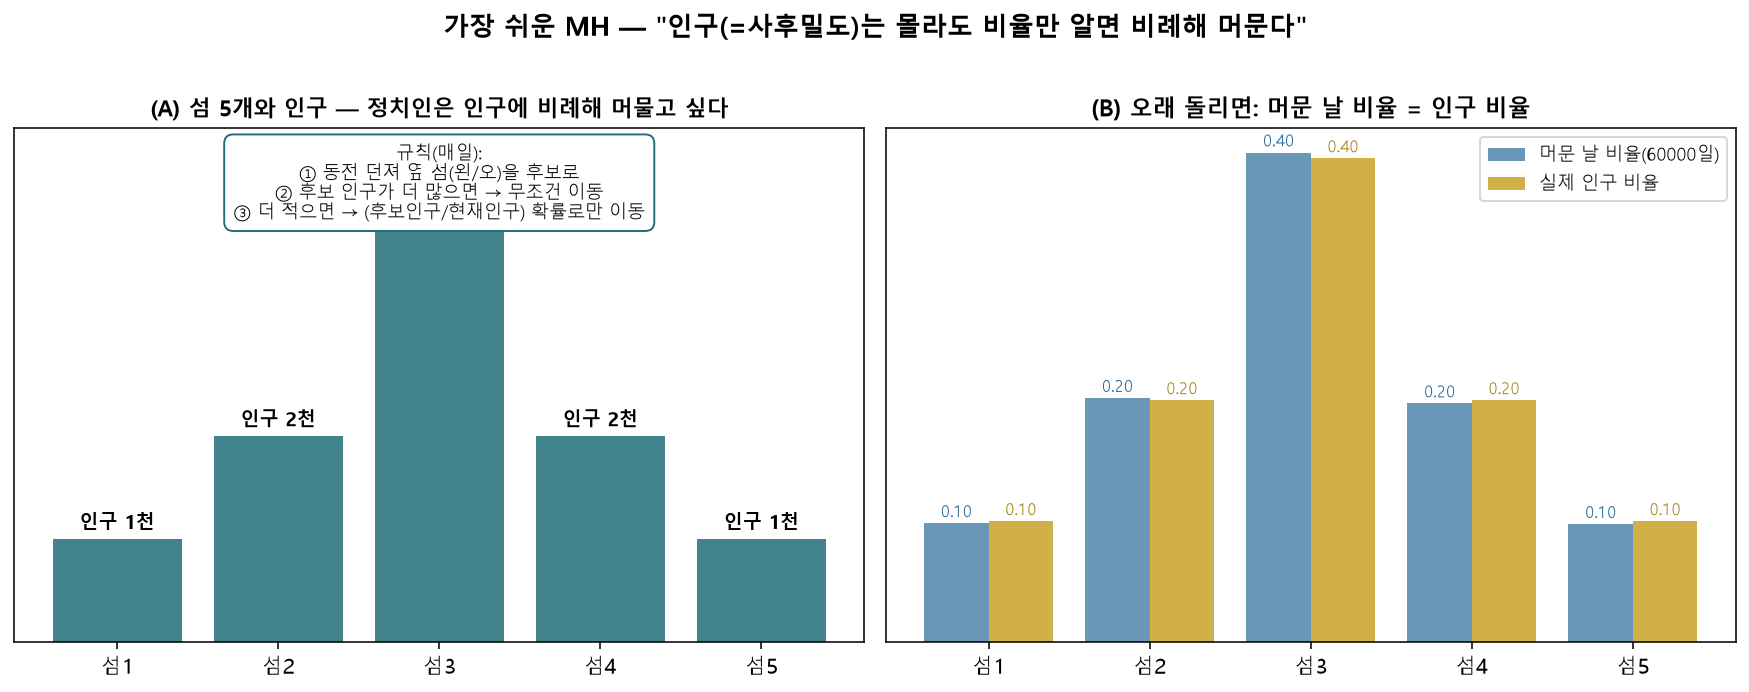
다섯 개 상태에 값을 부여한 경우를 생각한다. 전체 합을 몰라도, 이웃한 두 상태의 값 비율만으로 채택 여부를 정해 반복하면, 각 상태에 머문 비율이 원래 값 비율과 일치한다. 사후의 전체 크기를 몰라도 표집이 가능함을 보여준다.
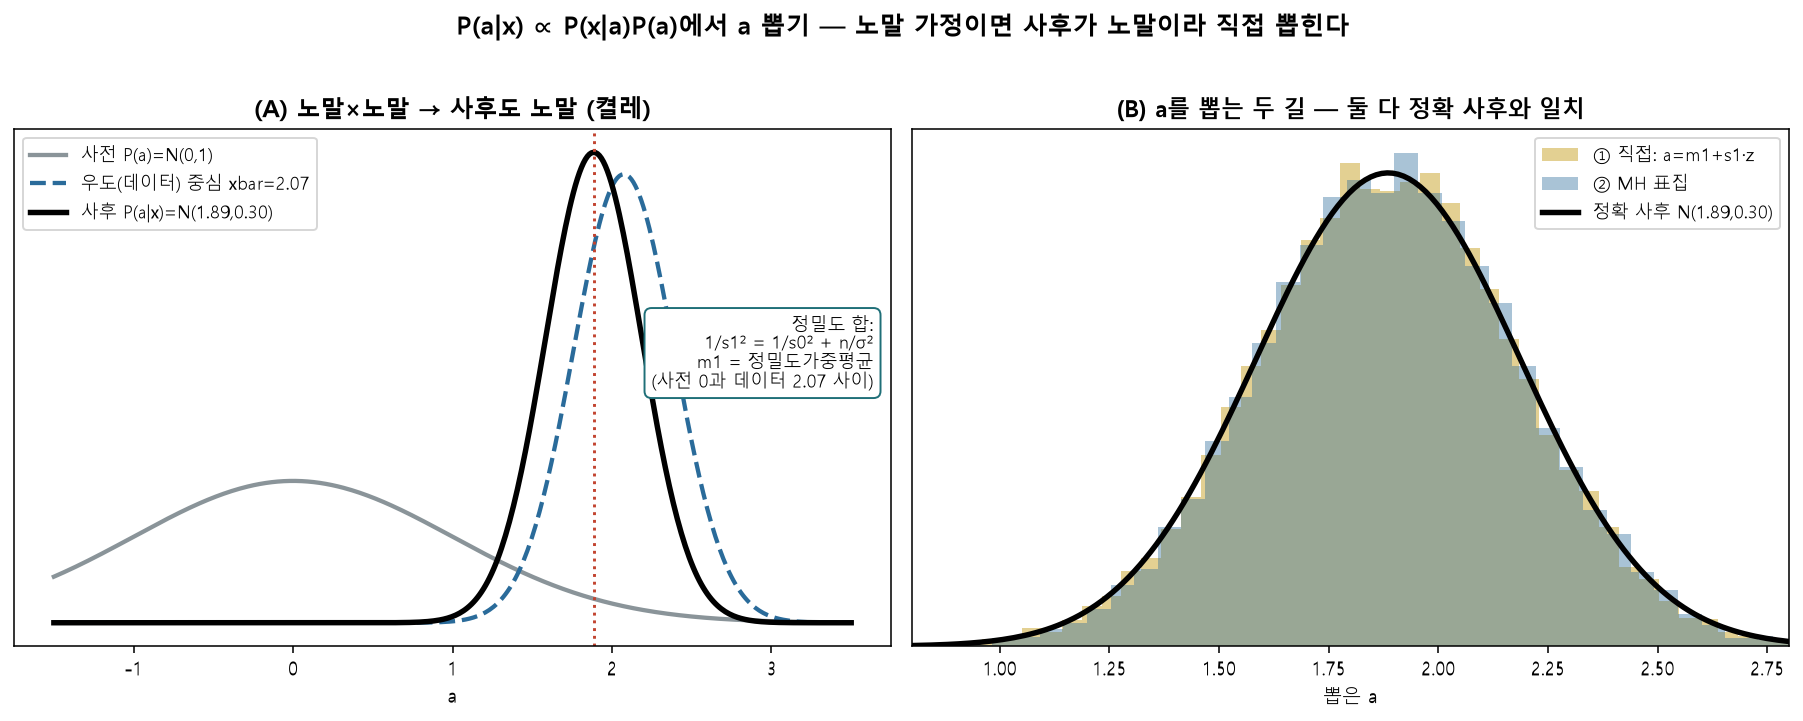
추정에서는 파라미터를 사후에서 42,000개 표집한다. 그 표본의 평균이 추정치(사후평균), 표준편차가 파라미터의 불확실성(사후표준편차)이다. 신용구간이 0을 제외하면 유의하다고 판단한다. 아래는 파라미터가 하나인 경우의 예로, 직접 표집과 MH 표집이 동일한 사후를 재현함을 보인다.
위 아홉 장면 전체가 다음 한 줄로 실행된다.
mode_compute=5, mh_replic=30000, mh_nblocks=2, mh_jscale=0.3, mh_drop=0.3);
| 옵션 | 장면 |
|---|---|
datafile, nobs=104 | 1·2 — 104분기 관측으로 우도 계산 |
diffuse_filter | 2 — 추세 상태의 확산 초기화로 칼만필터 |
mode_compute=5 | 7 — 표집 전 최빈값·제안분포 산출 |
mh_replic=30000, mh_nblocks=2 | 7·9 — 2개 체인 × 3만 반복 |
mh_jscale=0.3 | 7 — 제안 폭(채택률 조절) |
mh_drop=0.3 | 9 — 앞 30% 번인 폐기 → 42,000 표본 |
전체 순서: 파라미터 → (칼만필터: 상태방정식으로 예측, 관찰방정식으로 예측오차, 갱신) → 로그우도 → × 사전 → (메트로폴리스-헤이스팅스 반복) → 42,000 사후표본 → 사후평균(추정치)·사후표준편차(불확실성).