AI For All Lab · Research Portal · LLM 배심원 · 원고 v15 기준
따로 묻고 평균하면, 배심원은 최고의 심판을 넘는다
LLM 13개가 사람이 매긴 문장쌍 2,444개를 네 조건에서 채점했고, 그중 기본 조건 성적 상위 9개를 배심원으로 정했다. 사람 점수와의 서열상관(스피어만 ρ)으로 재면 9개 점수의 평균은 세 코퍼스 모두에서 가장 좋은 단일 모델을 넘는다. 루브릭은 개별 모델을 올리고, 무작위 앵커와 다른 심판의 점수를 보는 것은 배심원을 떨어뜨린다. 다시 묻기만으로는 거의 변하지 않는다.
가설 1 · 배심원
여러 모델의 평균이 최고 단일 모델보다 사람을 잘 따라가는가
배심원 9개 vs 평균 집계, 세 코퍼스 × 네 조건
가설 2 · 루브릭
채점 기준표가 개별 모델과 배심원의 ρ를 함께 올리는가
같은 문항을 루브릭 유무로 두 번 채점
가설 3 · 무작위 앵커
정답과 무관한 앞선 점수가 판정을 끌어당기는가
문항마다 1~5 무작위 값을 "앞선 판정"으로 제시
가설 4 · 의견 교환
서로의 점수와 근거를 보면 배심원이 좋아지는가
1라운드 뒤 자기 재검토 · 점수만 공유 · 점수+근거 공유
숫자로 보는 결론
아래 여섯 칸이 원고 v15의 결과를 요약한다. 값은 따로 적지 않으면 루브릭 없음·앵커 없음 조건이다.
배심원(9개 평균)의 ρ
KorSTS
0.859
KLUE-STS
0.882
STS-B
0.895
최고 단일 모델은 0.815 / 0.843 / 0.875. 10명(모델 9 + 배심원) 중 1위, 12칸 중 12칸. 앵커 없는 6칸 모두 차이(+0.021~+0.045)의 95% 구간이 0을 비껴간다.
배심원 크기 (성적 순 상위 k개)
9개
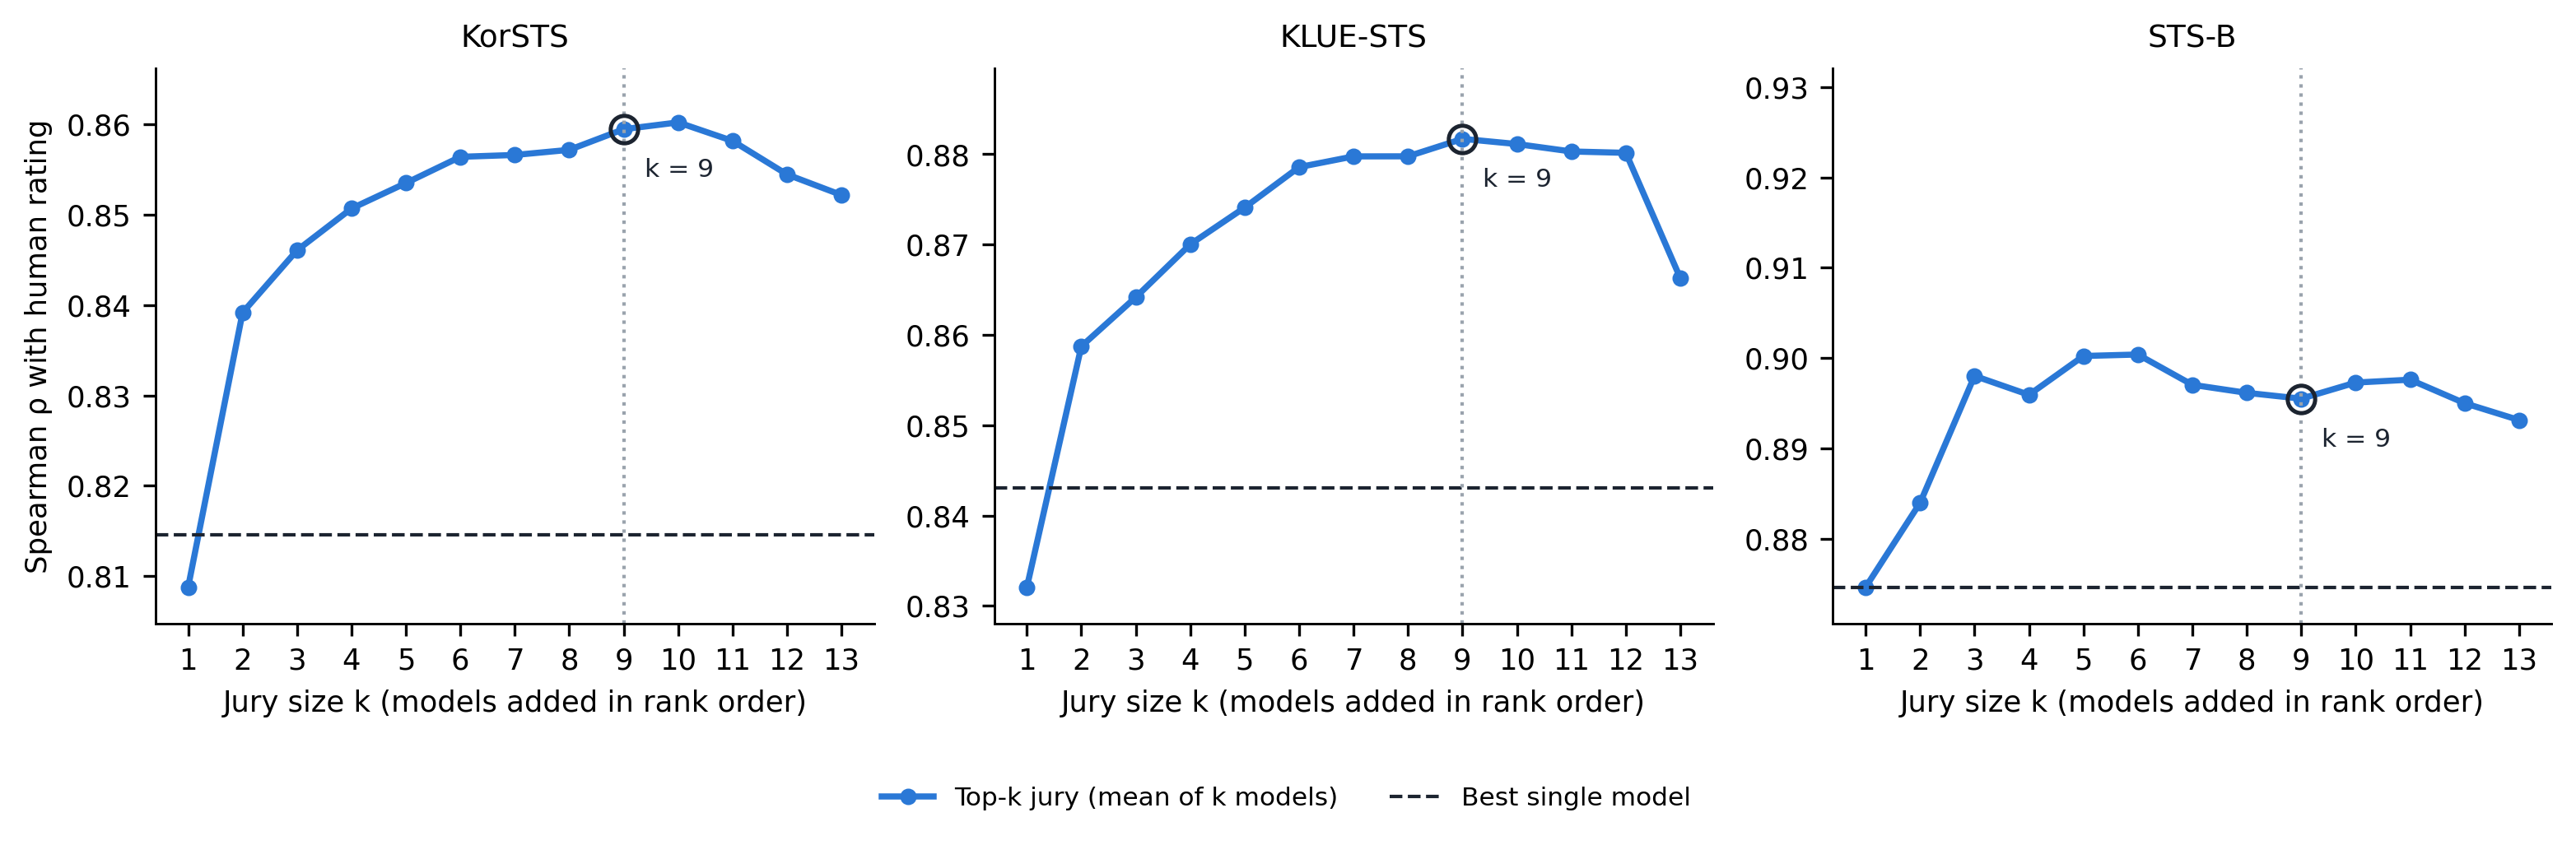
상위 2개만 묶어도 세 코퍼스 모두 최고 단일 모델을 넘는다. 홀수 크기 중 세 코퍼스 평균 ρ가 가장 높은 것이 9개(0.8789).
루브릭 효과 · 배심원 Δρ
KorSTS
+0.016
KLUE-STS
+0.008
STS-B
+0.017
개별 모델 평균 +0.013 / +0.016 / +0.023(모두 구간이 0을 비껴감). 배심원은 KLUE-STS에서 구간이 0을 포함한다.
무작위 앵커 효과 · 배심원 Δρ
KorSTS
−0.053
KLUE-STS
−0.050
STS-B
−0.011
개별 모델 평균 −0.086 / −0.073 / −0.027. 움직일 수 있는 판정의 50 / 47 / 28%가 앵커 쪽으로 끌린다. STS-B 배심원은 구간이 0에 닿는다.
다시 묻기만 (자기 재검토) · 배심원 Δρ
KorSTS
−0.007
KLUE-STS
−0.005
STS-B
−0.003
자기 1라운드 답만 보고 다시 판정하면 판정의 8~11%만 바뀌고 배심원은 거의 그대로다.
남의 점수를 보면 · 배심원 Δρ
KorSTS
−0.013
KLUE-STS
−0.015
STS-B
−0.023
자기 재검토 → 점수만 공유 단계의 효과로, 모두 구간이 0을 비껴간다. 만장일치 문항은 9~31% → 43~63%로 늘지만 배심원은 내려간다. 루브릭이 있어도 내려간다.
논문 원고 v15
가제 「LLM Juries and Human Similarity Ratings: Aggregation, Rubrics, Random Anchors and Deliberation」제목 확정 전. Information Processing & Management(SCIE/SSCI) 투고용 영문 원고. 본문 6절·표 10·그림 6·부록 A~D·참고문헌 43편. 아래 03~06절은 이 원고의 가설·방법·결과를 같은 번호의 표·그림으로 옮긴 것이다.
배심원이 이기려면 표가 독립적이어야 한다
데이터 라벨링, 검색 결과 채점, 요약·답안 평가가 빠르게 LLM에게 넘어가고 있다. 한 모델의 편향을 피하려고 여러 모델에게 같은 문항을 묻고 표를 합치는 배심원(jury) 방식이 퍼졌지만, 그것이 언제 최고의 단일 모델을 넘는지는 실증이 드물다.
오래된 논리
심판들이 서로 독립적으로 틀린다면 표를 합칠 때 오류가 상쇄되어 집단이 어느 구성원보다 진실에 가깝다(Galton, 1907; Condorcet 배심원 정리). LLM 심판들이 이 조건을 만족하는지는 경험적 질문이고, 최근 연구는 서로 다른 회사의 모델도 같은 문항을 같이 틀린다고 경고한다(Kim et al., 2025; Kohli, 2026).
두 가지 설계 선택
- 무엇으로 재는가. 사람 정답은 여러 평가자의 연속 평균(0~5)이고, 배심원의 쓸모는 "어느 쌍이 더 비슷한가"라는 순서다. 사람 점수와의 서열상관은 순서를 그대로 재고, 모델이 전체적으로 높게 주는 습관(척도 치우침)에 영향을 받지 않는다. 반올림한 등급과의 정확일치는 순서를 완벽히 맞추고도 한 칸 후하게 주면 0점이 된다.
- 심판이 무엇을 보는가. 판정 전에 보이는 숫자(앵커)는 사람의 결정을 끌어당기고(Tversky & Kahneman, 1974), LLM은 아첨과 프롬프트 효과에 취약하다(Sharma et al., 2024; Sclar et al., 2024). 서로의 점수를 본 배심원은 더 이상 독립 투표가 아니다.
지식의 공백
오류 상관이 다수결 이득을 제약한다는 보고는 있으나, 사람이 매긴 정답 위에서 (1) 평균 집계 배심원이 최고 단일 모델을 넘는지, (2) 루브릭이 얼마나 올리는지, (3) 정답과 무관한 앵커가 얼마나 끌어당기는지, (4) 서로의 근거를 읽는 델파이식 교환이 배심원을 돕는지 해치는지를 같은 모델·같은 문항에서 함께 잰 연구는 없다.
판정자 한 명에서 배심원단, 그리고 배심원단의 한계까지
이 분야는 3년 만에 "한 명의 심판"에서 "배심원단"으로, 다시 "배심원단의 한계"로 옮겨 왔다. 원고 2절은 이를 네 갈래(심판·배심원 / 루브릭·앵커 / 사람 점수와의 일치 측정 / 의견 교환)로 정리한다.
| 연도 | 전환점 | 내용 |
|---|---|---|
| 2023 | 판정자 1명의 시대 | GPT-4 한 모델이 심판을 봤다. 장황성·위치 편향이 드러났다 (Zheng et al.; Liu et al.; Saito et al.) |
| 2024 | 배심원의 등장 | 서로 다른 회사의 작은 모델 여럿이 큰 모델 하나보다 정확하고 쌌다 (Verga et al., PoLL). 자기 선호·프롬프트 형식 민감성 보고 (Panickssery et al.; Sclar et al.) |
| 2025 | 오류 상관, 과의존, 다국어 | 회사가 달라도 LLM들은 같은 문제를 같이 틀린다 (Kim et al.). 사람은 과신하는 LLM 출력을 따른다 (Rathi et al.). 20개 과제 대규모 비교 (Bavaresco et al.), 대체 기준 (Calderon et al.), 다국어 심판의 신뢰 저하 (Fu & Liu) |
| 2026 | “9명 중 실효 2표” | 판정자 9명을 모아도 오류가 겹쳐 실질적으로 2표였다 (Kohli) |
루브릭과 앵커
구조화된 기준은 사람 평가자 편향의 표준 처방이고(Fasolo et al., 2025) 세분화된 루브릭은 LLM 평가자를 개선한다(Kim et al., 2024). 앵커링은 사람 판단에서 가장 견고한 발견 중 하나이며(Tversky & Kahneman, 1974), LLM에서 가장 가까운 현상은 아첨(Sharma et al., 2024)이다. 루브릭이 LLM 심판의 앵커링을 줄이는지는 사람 정답 위에서 측정된 적이 없다.
사람 점수와의 일치를 무엇으로 재는가
STS 벤치마크는 시스템과 사람 점수의 일치를 상관으로 보고한다. SemEval은 피어슨(Agirre et al., 2012; Cer et al., 2017), 흔히 스피어만도 함께다. 정답이 여러 평가자의 연속 평균이기 때문이다. 카파류 계수(Cohen, 1968; Artstein & Poesio, 2008)와 이산 등급과의 정확일치는 범주 결정에 맞고, 서열상관은 상대적 순서를 잰다. 사람 평가자들 자신도 구조적으로 갈리므로(Y. Wang et al., 2023) 연속 정답을 그대로 쓴다. 주 지표는 스피어만, 피어슨은 보조로 함께 보고한다.
의견 교환, 사회적 영향, 군중의 지혜
델파이 기법은 집단의 이전 답을 통제된 방식으로 돌려주며 판단을 반복해 수렴과 개선을 기대한다(Dalkey & Helmer, 1963). 델파이식 절차를 피드백 없음 / 집단 통계 / 평가자 근거로 나눠 비교한 실험에서는, 피드백이 없는 조건을 포함한 세 조건 모두 라운드를 거치며 정확도가 올랐고 그 과정은 서로 달랐다(Rowe & Wright, 1996). 사람 군중 실험은 약한 사회적 영향만으로도 추정치의 다양성이 줄고 군중의 지혜가 무너지며 자신감만 커진다고 보고했다(Lorenz et al., 2011). LLM 다중 에이전트 토론은 사실 추론을 돕고(Du et al., 2024) LLM 평가자와 사람 판단의 일치를 높인다는 보고(Chan et al., 2024)가 있는 반면, 토론의 이득은 대부분 다수결에서 오며(Choi et al., 2025) 능력이나 답이 비슷한 에이전트들의 토론은 다수 의견으로 수렴한다는 분석(Estornell & Liu, 2024)도 있다. 외부 피드백 없이 자기 답을 고치게 하면 추론이 잘 나아지지 않고 오히려 나빠지기도 한다(Huang et al., 2024). 그래서 LLM 배심원의 의견 교환을 시험하려면 다시 묻는 효과와 남의 답을 보는 효과를 나눠야 한다. 이렇게 나눈 의견 교환이 사람 정답 기준으로 배심원을 돕는지 해치는지가 네 번째 질문이다.
네 가지 가설
2026-09-16 교수님 의논 이후 세운 가설이다. 지표는 사람 연속 점수와의 스피어만 서열상관 ρ, 배심원은 13개 후보 중 기본 조건 성적 상위 9개의 정수 점수 평균이다. 옛 가설(난이도–이득, 정답+1 앵커)은 폐기했고 그 이력은 11 이전 기록에 있다.
가설 1
인간 평가자에 개별 LLM보다 LLM 배심원(jury)이 가장 잘 따라간다.
배심원 구성원 9개와 배심원 중 배심원의 ρ가 가장 높다. 즉 배심원의 사람 점수와의 서열상관이 모든 개별 모델을 넘는다.
결과: 지지 — 12칸 중 12칸 10명 중 1위, 앵커 없는 6칸 모두 차이 구간이 0을 비껴감 (표 4·부록 표 B.2)가설 2
루브릭을 쓰면 스피어만 순위상관계수가 올라간다.
채점 루브릭을 제공하면 개별 모델과 배심원의 ρ가 함께 오른다.
결과: 개별 평균은 지지(+0.013~+0.023), 배심원은 세 코퍼스 중 둘(KLUE-STS 구간이 0 포함) (표 5)가설 3
정답과 무관한 앵커를 보이면 판정이 끌리고 ρ가 내려간다.
사람 점수와 독립인 무작위 점수를 “앞선 판정”으로 보이면 개별 모델과 배심원의 ρ가 내려가고, 판정이 그 점수 쪽으로 움직인다.
결과: 개별 평균·끌림은 지지(−0.027~−0.086, 끌림 28~50%), 배심원은 루브릭 유무 각각 세 코퍼스 중 둘 (표 5·6)가설 4
점수와 근거를 서로 교환하면 의견은 수렴하지만 배심원의 ρ는 오르지 않고 내려갈 수 있다.
교수님이 제안한 “상호정보 교환 앵커”. 1라운드(근거+점수) 뒤 세 조건(자기 재검토 / 다른 8개의 점수만 공유 / 점수+근거 공유)으로 다시 판정해, 다시 묻는 효과와 남의 답을 보는 효과를 나눈다. 공유는 배심원 9개끼리만.
결과: 지지 — 점수를 공유하면 루브릭 × 코퍼스 6칸 모두 배심원 ρ 하락, 다시 묻기만으로는 거의 변화 없음 (표 7·8)네 가설이 함께 말하는 것
배심원의 이득은 따로 받은 점수를 평균할 때 생긴다. 루브릭은 개별 심판을 좋게 만들고, 무작위 앵커와 다른 심판의 점수는 판정을 한쪽으로 끌어 배심원을 떨어뜨린다. 다시 묻기만으로는 배심원이 거의 변하지 않으므로, 떨어뜨리는 것은 남의 답을 보는 것이다. 실무 지침: 개발사가 다른 여러 모델에게 따로 묻고 평균하라. 최종 판정 전에 서로의 점수를 보여 주지 말라.
같은 모델에게 같은 문항을, 상황만 바꿔서
사람 실험처럼 설계하되 참가자는 전원 LLM이다. 후보 13개 모델이 같은 2,444쌍을 네 조건에서 채점하고, 그중 상위 9개 배심원이 델파이식 라운드로 다시 판정한다. 같은 모델이 자기 자신의 통제집단이므로 판정의 변화가 곧 조작의 효과다(개체 내 설계).
| 요인 | 수준 | 연결 가설 |
|---|---|---|
| 채점 루브릭 | 없음 / 5단계 기준 제공 | 가설 2 |
| 무작위 앵커 | 없음 / “앞선 판정자는 N점” (N ~ 균등{1..5}, 문항 번호를 씨앗으로) | 가설 3 |
| 의견 교환 (델파이) | 1라운드(근거+점수) → 2라운드 세 조건: 자기 재검토(자기 답만) / 점수만 공유(다른 8개의 1라운드 점수) / 점수+근거 공유. 세 조건 모두 같은 1라운드에서 출발, 루브릭 없이·있이 | 가설 4 |
| 배심원 구성 | 13개를 기본 조건 개별 ρ(세 코퍼스 평균) 순으로 정렬 → 상위 k개 평균, 홀수 크기만, 세 코퍼스 평균 ρ가 가장 높은 크기 = 9개 | 가설 1 |
| 난이도 층 | 사람 점수 구간 3개(0~1.67 / 1.67~3.33 / 3.33~5), KLUE-STS 평가자 불일치 3분위 | 탐색적 |
실제 판정 프롬프트
다음 두 문장의 주제 유사도를 1(무관)~5(동일)로 판정하세요.
문장1: 오늘 오후부터 전국에 비가 내리겠습니다.
문장2: 오늘 오후 들어 전국적으로 비가 오겠습니다.
숫자 하나만 답하세요.
영어 문항(STS-B)은 같은 뜻의 영어 프롬프트를 받는다. 루브릭 조건은 첫 줄 뒤에 5단계 채점 기준(5점 같은 사건·주장 / 4점 같은 주제의 매우 유사한 내용 / 3점 같은 분야의 관련 주제 / 2점 부분적으로만 겹침 / 1점 무관)을 덧붙이고,
앵커 조건은 문장 앞에 참고: 앞선 판정자는 이 쌍을 N점으로 판정했습니다.를 덧붙인다.
N은 문항 번호를 씨앗으로 한 의사난수로 1~5에서 균등하게 뽑으므로 사람 점수와 무관하고, 모든 모델에 같은 값이 가며, 재현된다.
전 모델 온도 0, 추론(thinking) 모드 비활성, 버전 고정, 시스템 프롬프트 없음. 채점 조건 판정 수는 13 × 2,444 × 4 = 127,088.
델파이식 의견 교환 (배심원 9개)
1라운드에서 각 모델은 한두 문장의 근거와 점수를 낸다. 2라운드에서는 같은 쌍과 자기 1라운드 점수·근거를 다시 받고, 세 조건 중 하나로 최종 점수를 정한다(유지 또는 변경). 자기 재검토는 다른 정보가 없고, 점수만 공유는 다른 8개 배심원의 1라운드 점수를, 점수+근거 공유는 그 근거까지 ‘평가자 1~8’로 익명화해 문항별 고정 난수 순서로 받는다. 세 조건이 같은 1라운드에서 출발하므로 1라운드 → 자기 재검토는 다시 묻는 효과, 자기 재검토 → 점수만 공유는 남의 점수 효과, 점수만 → 점수+근거는 남의 근거 효과다. 루브릭 없이·있이 두 번 돌렸다. 판정 9 × 2,444 × 8 = 175,968건 중 175,967건에서 점수를 얻어(gpt-oss-120b의 KorSTS 1건 빈 출력) 분석한 판정은 모두 303,055건이다.
후보 13개 모델과 배심원 9개
큰 판정자 하나 대신 서로 다른 계열의 작은 모델들로 패널을 꾸리자는 제안(Verga et al., 2024)을 따라, 대부분 각 개발사의 작거나 저렴한 등급으로 후보를 꾸렸다. 같은 개발사·구조의 모델끼리 오류가 더 비슷하므로(Kim et al., 2025) 개발사 9곳, 공개·비공개 가중치, 8B~120B 크기를 섞었고, 다국어 판정이 영어보다 덜 믿을 만하다는 보고(Fu & Liu, 2025)에 따라 한국 개발사 모델 2개(exaone-3.5, solar-pro4)를 넣었다. 여러 개발사 LLM의 앙상블은 예측 과제에서 사람 군중만큼 정확했다(Schoenegger et al., 2024). 처음 7개로 시작해 9월 17일에 교수님이 주신 키로 6개(solar-pro4 · GLM-5.3-Flash · Kimi-K2.6 · gemma-3-27b · DeepSeek-V4-Flash · Qwen3.5-9B)를 더했다.
배심원 구성 규칙. 13개를 기본 조건(루브릭 없음·앵커 없음) 개별 ρ의 세 코퍼스 평균으로 줄 세우고 상위 k개의 평균을 배심원으로 한다. 배심원 정리와 LLM 평가 패널의 관행에 따라 홀수 크기만 두었고(Dietrich & Spiekermann, 2023; Kohli, 2026), 여러 자료의 성적을 같은 비중으로 평균해 비교하는 관행(A. Wang et al., 2019; Muennighoff et al., 2023)에 따라 세 코퍼스 평균 ρ가 가장 높은 홀수 크기를 골랐다. 그 결과 배심원은 solar-pro4, gpt-4o-mini, exaone-3.5, claude-haiku-4.5, Qwen3.5-9B, gpt-oss-120b, gemma-3-27b, Kimi-K2.6, GLM-5.3-Flash의 9개(개발사 8곳)이고, 네 가설 모두 같은 배심원을 쓴다. 순위와 크기는 기본 조건만으로 정해 루브릭·앵커·의견 교환 조건은 고르는 데 들어가지 않았다.
| 모델 | 배심원 | 개발사 | 가중치 | 크기 | 실행 위치 | 단가 입력 / 출력 |
|---|---|---|---|---|---|---|
| gemini-2.5-flash | — | 비공개 | n/d | Google Gemini API | 0.30 / 2.50 | |
| gemma-4 (8B) | — | 오픈 | 8B, 4비트 | 연구실 서버 (Ollama) | 0 / 0 | |
| exaone-3.5 (7.8B) | 배심원 | LG AI Research | 오픈 | 7.8B, 4비트 | 연구실 서버 (Ollama) | 0 / 0 |
| gpt-4o-mini | 배심원 | OpenAI | 비공개 | n/d | OpenAI API | 0.15 / 0.60 |
| gpt-oss-120b | 배심원 | OpenAI | 오픈 | 120B MoE | Cerebras API | 0.25 / 0.69 |
| claude-haiku-4.5 | 배심원 | Anthropic | 비공개 | n/d | Anthropic API | 1.00 / 5.00 |
| llama-3.1 (8B) | — | Meta | 오픈 | 8B, 4비트 | 연구실 서버 (Ollama) | 0 / 0 |
| solar-pro4 | 배심원 | Upstage | 비공개 | n/d | Upstage API | 0.30 / 1.20 |
| GLM-5.3-Flash | 배심원 | Z.ai (Zhipu) | 오픈 | n/d (Flash급) | DeepInfra | 0.15 / 0.50 |
| Kimi-K2.6 | 배심원 | Moonshot AI | 오픈 | MoE, n/d | DeepInfra; OpenRouter | 0.75 / 3.50 |
| gemma-3-27b | 배심원 | 오픈 | 27B | DeepInfra | 0.08 / 0.16 | |
| DeepSeek-V4-Flash | — | DeepSeek | 오픈 | MoE, n/d | DeepInfra | 0.09 / 0.18 |
| Qwen3.5-9B | 배심원 | Alibaba | 오픈 | 9B | Together AI | 0.10 / 0.15 |
지표·집계·추론
- 지표. 코퍼스 문항 전체에서 심판 점수와 사람 연속 점수의 스피어만 서열상관 ρ(주 지표). 피어슨 r은 보조로, 네 가설 모두의 결과를 부록 표 C.1에 싣는다.
- 배심원. 문항별 구성원 9개 정수 점수의 산술 평균. 사람 정답이 만들어진 방식과 같고, 정수 중앙값이 버리는 순서 정보를 보존한다. 중앙값 집계는 비교용(부록 표 B.3).
- 비교. 같은 코퍼스·조건의 최고 단일 모델(구성원 중), 9개 개별 ρ의 평균, 10명(9 + 배심원) 중 순위. 차이는 문항 단위 쌍 부트스트랩 1,000회의 백분위 95% 구간. p값 대신 구간을 보고.
- 조건 효과. 루브릭 효과 = 루브릭 − 무루브릭(앵커 없음), 앵커 효과 = 앵커 − 무앵커(같은 루브릭 설정). 앵커 끌림 = 무앵커 점수가 앵커와 달랐던 판정 중 앵커 쪽으로 움직인 비율.
- 의견 교환. 조건별 배심원 ρ와 1라운드 대비 변화, 단계 효과(다시 묻기·남의 점수·남의 근거 = 이웃한 조건의 쌍 차이), 수렴(문항 내 9개 점수 표준편차, 만장일치 비율), 움직임(바뀐 판정 비율, 다른 8개의 1라운드 평균 쪽으로 간 비율, 사람 점수에 가까워진/멀어진 비율). 루브릭 유무 사이의 차이는 탐색적으로만.
심판 구성과 설계 변경 이력
2026-09-09 설계는 7모델 · 정확일치 · 중앙값 투표 · 정답+1 앵커였다. 9월 16일 교수님 의논에서 지표를 서열상관으로, 집계를 평균으로 바꾸고 정답+1 앵커(정답을 누설하는 인공물)를 무작위 앵커로 대체했다. 9월 17일 6모델을 더해 13모델, 9월 18일 의견 교환 라운드를 더했다(원고 v10: 13개 평균 배심원, 13개 공유, 조합 8,191개 전수 탐색). 9월 30일 3라운드를 빼고 통제 조건(자기 재검토·점수만 공유)을 더했고, 10월 1~2일 배심원을 "성적 순 상위 k개"로 바꿔 9개로 정한 뒤 의견 교환을 9개끼리만 다시 받았으며, 10월 6일 루브릭 조건의 세 통제 조건까지 받았다(원고 v14~v15). 상세는 의논 페이지와 07 현황.
사람이 매긴 세 자료를 각각 분석한다
같은 설계를 서로 독립된 세 자료에 적용한다. 하나가 다른 하나를 검증하는 관계가 아니라, 같은 질문을 세 번 묻고 답이 자료와 언어를 넘어 재현되는지를 본다.
세 자료 모두 사람이 매긴 공개 벤치마크이고, 정답은 여러 평가자의 연속 평균(0~5)을 그대로 쓴다. 반올림 등급 1~5는 STS-B 표본을 등급별로 고르고 자료를 기술할 때만 썼다.
| 자료 | 언어 | 문항 | 사람 점수 | 평가자 수 | 도메인 | 판정 수 |
|---|---|---|---|---|---|---|
| KorSTS | 한국어 | 1,379쌍 (test 전체) | 평균, 0~5 | 5 | 캡션·뉴스·포럼 (STS-B 번역) | 71,708 + 99,287 |
| KLUE-STS | 한국어 | 519쌍 (dev) | 평균, 0~5 (평가자별 점수 공개) | 7 | 에어비앤비 후기·정책 뉴스·스마트 스피커 발화 | 26,988 + 37,368 |
| STS-B | 영어 | 546쌍 (dev에서 등급별 층화 550, 손상 4쌍 제외) | 평균, 0~5 | 5 | 캡션·뉴스·포럼 | 28,392 + 39,312 |
자료에서 확인한 두 가지
반올림 규칙 불일치. 문항 파일을 만들 때 KorSTS·STS-B는 파이썬 round()(짝수 반올림), KLUE-STS는 int(x+0.5)(반올림)로 등급을 매겨 .5 경계 21쌍의 등급이 갈렸다. 분석은 연속 점수를 그대로 쓰므로 결과에 영향이 없고, 원고 부록 D에 적었다.
STS-B 손상 4문항. 원본 파일을 읽을 때 뒤따르는 줄이 문장 2에 붙거나 문장 2가 비는 손상이 생긴 stsb-0049 · 0279 · 0322 · 0361을 모든 분석에서 제외했다(550 → 546). 부록 표 D.1.
KLUE-STS가 갖는 별도의 쓸모
평가자 7명의 개별 점수가 공개되어 있어 사람들이 한 문항에서 얼마나 갈렸는지를 직접 셀 수 있다. 이 자료에서만 난이도를 사람의 불일치로도 정의한다(표 9 아래 세 줄). 배심원 자신의 불일치로 난이도를 정하면 같은 표로 기준도 정하고 성적도 매기는 순환이 되므로 쓰지 않는다.
사람 점수와의 서열상관으로 본 네 가설
원고 4절의 표 3~10과 그림 1~6을 같은 번호로 옮겼다. 값은 사람 연속 점수와의 스피어만 ρ, 배심원 = 상위 9개 점수의 평균, 구간은 문항 단위 쌍 부트스트랩 1,000회 95%. 부록 표 B.1~B.3(모델별 ρ·r, 앵커 조건, 평균 대 중앙값), C.1(피어슨 전체), D.1(제외 문항)은 이 절 끝에 있다.
4.1 배심원 크기, 그리고 배심원 vs 개별 모델 (가설 1)
모델을 성적 순으로 하나씩 더하면(표 3, 그림 1), 상위 2개만 묶어도 세 코퍼스 모두 최고 단일 모델을 넘는다(0.839 / 0.859 / 0.884 vs 0.815 / 0.843 / 0.875). 이득은 그 뒤 평평해진다. 홀수 크기의 세 코퍼스 평균 ρ는 5개 0.8759, 7개 0.8778, 9개 0.8789, 11개 0.8787로 9개가 가장 높다. STS-B만 보면 7개가 9개보다 조금 높지만(−0.0015) 구간이 0을 포함한다([−0.0041, +0.0011]). 두 배심원이 7개를 공유하고 문항이 546쌍이라 표본 변동보다 작은 차이다. 가장 낮은 순위의 모델들을 더하면 상관이 내려가고, KLUE-STS에서 가장 뚜렷하다.
| k | 더해진 모델 (개별 ρ, 세 코퍼스 평균) | KorSTS | KLUE-STS | STS-B | 평균 |
|---|---|---|---|---|---|
| 1 | solar-pro4 (0.838) | 0.809 | 0.832 | 0.875 | 0.838 |
| 2 | + gpt-4o-mini (0.836) | 0.839 | 0.859 | 0.884 | 0.861 |
| 3 | + exaone-3.5 (7.8B) (0.826) | 0.846 | 0.864 | 0.898 | 0.869 |
| 4 | + claude-haiku-4.5 (0.820) | 0.851 | 0.870 | 0.896 | 0.872 |
| 5 | + Qwen3.5-9B (0.817) | 0.854 | 0.874 | 0.900 | 0.876 |
| 6 | + gpt-oss-120b (0.815) | 0.856 | 0.879 | 0.900 | 0.878 |
| 7 | + gemma-3-27b (0.807) | 0.857 | 0.880 | 0.897 | 0.878 |
| 8 | + Kimi-K2.6 (0.801) | 0.857 | 0.880 | 0.896 | 0.878 |
| 9 | + GLM-5.3-Flash (0.798) | 0.859 | 0.882 | 0.895 | 0.879 |
| 10 | + DeepSeek-V4-Flash (0.780) | 0.860 | 0.881 | 0.897 | 0.880 |
| 11 | + gemini-2.5-flash (0.767) | 0.858 | 0.880 | 0.898 | 0.879 |
| 12 | + gemma-4 (8B) (0.742) | 0.854 | 0.880 | 0.895 | 0.877 |
| 13 | + llama-3.1 (8B) (0.536) | 0.852 | 0.866 | 0.893 | 0.871 |
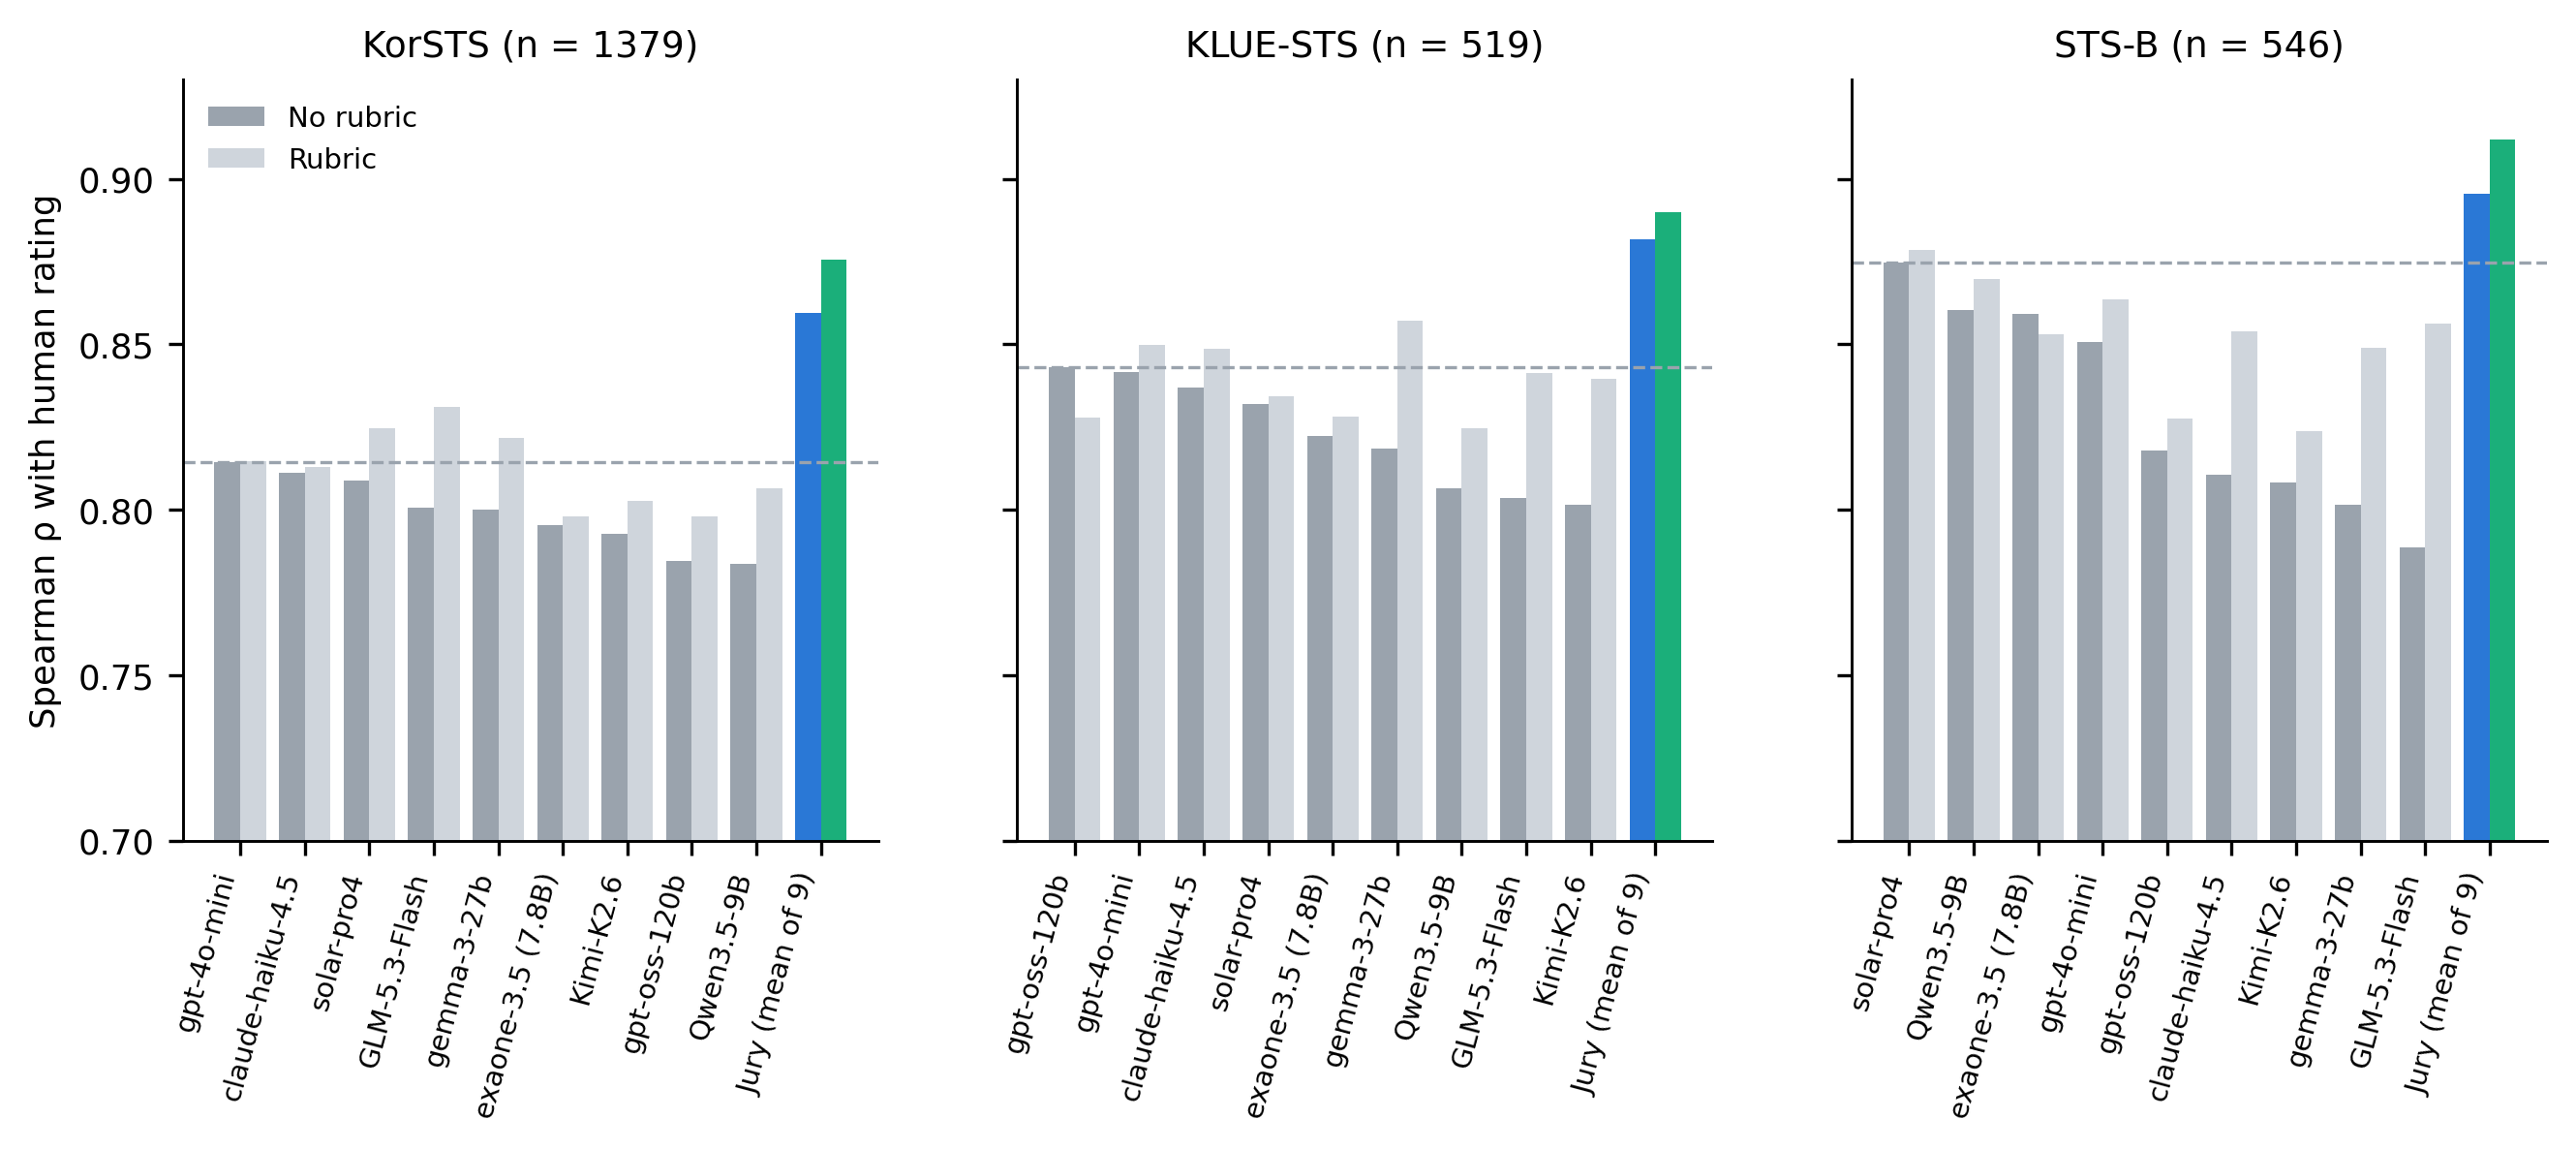
앵커 없는 6칸 모두에서 배심원의 ρ가 모든 구성원을 넘고 10명 중 1위다. 앵커 조건 2개를 더한 12칸에서도 같다(부록 표 B.2). 배심원 − 최고 단일 모델의 쌍 차이는 6칸 모두 양수(+0.021~+0.045)이고 구간이 0을 비껴간다. 피어슨으로도 6칸 모두 배심원이 1위이고, 최고 단일 모델과의 차이 구간은 6칸 중 5칸에서 0을 비껴간다(예외 STS-B 루브릭 없음; 부록 표 C.1). 피어슨이 스피어만보다 낮게 나오는 것은 모델 점수가 위쪽에 몰려 사람 점수와 직선 관계가 아니기 때문이며, 이것이 스피어만을 주 지표로 쓴 이유 중 하나다.
| 코퍼스 | 조건 | 9개 개별 ρ 평균 | 최고 단일 모델 ρ | 배심원 ρ [95% CI] | 배심원 − 최고 단일 [95% CI] | 10명 중 순위 |
|---|---|---|---|---|---|---|
| KorSTS | 루브릭 없음 | 0.799 | 0.815 (gpt-4o-mini) | 0.859 [0.840, 0.875] | +0.045 [+0.033, +0.056] | 1 |
| KorSTS | 루브릭 | 0.812 | 0.831 (GLM-5.3-Flash) | 0.876 [0.859, 0.888] | +0.044 [+0.032, +0.058] | 1 |
| KLUE-STS | 루브릭 없음 | 0.823 | 0.843 (gpt-oss-120b) | 0.882 [0.859, 0.898] | +0.039 [+0.018, +0.060] | 1 |
| KLUE-STS | 루브릭 | 0.839 | 0.857 (gemma-3-27b) | 0.890 [0.870, 0.907] | +0.033 [+0.017, +0.052] | 1 |
| STS-B | 루브릭 없음 | 0.830 | 0.875 (solar-pro4) | 0.895 [0.871, 0.912] | +0.021 [+0.009, +0.034] | 1 |
| STS-B | 루브릭 | 0.853 | 0.878 (solar-pro4) | 0.912 [0.894, 0.926] | +0.034 [+0.022, +0.045] | 1 |
4.2 루브릭 (가설 2)
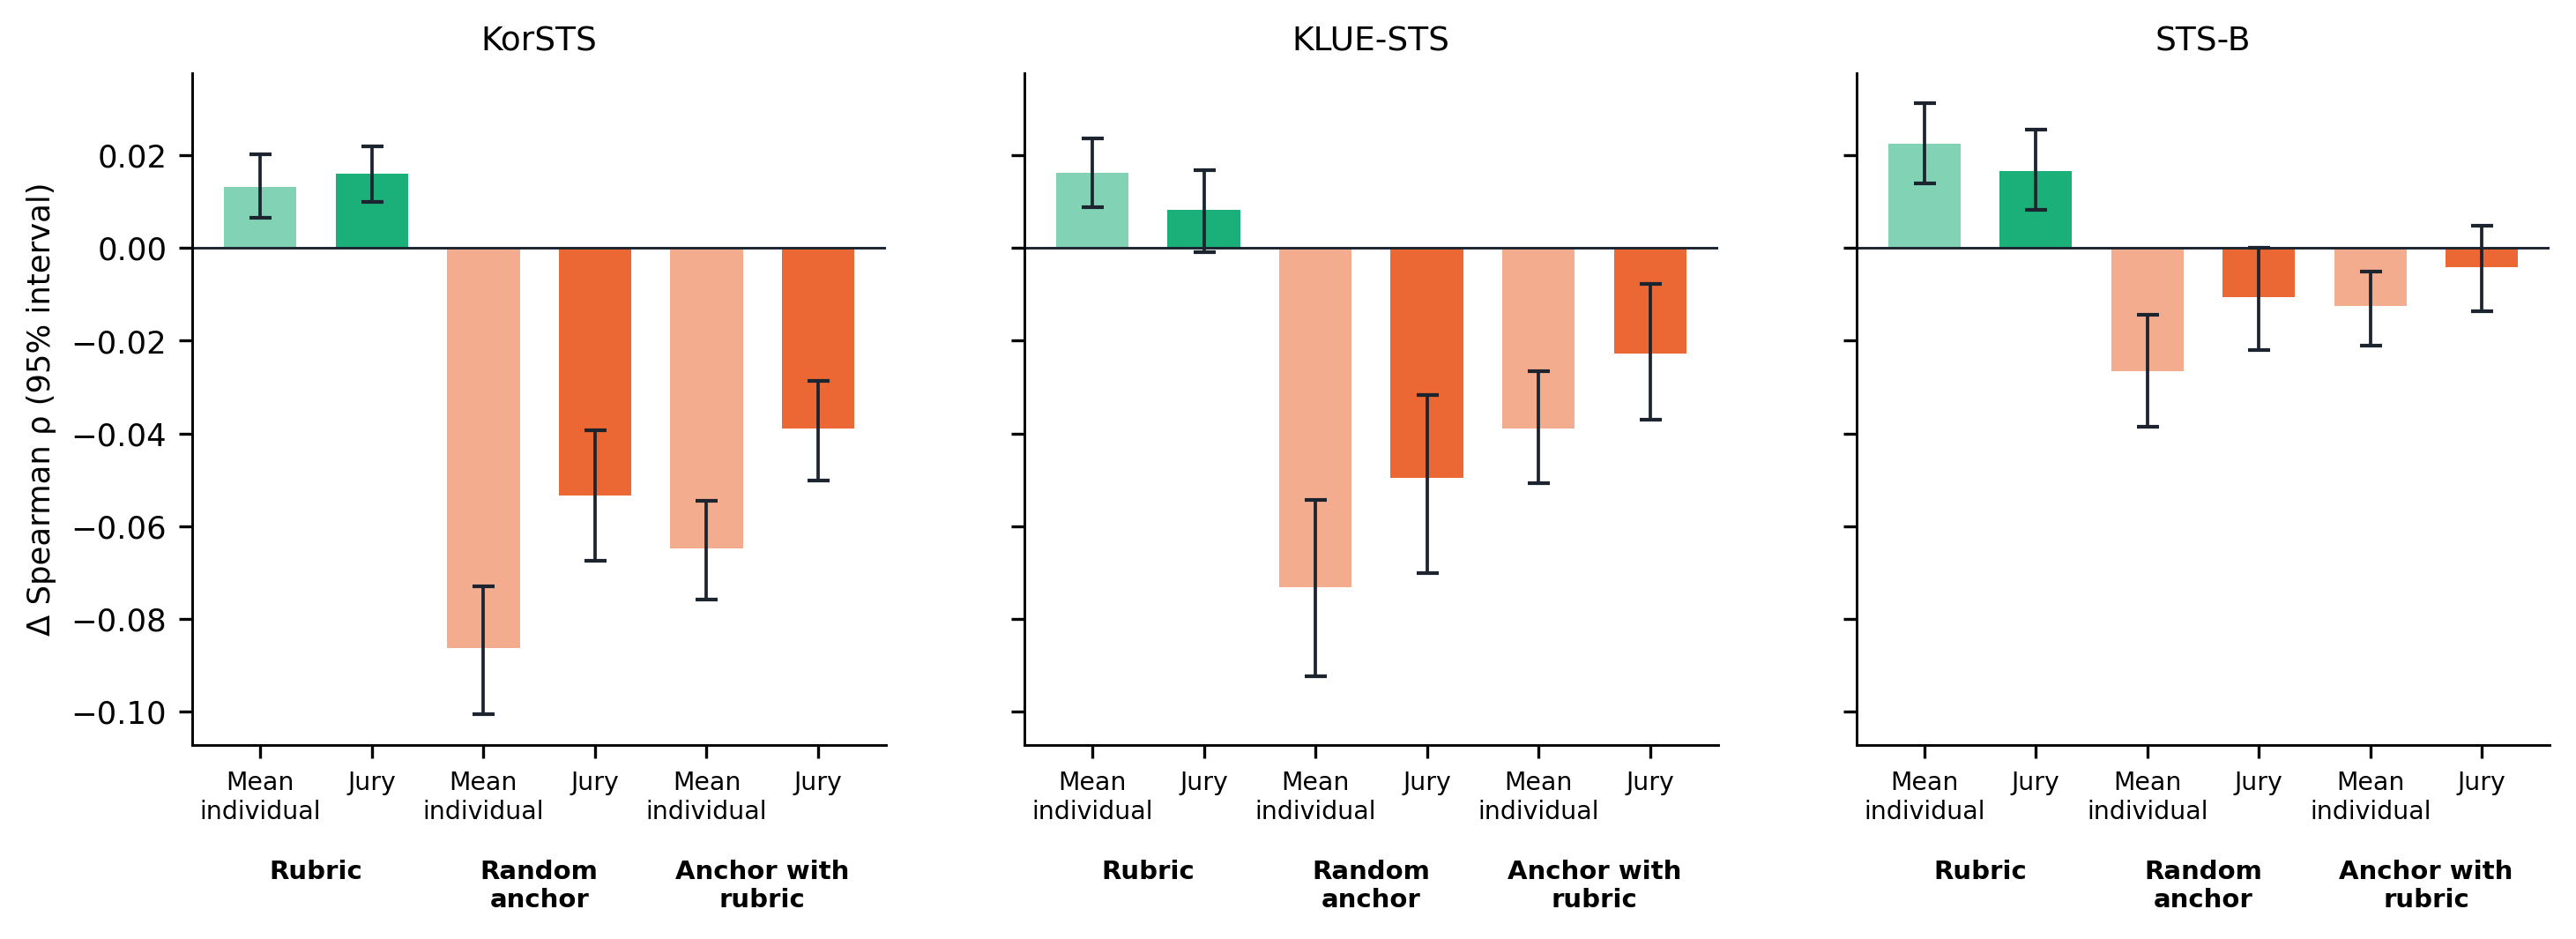
루브릭은 개별 평균 ρ를 세 코퍼스 모두 올리고(+0.013 / +0.016 / +0.023, 구간 모두 0을 비껴감) 배심원은 +0.016 / +0.008 / +0.017 올린다(표 5). 배심원 구간은 KorSTS·STS-B에서 0을 비껴가고 KLUE-STS에서는 포함한다([−0.001, +0.017]). 9개 중 9 / 8 / 8개 모델이 오른다. 최고 단일 모델은 KorSTS에서만 확실히 오르는데, 다른 두 코퍼스에서는 최고 모델이 이미 풀의 위쪽 끝 근처였기 때문이다. 피어슨으로는 세 코퍼스 모두 같은 방향이고 배심원 구간이 모두 0을 비껴가지만, 개별 평균은 KorSTS에서 0을 포함한다(부록 표 C.1).
| 코퍼스 | 루브릭: 개별 평균 Δρ | 루브릭: 최고 단일 Δρ | 루브릭: 배심원 Δρ | 앵커: 개별 평균 Δρ | 앵커: 배심원 Δρ | 앵커+루브릭: 개별 평균 Δρ | 앵커+루브릭: 배심원 Δρ |
|---|---|---|---|---|---|---|---|
| KorSTS | +0.013 [+0.006, +0.020] | +0.017 [+0.003, +0.029] | +0.016 [+0.010, +0.022] | −0.086 [−0.101, −0.073] | −0.053 [−0.068, −0.039] | −0.065 [−0.076, −0.055] | −0.039 [−0.050, −0.029] |
| KLUE-STS | +0.016 [+0.009, +0.024] | +0.014 [−0.005, +0.028] | +0.008 [−0.001, +0.017] | −0.073 [−0.092, −0.054] | −0.050 [−0.070, −0.032] | −0.039 [−0.051, −0.027] | −0.023 [−0.037, −0.008] |
| STS-B | +0.023 [+0.014, +0.031] | +0.004 [−0.007, +0.016] | +0.017 [+0.008, +0.025] | −0.027 [−0.039, −0.014] | −0.011 [−0.022, +0.000] | −0.013 [−0.021, −0.005] | −0.004 [−0.014, +0.005] |
4.3 무작위 앵커 (가설 3)
무작위 앵커는 루브릭 없을 때 개별 평균 ρ를 0.086 / 0.073 / 0.027, 배심원을 0.053 / 0.050 / 0.011 내린다(표 5, 그림 3). 개별 평균은 세 코퍼스 모두 구간이 0을 비껴가고, 배심원은 KorSTS·KLUE-STS에서 비껴가며 STS-B에서는 상한이 0에 닿는다([−0.022, +0.000]). 무앵커 점수가 앵커와 달랐던 판정 중 50% / 47% / 28%가 앵커 쪽으로, 3% / 2% / 3%가 반대쪽으로 움직였다(표 6). 루브릭은 끌림을 20~37%로 줄이고 손실도 줄이지만 없애지는 못한다(루브릭 있어도 배심원 −0.039 / −0.023 / −0.004, KorSTS·KLUE-STS에서 구간이 0을 비껴감). 배심원은 모든 코퍼스·루브릭 설정에서 구성원 평균보다 덜 잃는다. 구성원이 서로 다른 정도로 끌려 평균이 일부 상쇄하기 때문이지만, 앵커를 벗어나지는 못한다. 피어슨으로는 배심원 하락이 KorSTS·KLUE-STS에서 남고 STS-B에서는 없다.
| 코퍼스 | 조건 | 문항 | 움직일 수 있는 판정 | 앵커 쪽으로 (%) | 반대쪽으로 (%) | 그대로 (%) |
|---|---|---|---|---|---|---|
| KorSTS | 루브릭 없음 | 1,379 | 9,756 | 50.2 [49.0, 51.4] | 2.6 [2.1, 3.0] | 47.2 [46.1, 48.4] |
| KorSTS | 루브릭 | 1,379 | 9,824 | 36.8 [35.6, 38.0] | 3.9 [3.4, 4.4] | 59.4 [58.0, 60.5] |
| KLUE-STS | 루브릭 없음 | 519 | 3,702 | 46.7 [44.4, 48.8] | 1.6 [1.1, 2.1] | 51.8 [49.7, 53.9] |
| KLUE-STS | 루브릭 | 519 | 3,692 | 31.8 [29.9, 33.8] | 2.2 [1.6, 2.9] | 66.0 [63.8, 68.0] |
| STS-B | 루브릭 없음 | 546 | 3,961 | 27.8 [25.8, 29.7] | 3.2 [2.5, 4.0] | 69.0 [67.2, 70.8] |
| STS-B | 루브릭 | 546 | 3,985 | 20.1 [18.6, 21.6] | 5.4 [4.5, 6.5] | 74.5 [72.8, 76.1] |
4.4 의견 교환 (가설 4)
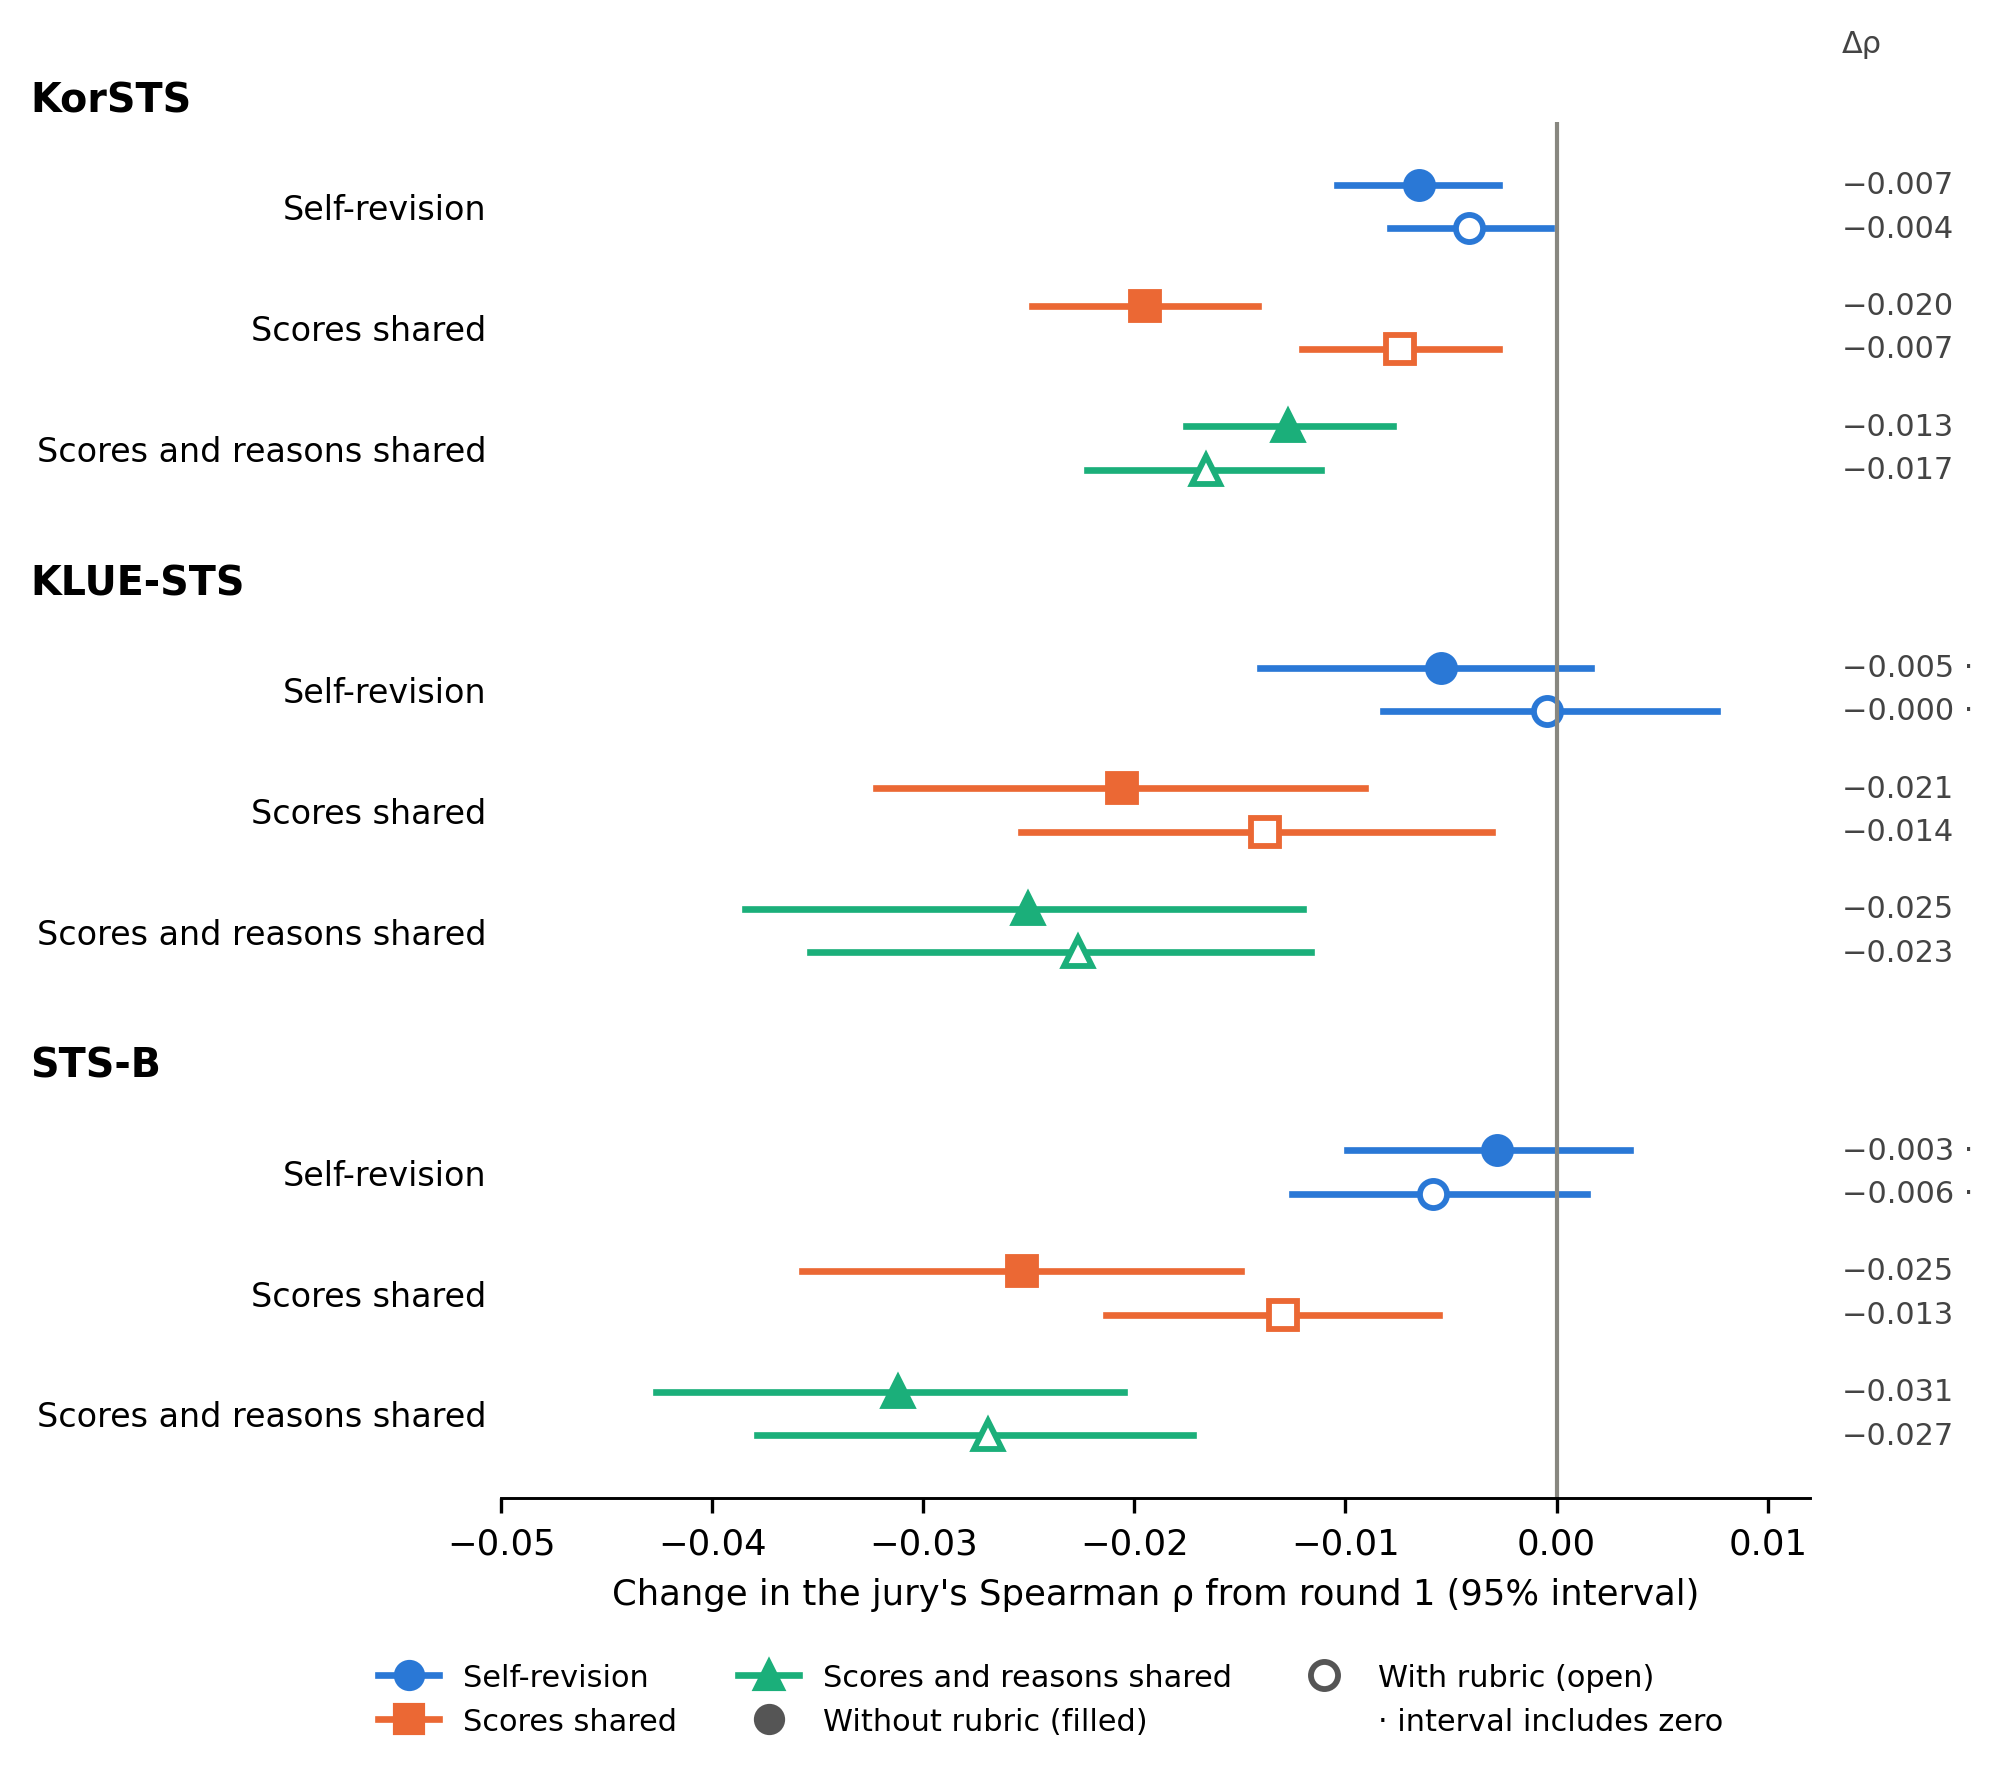
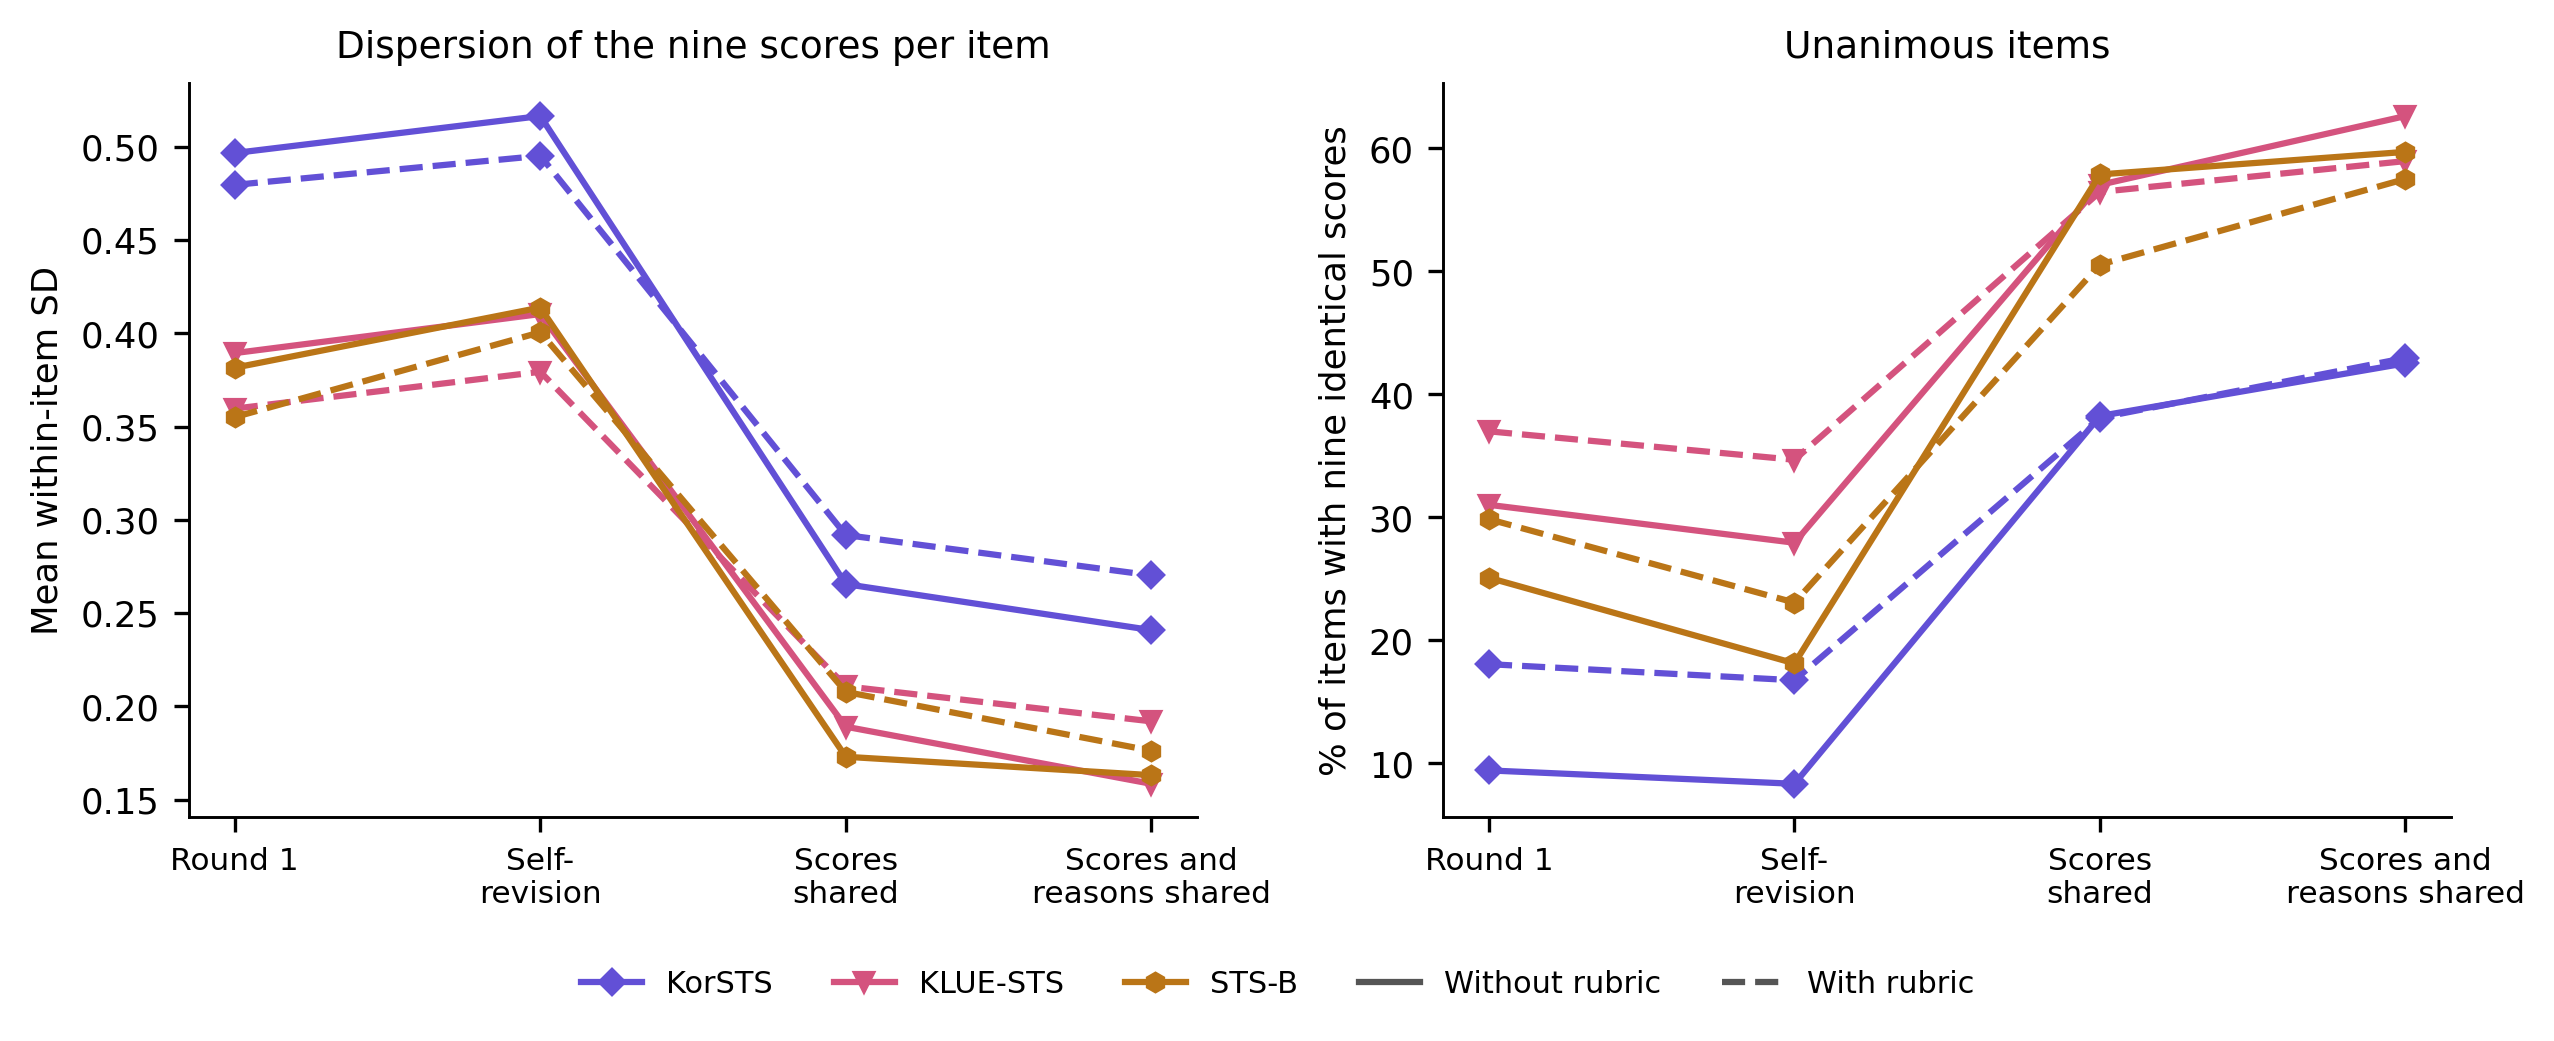
점수 전에 근거를 쓰게 한 1라운드의 배심원 ρ는 0.867 / 0.880 / 0.897(루브릭 없음)로 기본 조건(0.859 / 0.882 / 0.895)과 비슷하다. 다시 묻기(자기 1라운드 답만 보고 재판정)는 판정의 8~11%만 바꾸고 배심원 ρ도 거의 그대로다(−0.007 / −0.005 / −0.003, KorSTS에서만 구간이 0을 비껴감; 표 7, 그림 4). 다른 8개의 점수를 보면 판정의 24~33%가 바뀌고 그중 97~99%가 다른 모델들의 평균 쪽으로 움직이며, 배심원 ρ는 세 코퍼스 모두 내려간다. 자기 재검토 → 점수만 공유 단계의 효과는 −0.013 / −0.015 / −0.023이고 구간이 모두 0을 비껴간다. 근거까지 보여 주면 일관된 추가 효과가 없다(+0.007 / −0.004 / −0.006, KorSTS의 작은 회복만 구간이 0을 비껴감). 불일치는 무너진다. 문항 내 9개 점수의 표준편차는 0.38~0.50에서 0.16~0.24로, 만장일치 문항은 9~31%에서 43~63%로(그림 5). 점수를 공유하면 개별 평균 ρ는 오르지만(예: KorSTS 0.789 → 0.814) 배심원은 내려간다. 구성원들이 서로 닮아 가며 평균이 기대던 다양성이 줄었다는 해석과 맞는다(오류의 독립성을 직접 재지는 않았다). 점수 공유 뒤 바뀐 판정 중 사람 점수에 가까워진 것은 39~48%, 멀어진 것은 52~60%다(표 8). 자기 재검토에서는 더 적게 바뀐 판정의 58~68%가 가까워졌다.
루브릭이 있어도 수렴은 비슷했고, 1라운드 → 점수+근거 공유에서 배심원 ρ가 세 코퍼스 모두 내려갔다(−0.017 / −0.023 / −0.027, 구간 모두 0 제외). 다시 묻기는 거의 바꾸지 않았다(−0.004 / −0.000 / −0.006). 다만 나뉘는 방식이 달랐다. 남의 점수 효과는 −0.003 / −0.013 / −0.007(KLUE-STS만 구간이 0을 비껴감), 남의 근거 효과는 −0.009 / −0.009 / −0.014(KorSTS·STS-B에서 비껴감)였다. 두 루브릭 설정을 탐색적으로 비교하면, 남의 점수로 인한 하락은 루브릭이 있을 때 KorSTS·STS-B에서 더 작았고(차이 +0.010, +0.015, 구간 0 제외) KLUE-STS에서는 아니었다(+0.002). 남의 근거 효과는 KorSTS에서만 달랐다(−0.016). 루브릭은 남의 답을 본 뒤의 하락을 막지 못했다. 다만 공유된 정보 중 어느 부분이 하락을 이끄는지는 바꿀 수 있다. 피어슨으로도 점수만 공유·점수+근거 공유의 하락은 6칸 모두 구간이 0을 비껴가고, 다시 묻기의 효과는 작다(부록 표 C.1).
| 코퍼스 | 루브릭 | 조건 | 배심원 ρ | 1라운드 대비 변화 [95% CI] | 이 단계의 효과 [95% CI] | 개별 평균 ρ |
|---|---|---|---|---|---|---|
| KorSTS | 없음 | 1라운드 | 0.867 | — | — | 0.789 |
| KorSTS | 없음 | 자기 재검토 | 0.860 | −0.007 [−0.010, −0.003] | 다시 묻기: −0.007 [−0.010, −0.003] | 0.780 |
| KorSTS | 없음 | 점수만 공유 | 0.847 | −0.020 [−0.025, −0.014] | 남의 점수: −0.013 [−0.019, −0.007] | 0.814 |
| KorSTS | 없음 | 점수+근거 공유 | 0.854 | −0.013 [−0.018, −0.008] | 남의 근거: +0.007 [+0.002, +0.012] | 0.817 |
| KorSTS | 있음 | 1라운드 | 0.870 | — | — | 0.798 |
| KorSTS | 있음 | 자기 재검토 | 0.866 | −0.004 [−0.008, −0.000] | 다시 묻기: −0.004 [−0.008, −0.000] | 0.793 |
| KorSTS | 있음 | 점수만 공유 | 0.863 | −0.007 [−0.012, −0.003] | 남의 점수: −0.003 [−0.009, +0.002] | 0.825 |
| KorSTS | 있음 | 점수+근거 공유 | 0.854 | −0.017 [−0.022, −0.011] | 남의 근거: −0.009 [−0.015, −0.004] | 0.818 |
| KLUE-STS | 없음 | 1라운드 | 0.880 | — | — | 0.807 |
| KLUE-STS | 없음 | 자기 재검토 | 0.874 | −0.005 [−0.014, +0.002] | 다시 묻기: −0.005 [−0.014, +0.002] | 0.802 |
| KLUE-STS | 없음 | 점수만 공유 | 0.859 | −0.021 [−0.032, −0.009] | 남의 점수: −0.015 [−0.027, −0.002] | 0.831 |
| KLUE-STS | 없음 | 점수+근거 공유 | 0.854 | −0.025 [−0.038, −0.012] | 남의 근거: −0.004 [−0.015, +0.004] | 0.823 |
| KLUE-STS | 있음 | 1라운드 | 0.887 | — | — | 0.823 |
| KLUE-STS | 있음 | 자기 재검토 | 0.886 | −0.000 [−0.008, +0.008] | 다시 묻기: −0.000 [−0.008, +0.008] | 0.817 |
| KLUE-STS | 있음 | 점수만 공유 | 0.873 | −0.014 [−0.025, −0.003] | 남의 점수: −0.013 [−0.025, −0.003] | 0.836 |
| KLUE-STS | 있음 | 점수+근거 공유 | 0.864 | −0.023 [−0.035, −0.012] | 남의 근거: −0.009 [−0.021, +0.001] | 0.831 |
| STS-B | 없음 | 1라운드 | 0.897 | — | — | 0.825 |
| STS-B | 없음 | 자기 재검토 | 0.894 | −0.003 [−0.010, +0.003] | 다시 묻기: −0.003 [−0.010, +0.003] | 0.819 |
| STS-B | 없음 | 점수만 공유 | 0.872 | −0.025 [−0.036, −0.015] | 남의 점수: −0.023 [−0.032, −0.012] | 0.837 |
| STS-B | 없음 | 점수+근거 공유 | 0.866 | −0.031 [−0.043, −0.020] | 남의 근거: −0.006 [−0.017, +0.006] | 0.833 |
| STS-B | 있음 | 1라운드 | 0.902 | — | — | 0.842 |
| STS-B | 있음 | 자기 재검토 | 0.896 | −0.006 [−0.013, +0.001] | 다시 묻기: −0.006 [−0.013, +0.001] | 0.827 |
| STS-B | 있음 | 점수만 공유 | 0.889 | −0.013 [−0.021, −0.006] | 남의 점수: −0.007 [−0.016, +0.002] | 0.851 |
| STS-B | 있음 | 점수+근거 공유 | 0.875 | −0.027 [−0.038, −0.017] | 남의 근거: −0.014 [−0.023, −0.006] | 0.846 |
| 코퍼스 | 루브릭 | 조건 | 바뀜 (%) | 다른 모델 쪽 (%) | 사람에 가까워짐 (%) | 사람에서 멀어짐 (%) |
|---|---|---|---|---|---|---|
| KorSTS | 없음 | 자기 재검토 | 10.0 [9.5, 10.5] | 74.8 [72.2, 77.2] | 58.5 [55.7, 61.2] | 40.5 [37.9, 43.4] |
| KorSTS | 없음 | 점수만 공유 | 33.2 [32.1, 34.4] | 98.5 [98.1, 98.9] | 46.0 [44.5, 47.4] | 53.1 [51.7, 54.6] |
| KorSTS | 없음 | 점수+근거 공유 | 29.0 [28.1, 29.9] | 99.1 [98.8, 99.5] | 41.6 [39.8, 43.3] | 57.5 [55.7, 59.3] |
| KorSTS | 있음 | 자기 재검토 | 11.8 [11.1, 12.4] | 78.0 [75.4, 80.3] | 61.0 [58.4, 63.5] | 37.3 [34.8, 39.8] |
| KorSTS | 있음 | 점수만 공유 | 29.5 [28.3, 30.6] | 96.5 [95.8, 97.2] | 46.1 [44.6, 47.5] | 52.8 [51.4, 54.3] |
| KorSTS | 있음 | 점수+근거 공유 | 28.3 [27.2, 29.4] | 96.8 [96.2, 97.4] | 40.8 [39.3, 42.2] | 57.6 [56.1, 59.1] |
| KLUE-STS | 없음 | 자기 재검토 | 7.7 [6.8, 8.6] | 72.9 [68.4, 77.6] | 67.6 [62.0, 72.6] | 31.6 [26.7, 37.1] |
| KLUE-STS | 없음 | 점수만 공유 | 24.0 [22.0, 26.1] | 97.1 [95.9, 98.1] | 38.9 [36.3, 41.5] | 60.0 [57.5, 62.4] |
| KLUE-STS | 없음 | 점수+근거 공유 | 21.6 [20.0, 23.4] | 98.3 [97.4, 99.1] | 32.8 [30.1, 35.8] | 66.1 [63.0, 69.0] |
| KLUE-STS | 있음 | 자기 재검토 | 8.8 [7.9, 9.9] | 76.0 [71.5, 80.2] | 59.8 [54.6, 64.6] | 39.2 [34.6, 44.1] |
| KLUE-STS | 있음 | 점수만 공유 | 21.0 [19.1, 22.9] | 95.9 [94.3, 97.3] | 38.6 [35.7, 41.0] | 60.5 [57.8, 63.3] |
| KLUE-STS | 있음 | 점수+근거 공유 | 20.8 [19.0, 22.7] | 97.0 [95.9, 98.1] | 36.3 [33.2, 39.4] | 62.9 [59.7, 65.9] |
| STS-B | 없음 | 자기 재검토 | 11.0 [10.0, 12.0] | 76.5 [72.6, 80.6] | 61.6 [57.6, 65.7] | 37.9 [33.7, 41.9] |
| STS-B | 없음 | 점수만 공유 | 25.8 [24.0, 27.8] | 98.3 [97.5, 99.1] | 47.6 [44.8, 50.2] | 51.9 [49.4, 54.8] |
| STS-B | 없음 | 점수+근거 공유 | 26.1 [24.3, 27.9] | 98.4 [97.7, 99.2] | 39.7 [36.9, 42.4] | 59.8 [57.1, 62.7] |
| STS-B | 있음 | 자기 재검토 | 11.4 [10.3, 12.5] | 72.2 [67.9, 76.5] | 56.6 [52.2, 61.4] | 42.8 [38.1, 47.2] |
| STS-B | 있음 | 점수만 공유 | 22.3 [20.6, 23.9] | 96.6 [95.3, 97.8] | 46.1 [43.2, 48.9] | 53.7 [50.9, 56.6] |
| STS-B | 있음 | 점수+근거 공유 | 23.0 [21.1, 24.7] | 96.6 [95.4, 97.9] | 37.4 [34.6, 40.3] | 62.3 [59.3, 65.1] |
4.5 난이도 층 (탐색적)
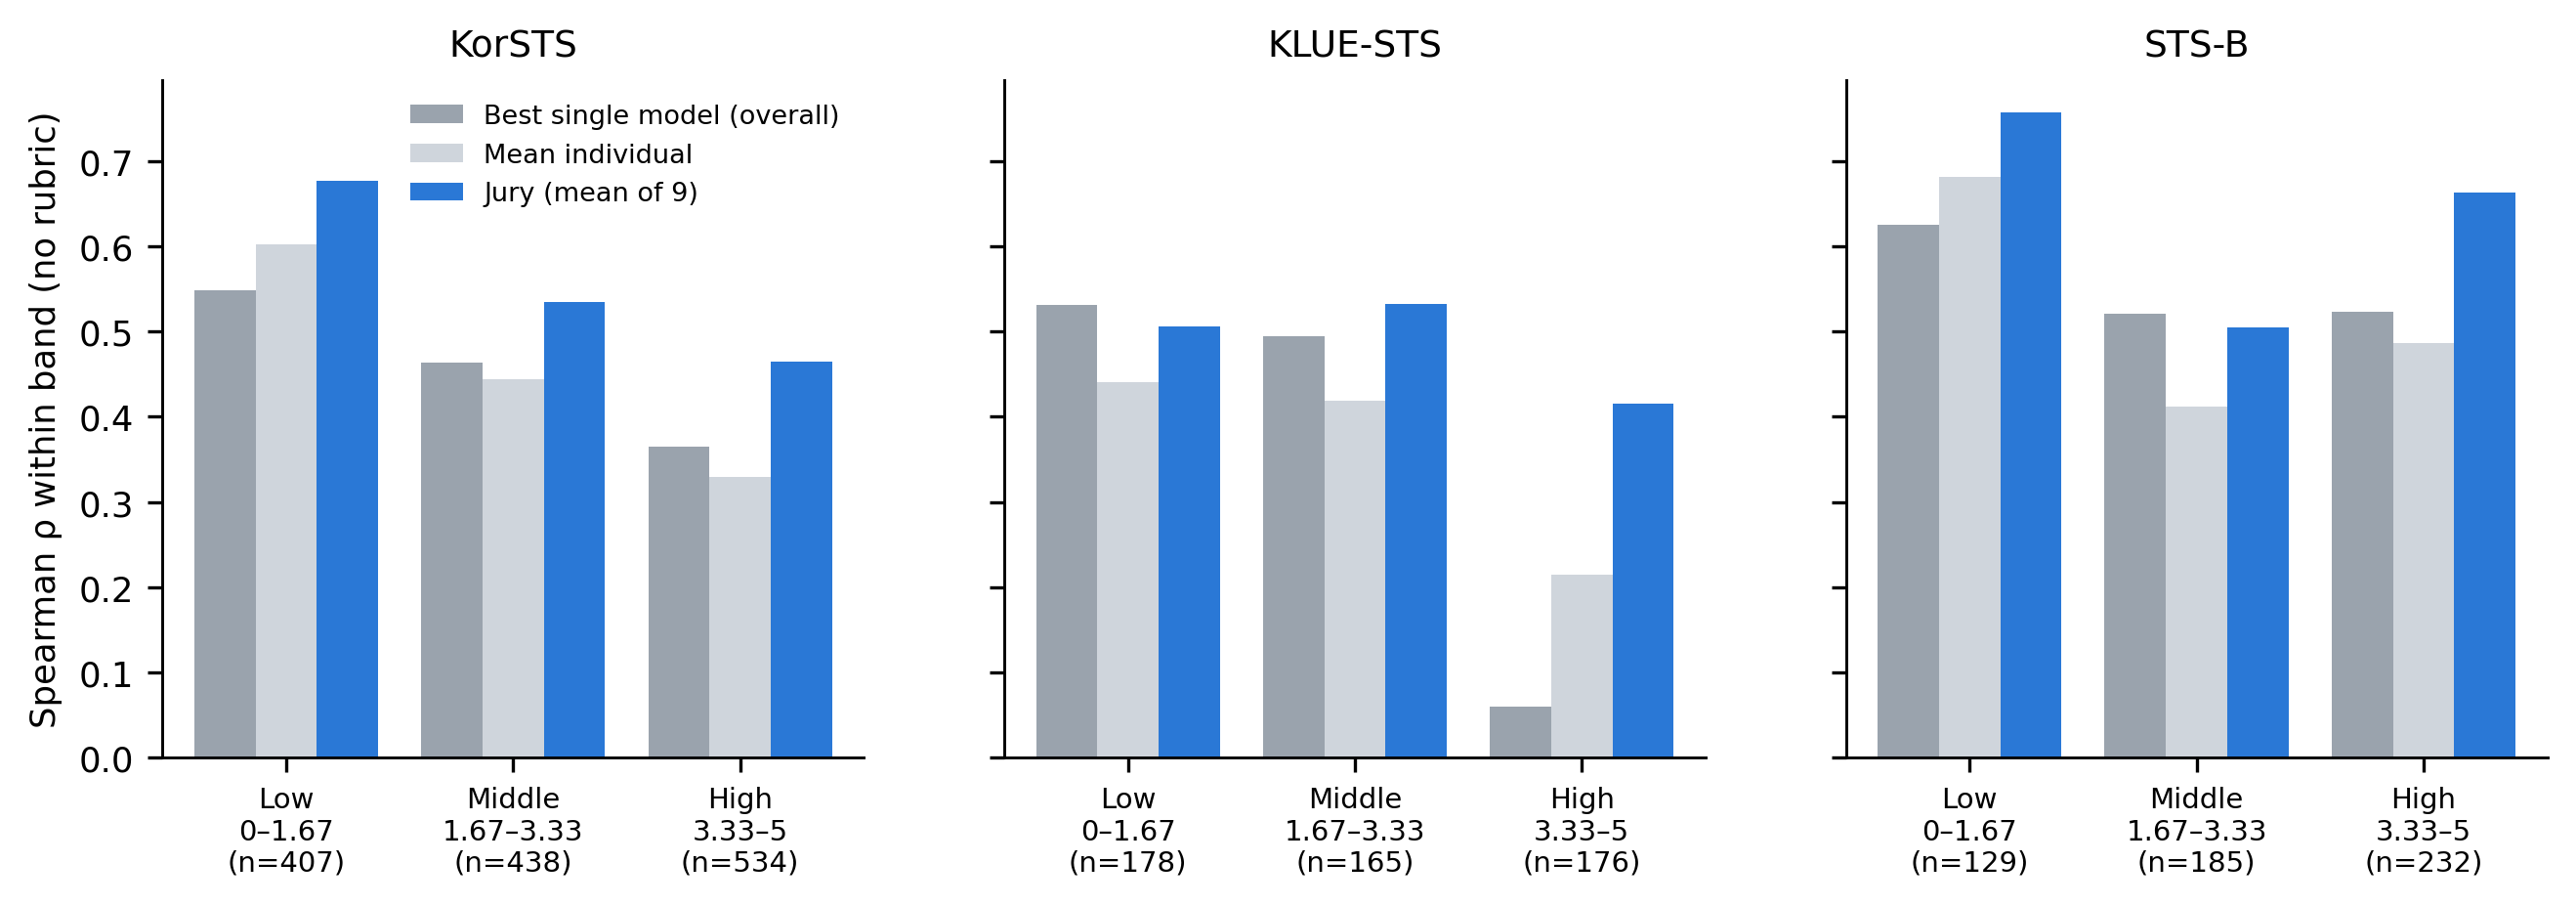
사람 점수 구간 안에서는 범위 제한으로 상관이 낮아지지만 심판들의 순서는 유지된다. 배심원의 점추정은 루브릭 없을 때 코퍼스 × 구간 9칸 중 7칸에서 최고 단일 모델을 넘고(그중 6칸에서 구간이 0을 비껴감), 9칸 모두에서 개별 평균을 넘는다(모두 구간 0 제외; 표 9, 그림 6). 모델들의 위쪽 치우침이 점수를 압축하는 KLUE-STS 높은 구간이 모든 심판에게 가장 약한 칸이다. KLUE-STS 평가자 불일치 하·중·상위 3분위에서 배심원의 최고 단일 모델 대비 여유는 +0.014 / +0.069 / +0.032(구간 [−0.009, +0.037], [+0.026, +0.119], [−0.030, +0.090]). 피어슨으로도 배심원은 9칸 모두 개별 평균을 넘고(구간 0 제외) 8칸에서 최고 단일 모델을 넘지만(6칸에서 0 제외), 칸별로는 다르다. KLUE-STS 높은 구간의 최고 단일 대비 여유는 +0.355에서 +0.007(구간 0 포함)로 줄고, 낮은 구간은 −0.025에서 +0.080으로 바뀐다.
| 코퍼스 | 구간 | n | 구간 내 사람 점수 SD | 최고 단일(전체) ρ | 개별 평균 ρ | 배심원 ρ | 배심원 − 최고 단일 [95% CI] | 배심원 − 개별 평균 [95% CI] |
|---|---|---|---|---|---|---|---|---|
| KorSTS | 낮음 (0~1.67) | 407 | 0.54 | 0.548 | 0.602 | 0.676 | +0.128 [+0.090, +0.170] | +0.074 [+0.063, +0.085] |
| KorSTS | 중간 (1.67~3.33) | 438 | 0.47 | 0.464 | 0.444 | 0.535 | +0.071 [+0.026, +0.120] | +0.091 [+0.073, +0.109] |
| KorSTS | 높음 (3.33~5) | 534 | 0.54 | 0.365 | 0.330 | 0.465 | +0.100 [+0.053, +0.146] | +0.135 [+0.112, +0.159] |
| KLUE-STS | 낮음 (0~1.67) | 178 | 0.48 | 0.532 | 0.441 | 0.506 | −0.025 [−0.107, +0.050] | +0.066 [+0.041, +0.086] |
| KLUE-STS | 중간 (1.67~3.33) | 165 | 0.49 | 0.495 | 0.419 | 0.533 | +0.038 [−0.040, +0.135] | +0.114 [+0.073, +0.152] |
| KLUE-STS | 높음 (3.33~5) | 176 | 0.47 | 0.060 | 0.215 | 0.415 | +0.355 [+0.196, +0.523] | +0.200 [+0.101, +0.295] |
| KLUE-STS, 평가자 불일치 | 낮음 | 198 | 1.84 | 0.885 | 0.868 | 0.899 | +0.014 [−0.009, +0.037] | +0.031 [+0.014, +0.049] |
| KLUE-STS, 평가자 불일치 | 중간 | 149 | 1.40 | 0.802 | 0.809 | 0.872 | +0.069 [+0.026, +0.119] | +0.063 [+0.037, +0.087] |
| KLUE-STS, 평가자 불일치 | 높음 | 172 | 0.98 | 0.719 | 0.678 | 0.751 | +0.032 [−0.030, +0.090] | +0.073 [+0.045, +0.098] |
| STS-B | 낮음 (0~1.67) | 129 | 0.58 | 0.625 | 0.681 | 0.757 | +0.132 [+0.062, +0.211] | +0.076 [+0.056, +0.098] |
| STS-B | 중간 (1.67~3.33) | 185 | 0.50 | 0.521 | 0.412 | 0.505 | −0.015 [−0.078, +0.042] | +0.093 [+0.057, +0.126] |
| STS-B | 높음 (3.33~5) | 232 | 0.55 | 0.523 | 0.487 | 0.663 | +0.140 [+0.075, +0.208] | +0.176 [+0.136, +0.218] |
4.6 가설 요약
| 가설 | 예측 | 결과 | 근거 |
|---|---|---|---|
| 가설 1 배심원 | 배심원의 ρ가 모든 개별 모델을 넘는다 | 지지 | 코퍼스 × 조건 12칸 중 12칸에서 10명 중 1위; 앵커 없는 6칸 모두 배심원 − 최고 단일 > 0, 구간이 0을 비껴감 (표 4, 부록 B). 홀수 크기 중 9개가 세 코퍼스 평균 ρ 최고 (표 3) |
| 가설 2 루브릭 | 루브릭이 개별과 배심원의 ρ를 올린다 | 개별 평균은 지지, 배심원은 세 코퍼스 중 둘, 모든 모델이 오르지는 않음 | 앵커 없을 때 개별 평균 +0.013~+0.023(구간 모두 0 제외), 배심원 +0.008~+0.017(KorSTS·STS-B에서 0 제외). 오른 모델 9/9, 8/9, 8/9 (표 5) |
| 가설 3 앵커 | 무작위 앵커가 ρ를 내리고 판정을 끌어당긴다 | 개별 평균·끌림은 지지, 배심원은 세 코퍼스 중 둘 | 루브릭 없을 때 개별 평균 −0.086~−0.027(구간 모두 0 제외), 배심원 −0.053~−0.011(KorSTS·KLUE-STS에서 0 제외); 움직일 수 있는 판정의 28~50%가 앵커 쪽으로. 루브릭 있으면 배심원은 KorSTS·KLUE-STS에서 하락, 끌림은 남음 (표 5~6) |
| 가설 4 의견 교환 | 점수·근거 공유는 의견을 수렴시키지만 배심원의 ρ를 올리지 않는다 | 지지 | 점수를 공유하면 루브릭 × 코퍼스 6칸 모두 만장일치가 늘고 배심원 ρ가 1라운드보다 내려감(구간 0 제외); 다시 묻기만으로는 거의 변화 없음 (표 7~8, 그림 4~5) |
부록 표
| 모델 | KorSTS 무루브릭 ρ / r | KorSTS 루브릭 ρ / r | KLUE-STS 무루브릭 ρ / r | KLUE-STS 루브릭 ρ / r | STS-B 무루브릭 ρ / r | STS-B 루브릭 ρ / r |
|---|---|---|---|---|---|---|
| solar-pro4 | 0.809 / 0.817 | 0.825 / 0.828 | 0.832 / 0.796 | 0.834 / 0.826 | 0.875 / 0.880 | 0.878 / 0.885 |
| gpt-4o-mini | 0.815 / 0.822 | 0.815 / 0.814 | 0.841 / 0.828 | 0.850 / 0.843 | 0.851 / 0.857 | 0.864 / 0.866 |
| exaone-3.5 (7.8B) | 0.795 / 0.803 | 0.798 / 0.806 | 0.822 / 0.800 | 0.828 / 0.804 | 0.859 / 0.865 | 0.853 / 0.859 |
| claude-haiku-4.5 | 0.811 / 0.824 | 0.813 / 0.816 | 0.837 / 0.813 | 0.849 / 0.825 | 0.811 / 0.827 | 0.854 / 0.864 |
| Qwen3.5-9B | 0.784 / 0.795 | 0.807 / 0.812 | 0.807 / 0.766 | 0.825 / 0.813 | 0.861 / 0.865 | 0.870 / 0.874 |
| gpt-oss-120b | 0.785 / 0.791 | 0.798 / 0.788 | 0.843 / 0.792 | 0.828 / 0.791 | 0.818 / 0.822 | 0.827 / 0.821 |
| gemma-3-27b | 0.800 / 0.811 | 0.822 / 0.828 | 0.818 / 0.788 | 0.857 / 0.834 | 0.802 / 0.821 | 0.849 / 0.859 |
| Kimi-K2.6 | 0.793 / 0.796 | 0.803 / 0.792 | 0.802 / 0.744 | 0.840 / 0.769 | 0.808 / 0.819 | 0.824 / 0.827 |
| GLM-5.3-Flash | 0.801 / 0.801 | 0.831 / 0.824 | 0.804 / 0.742 | 0.841 / 0.800 | 0.789 / 0.790 | 0.856 / 0.857 |
| 배심원 (9개 평균) | 0.859 / 0.860 | 0.876 / 0.876 | 0.882 / 0.843 | 0.890 / 0.872 | 0.895 / 0.885 | 0.912 / 0.905 |
| 모델 | KorSTS 앵커 / 앵커+루브릭 ρ | KLUE-STS 앵커 / 앵커+루브릭 ρ | STS-B 앵커 / 앵커+루브릭 ρ | 응답 시간 중앙값 (초) |
|---|---|---|---|---|
| solar-pro4 | 0.663 / 0.716 | 0.707 / 0.777 | 0.866 / 0.874 | 0.4 |
| gpt-4o-mini | 0.672 / 0.710 | 0.752 / 0.788 | 0.703 / 0.801 | 0.7 |
| exaone-3.5 (7.8B) | 0.569 / 0.777 | 0.601 / 0.792 | 0.829 / 0.834 | 0.4 |
| claude-haiku-4.5 | 0.749 / 0.787 | 0.758 / 0.849 | 0.833 / 0.847 | 0.8 |
| Qwen3.5-9B | 0.751 / 0.570 | 0.792 / 0.723 | 0.847 / 0.842 | 0.5 |
| gpt-oss-120b | 0.740 / 0.796 | 0.795 / 0.826 | 0.746 / 0.828 | 0.4 |
| gemma-3-27b | 0.714 / 0.788 | 0.728 / 0.827 | 0.759 / 0.832 | 1.0 |
| Kimi-K2.6 | 0.763 / 0.763 | 0.793 / 0.775 | 0.837 / 0.846 | 1.2 |
| GLM-5.3-Flash | 0.794 / 0.821 | 0.821 / 0.844 | 0.813 / 0.857 | 2.2 |
| 배심원 (9개 평균) | 0.806 / 0.836 | 0.832 / 0.867 | 0.885 / 0.908 | — |
| 배심원 10명 중 순위 | 1 / 1 | 1 / 1 | 1 / 1 | — |
| 코퍼스 | 조건 | 중앙값 ρ | 평균 ρ | 평균 − 중앙값 ρ [95% CI] | 중앙값 r | 평균 r | 평균 − 중앙값 r [95% CI] |
|---|---|---|---|---|---|---|---|
| KorSTS | 루브릭 없음 | 0.827 | 0.859 | +0.032 [+0.024, +0.041] | 0.834 | 0.860 | +0.026 [+0.019, +0.033] |
| KorSTS | 루브릭 | 0.852 | 0.876 | +0.024 [+0.016, +0.032] | 0.854 | 0.876 | +0.022 [+0.017, +0.028] |
| KLUE-STS | 루브릭 없음 | 0.856 | 0.882 | +0.026 [+0.013, +0.039] | 0.817 | 0.843 | +0.026 [+0.015, +0.036] |
| KLUE-STS | 루브릭 | 0.872 | 0.890 | +0.018 [+0.005, +0.034] | 0.846 | 0.872 | +0.026 [+0.017, +0.037] |
| STS-B | 루브릭 없음 | 0.859 | 0.895 | +0.037 [+0.022, +0.051] | 0.862 | 0.885 | +0.022 [+0.012, +0.033] |
| STS-B | 루브릭 | 0.866 | 0.912 | +0.046 [+0.033, +0.060] | 0.875 | 0.905 | +0.030 [+0.022, +0.039] |
| 가설 | 항목 | 루브릭 | KorSTS ρ / r | KLUE-STS ρ / r | STS-B ρ / r |
|---|---|---|---|---|---|
| 가설 1 | 배심원 상관 | 루브릭 없음 | 0.859 [0.840, 0.875] / 0.860 [0.843, 0.874] | 0.882 [0.859, 0.898] / 0.843 [0.822, 0.860] | 0.895 [0.871, 0.912] / 0.885 [0.865, 0.900] |
| 가설 1 | 배심원 − 최고 단일 | 루브릭 없음 | +0.045 [+0.033, +0.056] / +0.036 [+0.026, +0.045] | +0.039 [+0.018, +0.060] / +0.015 [+0.000, +0.033] | +0.021 [+0.009, +0.034] / +0.005 [−0.006, +0.015] |
| 가설 1 | 배심원 상관 | 루브릭 | 0.876 [0.859, 0.888] / 0.876 [0.861, 0.888] | 0.890 [0.870, 0.907] / 0.872 [0.857, 0.888] | 0.912 [0.894, 0.926] / 0.905 [0.888, 0.919] |
| 가설 1 | 배심원 − 최고 단일 | 루브릭 | +0.044 [+0.032, +0.058] / +0.048 [+0.037, +0.059] | +0.033 [+0.017, +0.052] / +0.029 [+0.017, +0.043] | +0.034 [+0.022, +0.045] / +0.020 [+0.008, +0.032] |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 낮은 구간 | 루브릭 없음 | +0.128 [+0.090, +0.170] / +0.077 [+0.048, +0.109] | −0.025 [−0.107, +0.050] / +0.080 [+0.011, +0.153] | +0.132 [+0.062, +0.211] / +0.120 [+0.061, +0.181] |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 낮은 구간 | 루브릭 없음 | +0.074 [+0.063, +0.085] / +0.076 [+0.068, +0.084] | +0.066 [+0.041, +0.086] / +0.074 [+0.058, +0.090] | +0.076 [+0.056, +0.098] / +0.074 [+0.059, +0.093] |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 중간 구간 | 루브릭 없음 | +0.071 [+0.026, +0.120] / +0.073 [+0.026, +0.125] | +0.038 [−0.040, +0.135] / +0.002 [−0.090, +0.104] | −0.015 [−0.078, +0.042] / −0.020 [−0.082, +0.040] |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 중간 구간 | 루브릭 없음 | +0.091 [+0.073, +0.109] / +0.088 [+0.075, +0.102] | +0.114 [+0.073, +0.152] / +0.102 [+0.062, +0.146] | +0.093 [+0.057, +0.126] / +0.091 [+0.070, +0.115] |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 높은 구간 | 루브릭 없음 | +0.100 [+0.053, +0.146] / +0.067 [+0.022, +0.116] | +0.355 [+0.196, +0.523] / +0.007 [−0.053, +0.088] | +0.140 [+0.075, +0.208] / +0.079 [+0.032, +0.127] |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 높은 구간 | 루브릭 없음 | +0.135 [+0.112, +0.159] / +0.088 [+0.060, +0.117] | +0.200 [+0.101, +0.295] / +0.145 [+0.096, +0.210] | +0.176 [+0.136, +0.218] / +0.124 [+0.104, +0.144] |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 불일치 낮음 | 루브릭 없음 | — | +0.014 [−0.009, +0.037] / −0.002 [−0.019, +0.018] | — |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 불일치 낮음 | 루브릭 없음 | — | +0.031 [+0.014, +0.049] / +0.036 [+0.030, +0.044] | — |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 불일치 중간 | 루브릭 없음 | — | +0.069 [+0.026, +0.119] / +0.036 [+0.004, +0.068] | — |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 불일치 중간 | 루브릭 없음 | — | +0.063 [+0.037, +0.087] / +0.073 [+0.061, +0.085] | — |
| 가설 1, 난이도 층 | 배심원 − 최고 단일, 불일치 높음 | 루브릭 없음 | — | +0.032 [−0.030, +0.090] / +0.035 [−0.019, +0.094] | — |
| 가설 1, 난이도 층 | 배심원 − 개별 평균, 불일치 높음 | 루브릭 없음 | — | +0.073 [+0.045, +0.098] / +0.084 [+0.067, +0.103] | — |
| 가설 2 | 루브릭 효과, 개별 평균 | — | +0.013 [+0.006, +0.020] / +0.005 [−0.000, +0.011] | +0.016 [+0.009, +0.024] / +0.026 [+0.018, +0.035] | +0.023 [+0.014, +0.031] / +0.018 [+0.012, +0.025] |
| 가설 2 | 루브릭 효과, 배심원 | — | +0.016 [+0.010, +0.022] / +0.016 [+0.011, +0.021] | +0.008 [−0.001, +0.017] / +0.029 [+0.019, +0.039] | +0.017 [+0.008, +0.025] / +0.020 [+0.014, +0.026] |
| 가설 3 | 무작위 앵커 효과, 개별 평균 | 루브릭 없음 | −0.086 [−0.101, −0.073] / −0.084 [−0.097, −0.072] | −0.073 [−0.092, −0.054] / −0.055 [−0.074, −0.036] | −0.027 [−0.039, −0.014] / −0.024 [−0.034, −0.014] |
| 가설 3 | 무작위 앵커 효과, 배심원 | 루브릭 없음 | −0.053 [−0.068, −0.039] / −0.044 [−0.056, −0.031] | −0.050 [−0.070, −0.032] / −0.027 [−0.046, −0.009] | −0.011 [−0.022, +0.000] / +0.001 [−0.008, +0.008] |
| 가설 3 | 무작위 앵커 효과, 개별 평균 | 루브릭 | −0.065 [−0.076, −0.055] / −0.064 [−0.074, −0.054] | −0.039 [−0.051, −0.027] / −0.035 [−0.048, −0.022] | −0.013 [−0.021, −0.005] / −0.013 [−0.021, −0.006] |
| 가설 3 | 무작위 앵커 효과, 배심원 | 루브릭 | −0.039 [−0.050, −0.029] / −0.029 [−0.039, −0.019] | −0.023 [−0.037, −0.008] / −0.013 [−0.025, −0.000] | −0.004 [−0.014, +0.005] / +0.002 [−0.005, +0.009] |
| 가설 4 | 1라운드 대비 배심원 변화: 자기 재검토 | 루브릭 없음 | −0.007 [−0.010, −0.003] / −0.004 [−0.007, −0.001] | −0.005 [−0.014, +0.002] / +0.002 [−0.003, +0.007] | −0.003 [−0.010, +0.003] / +0.004 [+0.000, +0.009] |
| 가설 4 | 1라운드 대비 배심원 변화: 점수만 공유 | 루브릭 없음 | −0.020 [−0.025, −0.014] / −0.015 [−0.019, −0.011] | −0.021 [−0.032, −0.009] / −0.016 [−0.024, −0.010] | −0.025 [−0.036, −0.015] / −0.018 [−0.025, −0.012] |
| 가설 4 | 1라운드 대비 배심원 변화: 점수+근거 공유 | 루브릭 없음 | −0.013 [−0.018, −0.008] / −0.016 [−0.020, −0.012] | −0.025 [−0.038, −0.012] / −0.031 [−0.042, −0.020] | −0.031 [−0.043, −0.020] / −0.025 [−0.031, −0.019] |
| 가설 4 | 1라운드 대비 배심원 변화: 자기 재검토 | 루브릭 | −0.004 [−0.008, −0.000] / −0.002 [−0.005, +0.001] | −0.000 [−0.008, +0.008] / +0.001 [−0.005, +0.007] | −0.006 [−0.013, +0.001] / −0.003 [−0.007, +0.001] |
| 가설 4 | 1라운드 대비 배심원 변화: 점수만 공유 | 루브릭 | −0.007 [−0.012, −0.003] / −0.012 [−0.016, −0.008] | −0.014 [−0.025, −0.003] / −0.024 [−0.030, −0.018] | −0.013 [−0.021, −0.006] / −0.015 [−0.020, −0.010] |
| 가설 4 | 1라운드 대비 배심원 변화: 점수+근거 공유 | 루브릭 | −0.017 [−0.022, −0.011] / −0.020 [−0.024, −0.015] | −0.023 [−0.035, −0.012] / −0.030 [−0.037, −0.021] | −0.027 [−0.038, −0.017] / −0.023 [−0.030, −0.018] |
| 문항 | 손상 | 길이 변화 |
|---|---|---|
| stsb-0049 | 뒤따르는 7줄이 문장 2에 붙음 | 75 → 1,871자 |
| stsb-0322 | 뒤따르는 11줄이 문장 2에 붙음 | 135 → 2,405자 |
| stsb-0279 | 뒤따르는 줄이 문장 2에 붙음 | 87 → 244자 |
| stsb-0361 | 두 문장이 필드 1에, 문장 2 비어 있음 | 문장 2: 0자 |
재현 패키지는 원고 v15 기준으로 다시 만들어 OSF에 기탁할 예정이다(08 계획). 이전 판(원고 v10, 13개 평균 배심원 기준) 패키지: repro_package_v10.zip (18 MB). API 키와 서버 정보는 포함하지 않는다.
09-16 · 서열상관 재분석
지표를 정확일치 → 스피어만 ρ(피어슨 병기), 배심원을 중앙값 → 평균으로 바꿔 7모델 판정을 다시 계산. 등급 변환 불일치·STS-B 손상 4문항 확인. 정답+1 앵커 폐기, 무작위 앵커 결과 정리.
09-17 · 6모델 추가 → 후보 13모델
solar-pro4·GLM-5.3-Flash·Kimi-K2.6·gemma-3-27b·DeepSeek-V4-Flash·Qwen3.5-9B 판정 58,752건 수집(4조건).
09-18~23 · 의견 교환 실험·원고 v10·포털 v10
13모델 델파이 2~3라운드(133,835건), 원고 v10(13개 평균 배심원, 조합 전수 탐색), 발표 자료, 포털 v10.
09-28~30 · 원고 v11~v13
모든 차이에 문항 단위 부트스트랩 95% 구간(p값 대신), 3라운드 삭제.
09-30 · 통제 조건 실험
다시 묻는 효과와 남의 답을 보는 효과를 나누려고 자기 재검토·점수만 공유 조건을 13모델로 수집(69,394건, 재수집 점검 포함).
10-01~02 · 배심원 재설계 (상위 k → 9개)
배심원을 '성적 순 상위 k개'로 바꾸고 홀수·세 코퍼스 평균 규칙으로 9개 확정. 의견 교환을 9개끼리만 다시 수집(점수만·점수+근거, 43,992건). 7개끼리 공유 자료(34,216건)는 9개로 정하며 쓰지 않음.
10-06 · 루브릭 조건 통제 실험 · 9개 기준 재계산
루브릭 있는 자기 재검토·점수만·점수+근거 공유(65,987건). 가설 1~4 표·그림을 9개 배심원으로 다시 계산, 네 가설 전부의 피어슨을 부록에.
10-06~07 · 원고 v14·v15
13개 중 상위 9개 배심원으로 전면 재작성, 표 10·그림 6, 3.2절 후보 모델 구성 근거, 2.4절 선행연구 교체(Liang 2024 오인용 수정 등), 참고문헌 43편.
10-07 · 포털 v15 개편
이 페이지. 00~09를 원고 v15로 다시 쓰고 v10 포털을 11절에 보존.
앞으로 할 것
분석과 원고는 v15까지 왔다. 남은 것은 교수님 확인과 투고 절차다.
교수님께 여쭐 것 세 가지
(1) 13개 조합 전수 탐색 결과(최고 단일 모델을 넘는 조합 98 / 92 / 86%)를 한 문장 남길지 (2) 표 3에서 10개(짝수)가 9개보다 근소하게 높은 점(0.8795 vs 0.8789)을 한 구절로 밝힐지 (3) 배심원을 고른 자료와 가설 1을 시험한 자료가 같다는 한계를 한 문장으로 밝힐지(고를 때 쓰지 않은 루브릭 조건에서도 차이가 비슷했다는 근거와 함께).
제목 확정 (교수님 상의)
가제 「LLM Juries and Human Similarity Ratings: Aggregation, Rubrics, Random Anchors and Deliberation」. 확정되면 원고·제목 페이지·이 포털을 한 번에 고친다.
재현 패키지 v15 · OSF 기탁
판정 303,055건·프롬프트·코드·결과를 v15 기준으로 묶어 OSF에 올리고 익명 열람 링크를 원고에 넣는다.
저자 정보·선언문·투고
제목 페이지, 이해관계·AI 사용 선언, 커버레터. Information Processing & Management (SCIE/SSCI). 국문 논문은 쓰지 않는다(2026-09-02 결정).
참고문헌 (원고 v15, 43편)
APA 7판 형식, 영문 알파벳순. 원고 본문에서 인용한 문헌만 남겼다.
- Agirre, E., Cer, D., Diab, M., & Gonzalez-Agirre, A. (2012). SemEval-2012 Task 6: A pilot on semantic textual similarity. Proceedings of the First Joint Conference on Lexical and Computational Semantics (*SEM 2012), 385–393. https://aclanthology.org/S12-1051
- Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
- Bavaresco, A., Bernardi, R., Bertolazzi, L., Elliott, D., Fernández, R., Gatt, A., Ghaleb, E., Giulianelli, M., Hanna, M., Koller, A., Martins, A., Mondorf, P., Neplenbroek, V., Pezzelle, S., Plank, B., Schlangen, D., Suglia, A., Surikuchi, A. K., Takmaz, E., & Testoni, A. (2025). LLMs instead of human judges? A large scale empirical study across 20 NLP evaluation tasks. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 2: Short Papers), 238–255. https://doi.org/10.18653/v1/2025.acl-short.20
- Calderon, N., Reichart, R., & Dror, R. (2025). The alternative annotator test for LLM-as-a-judge: How to statistically justify replacing human annotators with LLMs. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 16051–16081. https://doi.org/10.18653/v1/2025.acl-long.782
- Cer, D., Diab, M., Agirre, E., Lopez-Gazpio, I., & Specia, L. (2017). SemEval-2017 Task 1: Semantic textual similarity multilingual and crosslingual focused evaluation. Proceedings of the 11th International Workshop on Semantic Evaluation (SemEval-2017), 1–14. https://doi.org/10.18653/v1/S17-2001
- Chan, C.-M., Chen, W., Su, Y., Yu, J., Xue, W., Zhang, S., Fu, J., & Liu, Z. (2024). ChatEval: Towards better LLM-based evaluators through multi-agent debate. The Twelfth International Conference on Learning Representations (ICLR 2024). https://proceedings.iclr.cc/paper_files/paper/2024/hash/25cc3adf8c85f7c70989cb8a97a691a7-Abstract-Conference.html
- Chen, G. H., Chen, S., Liu, Z., Jiang, F., & Wang, B. (2024). Humans or LLMs as the judge? A study on judgement bias. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 8301–8327. https://doi.org/10.18653/v1/2024.emnlp-main.474
- Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement with provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Dalkey, N., & Helmer, O. (1963). An experimental application of the Delphi method to the use of experts. Management Science, 9(3), 458–467. https://doi.org/10.1287/mnsc.9.3.458
- Dietrich, F., & Spiekermann, K. (2023). Jury theorems. In E. N. Zalta & U. Nodelman (Eds.), The Stanford Encyclopedia of Philosophy (Spring 2023 ed.). https://plato.stanford.edu/archives/spr2023/entries/jury-theorems/
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning (ICML 2024), PMLR 235, 11733–11763. https://proceedings.mlr.press/v235/du24e.html
- Estornell, A., & Liu, Y. (2024). Multi-LLM debate: Framework, principals, and interventions. Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://proceedings.neurips.cc/paper_files/paper/2024/hash/32e07a110c6c6acf1afbf2bf82b614ad-Abstract-Conference.html
- Fasolo, B., Heard, C., & Scopelliti, I. (2025). Mitigating cognitive bias to improve organizational decisions: An integrative review, framework, and research agenda. Journal of Management, 51(6), 2182–2211. https://doi.org/10.1177/01492063241287188
- Fu, X., & Liu, W. (2025). How reliable is multilingual LLM-as-a-judge? Findings of the Association for Computational Linguistics: EMNLP 2025, 11040–11053. https://doi.org/10.18653/v1/2025.findings-emnlp.587
- Galton, F. (1907). Vox populi. Nature, 75(1949), 450–451. https://doi.org/10.1038/075450a0
- Gu, J., Jiang, X., Shi, Z., Tan, H., Zhai, X., Xu, C., Li, W., Shen, Y., Ma, S., Liu, H., Wang, S., Zhang, K., Wang, Y., Gao, W., Ni, L., & Guo, J. (2024). A survey on LLM-as-a-judge. arXiv. https://doi.org/10.48550/arXiv.2411.15594
- Ham, J., Choe, Y. J., Park, K., Choi, I., & Soh, H. (2020). KorNLI and KorSTS: New benchmark datasets for Korean natural language understanding. Findings of the Association for Computational Linguistics: EMNLP 2020, 422–430. https://doi.org/10.18653/v1/2020.findings-emnlp.39
- Huang, J., Chen, X., Mishra, S., Zheng, H. S., Yu, A. W., Song, X., & Zhou, D. (2024). Large language models cannot self-correct reasoning yet. The Twelfth International Conference on Learning Representations (ICLR 2024). https://arxiv.org/abs/2310.01798
- Jiang, D., Ren, X., & Lin, B. Y. (2023). LLM-Blender: Ensembling large language models with pairwise ranking and generative fusion. Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14165–14178. https://doi.org/10.18653/v1/2023.acl-long.792
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning (ICML 2025), PMLR 267. https://doi.org/10.48550/arXiv.2506.07962
- Kim, S., Shin, J., Cho, Y., Jang, J., Longpre, S., Lee, H., Yun, S., Shin, S., Kim, S., Thorne, J., & Seo, M. (2024). Prometheus: Inducing fine-grained evaluation capability in language models. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://doi.org/10.48550/arXiv.2310.08491
- Kohli, G. S. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv. https://doi.org/10.48550/arXiv.2605.29800
- Li, D., Jiang, B., Huang, L., Beigi, A., Zhao, C., Tan, Z., Bhattacharjee, A., Jiang, Y., Chen, C., Wu, T., Shu, K., Cheng, L., & Liu, H. (2025). From generation to judgment: Opportunities and challenges of LLM-as-a-judge. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, 2757–2791. https://doi.org/10.18653/v1/2025.emnlp-main.138
- Li, Z., Wang, C., Ma, P., Wu, D., Wang, S., Gao, C., & Liu, Y. (2024). Split and merge: Aligning position biases in LLM-based evaluators. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 11084–11108. https://doi.org/10.18653/v1/2024.emnlp-main.621
- Liu, Y., Iter, D., Xu, Y., Wang, S., Xu, R., & Zhu, C. (2023). G-Eval: NLG evaluation using GPT-4 with better human alignment. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, 2511–2522. https://doi.org/10.18653/v1/2023.emnlp-main.153
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. https://doi.org/10.1073/pnas.1008636108
- Morreau, M. (2021). Democracy without enlightenment: A jury theorem for evaluative voting. Journal of Political Philosophy, 29(2), 188–210. https://doi.org/10.1111/jopp.12226
- Muennighoff, N., Tazi, N., Magne, L., & Reimers, N. (2023). MTEB: Massive text embedding benchmark. Proceedings of the 17th Conference of the European Chapter of the Association for Computational Linguistics, 2014–2037. https://doi.org/10.18653/v1/2023.eacl-main.148
- Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. Advances in Neural Information Processing Systems, 37, 68772–68802. https://doi.org/10.52202/079017-2197
- Park, S., Moon, J., Kim, S., Cho, W. I., Han, J., Park, J., Song, C., Kim, J., Song, Y., Oh, T., Lee, J., Oh, J., Lyu, S., Jeong, Y., Lee, I., Seo, S., Lee, D., Kim, H., Lee, M., … Cho, K. (2021). KLUE: Korean Language Understanding Evaluation. Proceedings of the Neural Information Processing Systems Track on Datasets and Benchmarks 1 (NeurIPS Datasets and Benchmarks 2021). https://doi.org/10.48550/arXiv.2105.09680
- Romaniega, Á. (2022). On the probability of the Condorcet Jury Theorem or the miracle of aggregation. Mathematical Social Sciences, 119, 41–55. https://doi.org/10.1016/j.mathsocsci.2022.06.002
- Rowe, G., & Wright, G. (1996). The impact of task characteristics on the performance of structured group forecasting techniques. International Journal of Forecasting, 12(1), 73–89. https://doi.org/10.1016/0169-2070(95)00658-3
- Saito, K., Wachi, A., Wataoka, K., & Akimoto, Y. (2023). Verbosity bias in preference labeling by large language models. arXiv. https://doi.org/10.48550/arXiv.2310.10076
- Schoenegger, P., Tuminauskaite, I., Park, P. S., Valdece Sousa Bastos, R., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
- Sclar, M., Choi, Y., Tsvetkov, Y., & Suhr, A. (2024). Quantifying language models' sensitivity to spurious features in prompt design or: How I learned to start worrying about prompt formatting. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://doi.org/10.48550/arXiv.2310.11324
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Towards understanding sycophancy in language models. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://doi.org/10.48550/arXiv.2310.13548
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- Verga, P., Hofstätter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv. https://doi.org/10.48550/arXiv.2404.18796
- Wang, A., Singh, A., Michael, J., Hill, F., Levy, O., & Bowman, S. R. (2019). GLUE: A multi-task benchmark and analysis platform for natural language understanding. International Conference on Learning Representations (ICLR 2019). https://openreview.net/forum?id=rJ4km2R5t7
- Wang, Y., Tao, S., Xie, N., Yang, H., Baldwin, T., & Verspoor, K. (2023). Collective human opinions in semantic textual similarity. Transactions of the Association for Computational Linguistics, 11, 997–1013. https://doi.org/10.1162/tacl_a_00584
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, 36, 46595–46623. https://doi.org/10.52202/075280-2020
교수님과의 의논
교수님 피드백을 받을 때마다 확인한 사실과 다시 계산한 결과를 날짜별로 남긴다. 정해진 내용은 본문(03 가설·04 방법·06 결과)과 원고(현재 v15)에 반영했고, 여기에는 이력과 상세 페이지를 둔다.
- 2026-09-16 (17·18일 갱신) · 교수님 질문 아홉 개에 대한 답 — 서열상관으로 다시 본 배심원.v10 이후 설계의 출발점
지표를 정확일치에서 사람 연속 점수와의 서열상관(스피어만·피어슨)으로, 배심원을 중앙값에서 평균으로 바꾸어 다시 계산했다. 등급 변환 규칙 불일치와 STS-B 손상 4문항을 확인했고, 앵커는 정답+1이었음을 답하며 무작위 앵커 결과를 붙였다. 조합 탐색과 교차코퍼스 검증, 난이도 층을 담았고, 17일에 후보 6모델 판정 58,752건을 받아 13모델 조합 재탐색 결과를 4번·8번에 더했다. 18일에는 교수님이 제안하신 상호정보 교환 앵커(가설 4)를 13모델 델파이 라운드(133,835건)로 실험해 10번 절로 더했다. 열기 → - 2026-09-12 ~ 14 · 첫 피드백("결론이 원하던 것과 다르다") 이후의 추가 분석.v7 기준 · 보정 부분은 v10에서 제외
정확일치 기준에서 배심원이 진 원인(공통 위쪽 치우침)을 찾고 분위수 보정과 무작위 앵커 재실험을 정리했다. 서열상관으로 지표가 바뀌면서 보정은 원고에서 빠졌고, 무작위 앵커 부분만 가설 3으로 이어졌다. 열기 →
이전 포털·해설·노트 (보존)
설계가 바뀌기 전에 쓴 페이지들이다. 결론이나 수치가 지금과 다르지만 연구가 어떻게 바뀌어 왔는지를 보여 주므로 지우지 않고 그대로 둔다. 링크는 예전 그대로 열린다.
포털 v10 · 2026-09-23 ~ 10-06의 첫 화면
독립적으로 투표하면, 배심원은 최고의 심판을 넘는다 (v10 포털)
원고 v10 기준. 13개 평균 배심원, 조합 8,191개 전수 탐색·합의 조합·저가 조합, 13개 공유 델파이 2~3라운드.
열기 →
포털 v7 · 2026-09-18까지의 첫 화면
LLM 배심원 연구 (v7 포털)
7모델·정확일치·중앙값 투표 기준의 00~10절 전체. 다국면 Rasch, 등급별 배심원 이득, 개별 모델 정확일치 표가 여기에 있다.
열기 →
논문 해설 노트 · 2026-09-09
LLM 배심원을 어떻게 사용해야 할까? — 난이도·루브릭·앵커로 본 중앙값 투표의 조건
원고 v7 「Do LLM Juries Beat Their Own Members?」의 논리를 12개 절로 푼 해설. H1 기각·H2 지지·H3 부분 지지.
열기 →
추가 분석 노트 · 2026-09-14
배심원을 살리는 조건 — 치우침을 빼고, 앵커를 정답과 떼어 놓으면
배심원이 진 이유(공통 위쪽 치우침)와 분위수 보정, 무작위 앵커 재실험. 무작위 앵커는 가설 3으로 이어졌고 보정은 v10에서 제외.
열기 →
교수님과의 의논 · 2026-09-16~18
교수님 질문 아홉 개에 대한 답 — 서열상관으로 다시 본 배심원
v7에서 v10으로 넘어온 근거 전부. 질문 (1)~(9)별 표·그래프, 13모델 조합, 가설 4 델파이 실험.
열기 →
v10 → v15에서 바뀐 것
- 배심원 13개 전체 평균 → 13개 후보 중 기본 조건 성적 상위 9개의 평균 (홀수, 세 코퍼스 평균 규칙)
- 크기·조합 8,191개 조합 전수 탐색·합의 조합·코퍼스 교차 검증·저가 조합 → 성적 순 상위 k개 크기 곡선 하나
- 의견 교환 13개 공유 2~3라운드 → 9개끼리, 1라운드 뒤 자기 재검토 / 점수만 공유 / 점수+근거 공유, 루브릭 유무 모두 (3라운드 삭제)
- 통계 모든 차이에 쌍 부트스트랩 95% 구간, 네 가설 전부의 피어슨을 부록에, 평균 대 중앙값은 부록으로
- 결론 가설 1·4는 그대로 지지. 가설 2·3의 배심원 효과는 세 코퍼스 중 둘에서만 구간이 0을 비껴감. 의견 교환의 하락은 다시 묻기가 아니라 남의 점수를 보는 데서 옴
v7 → v10에서 바뀐 것
- 지표 반올림 등급과의 정확일치 → 사람 연속 점수와의 스피어만 ρ (피어슨 병기)
- 집계 중앙값 투표 → 평균 집계 (중앙값은 비교용)
- 앵커 정답+1 (정답 누설) → 문항 씨앗 무작위 1~5
- 모델 7개 → 13개 (개발사 9곳)
- 가설 난이도–이득(H1)·루브릭(H2)·앵커+완화(H3) → 배심원(1)·루브릭(2)·무작위 앵커(3)·의견 교환(4). 난이도는 탐색적 분석으로
- 결론 "중앙값 투표는 개별 모델을 못 이긴다" → "따로 묻고 평균하면 배심원은 최고 단일 모델을 넘는다"