포털뉴스 매체 간 부정 보도의 동조와 복제
의미 임베딩과 LLM 배심원을 이용한 정량 분석 — 다섯 건의 기업 위기 사건을 중심으로
연구보고서(확장본)
최형규 · 김다혜 · 김효영 · 박대근(교신)
차의과학대학교 일반대학원 AI헬스케어융합학과 · 김다혜 변호사 법률사무소 · 한국공학대학교 인공지능학과
본 보고서는 학술지 게재본 「의미 임베딩과 LLM 배심원 기반 매체 간 부정 보도 동조와 복제 탐지: 기업 위기 사건을 중심으로」의 확장본이다. 논문이 지면의 제약 안에서 압축한 배경·방법·해석을 연구 기록의 수준으로 되살려, 분석의 설계 의도와 판단 근거, 그리고 개별 사례에서 실제로 관찰된 장면들을 상세히 풀어썼다. 매체명은 내부 검토를 위해 실명으로 표기하였으며, 외부 공개본(포털)에서는 동일한 내용을 매체 유형 코드로 익명화하여 제공한다.
요약
한국의 뉴스 이용자는 대부분 포털이라는 하나의 창을 통해 세상을 본다. 같은 사건을 다룬 여러 매체의 기사가 한 화면에 나란히 떠오르고, 이용자는 그 목록을 위에서 아래로 훑어 내리며 '무슨 일이 일어났는지'를 파악한다. 그런데 이 목록을 조금만 주의 깊게 들여다보면 이상한 점이 눈에 들어온다. 제목이 닮았고, 첫 문장이 닮았고, 때로는 본문의 문단 전체가 마치 복사한 듯 겹친다. 이 보고서는 바로 그 '닮음'의 정체를 묻는다.
닮음에는 서로 다른 층위가 있다. 같은 사건을 취재하면 기사가 어느 정도 비슷해지는 것은 자연스러운 일이다. 이를 우리는 수렴이라 부른다. 그러나 특정 국면에서 매체들의 보도가 평소보다, 그리고 다른 종류의 기사보다 유난히 더 비슷해진다면 이는 단순한 수렴을 넘어선 동조일 수 있다. 나아가 두 기사가 문장과 표현을 상당 부분 그대로 공유한다면, 그것은 각자 쓴 것이 아니라 본문을 옮긴 복제다. 이 세 층위를 뒤섞어 두면 "포털 기사는 원래 다 비슷하다"는 체념에서 논의가 멈춘다. 이 연구의 출발점은 세 층위를 분리해 각각을 정량적으로 측정하는 데 있다.
우리는 사건의 성격과 피해 유형이 서로 다른 다섯 건의 기업 위기 사건 — 고려아연 경영권 분쟁, 홈플러스 기업회생, 롯데카드 해킹·개인정보 유출, 남양유업 분쟁, 큐텐(티몬·위메프) 정산 지연 — 에 관한 포털 유통 기사 77,118편을 수집했다. 각 기사를 의미 임베딩으로 벡터화해 매체 간 유사도를 코사인으로 측정하고, 유사도가 높은 기사쌍은 서로 다른 다섯 개의 대형언어모델로 구성한 배심원과 연구자 다섯 명의 눈으로 복제 여부를 판정했다.
결과는 세 문장으로 요약된다. 첫째, 사건 이후 부정 기사의 매체 간 유사성은 사건 이전보다, 그리고 같은 시기의 중립·발표성 기사보다 선택적으로 상승했으며, 이 방향성은 다섯 사례에서 예외 없이 재현되었다. 둘째, 그 상승분 가운데 실제 본문 복제로 확인된 몫은 배심원 추정 13.9%, 연구자 검토로 보정하면 9.4%(애매한 사례까지 포함한 상한 10.2%)였다. 셋째, 본 보고서의 확장 분석(복제 클러스터)에 따르면 복제는 만연한 현상이라기보다 속보와 발표성 보도에 집중되는 양상을 보였다. 이 보고서는 이 세 결론에 이르는 길을 처음부터 끝까지, 논문보다 더 촘촘하게 되짚는다.
한눈에 보는 핵심 발견
1. 선택적 동조 — 사건 이후 매체 간 유사성은 부정 기사에서만 올랐다(사전 0.499 → 사후 0.556). 같은 시기 중립·발표성 보도는 통계적으로 변하지 않았다(0.436 → 0.442, 유의하지 않음). 사건은 모든 보도가 아니라 부정 보도만 서로 닮게 만들었다.
2. 다섯 사례 모두에서 재현 — 부정 기사의 동조가 중립·보도를 웃도는 방향은 성격이 전혀 다른 다섯 사건에서 예외 없이 나타났다. 이는 특정 사건의 특수성이 아니라 위기 보도의 구조적 양상임을 시사한다.
3. 복제율 9.4% — 유사성 가운데 실제 본문 복제로 확인된 몫은 배심원 추정 13.9%, 인간 보정 9.4%(상한 10.2%)였다. 열 편에 한 편꼴이다.
4. 복제는 속보에 집중(확장 분석) — 본 보고서의 복제 클러스터 분석(부록 D)에 따르면, 복제는 저널리즘 전반의 병리가 아니라 구속영장 청구·당국 발표·압수수색 같은 속보와 발표성 보도에 몰려 있었다. 하나의 속보가 아홉·열한 개 매체로 동시에 번지기도 했다.
5. 전국·경제 일간지가 진앙 — 매체 유형별로 보면 동조는 종합·경제 일간지에서 가장 강했다(유형 내 평균 0.568·0.559). 위기 보도의 '받아쓰기'는 이 중심부에서 가장 뚜렷했다.
1. 왜 '닮은 기사'를 문제 삼는가
1.1 하나의 창으로 세상을 보는 사회
한국언론진흥재단의 「언론수용자 조사」는 해가 갈수록 같은 방향을 가리킨다. 사람들은 개별 언론사의 지면이나 방송 편성표가 아니라 포털의 뉴스 화면을 통해 기사를 만난다. 이 구조에서 이용자가 접하는 정보의 다양성은 개별 매체의 논조가 아니라, 한 화면에 모인 기사들이 서로 얼마나 다르냐에 따라 결정된다. 열 개의 매체가 열 개의 서로 다른 관점을 제시한다면 이용자는 열 개의 창을 얻지만, 열 개의 매체가 사실상 같은 문장을 반복한다면 창은 하나로 줄어든다. 매체의 수가 곧 관점의 수는 아니라는 뜻이다.
이 문제를 조금 더 밀고 나가 보자. 흔히 언론의 다양성은 '매체의 수'로 이야기된다. 등록 매체가 수천 개에 이르니 한국의 언론 지형은 다원적이라는 식이다. 그러나 이용자의 실제 경험은 매체의 수가 아니라 한 화면에서 마주하는 기사들의 다름의 정도로 결정된다. 스무 개 매체가 같은 사건에 대해 사실상 하나의 문장을 반복한다면, 이용자가 체감하는 관점의 수는 스무 개가 아니라 하나에 가깝다. 다양성의 착시가 발생하는 것이다. 이 연구가 '매체 간 유사성'을 정면으로 계량하려는 이유가 여기에 있다. 유사성의 정도를 재야 비로소 '보이는 다양성'과 '실제 다양성'의 간극을 말할 수 있기 때문이다.
여기서 주의할 점이 하나 있다. 이 유사성을 포털이 '만들어 낸다'고 보는 것은 정확하지 않다. 포털은 여러 매체의 기사를 한자리에 모아 보여줄 뿐이며, 유사성 자체는 대체로 매체들이 공통의 취재원을 사용하거나 서로의 보도를 참조하는 과정에서 발생한다. 포털은 그 결과를 한 화면에 응축해 이용자의 눈앞에 펼쳐 놓는 장치다. 따라서 문제의 초점은 "포털이 유사성을 유발했는가"가 아니라, "이용자가 실제로 마주하는 화면 위에서 매체 간 보도가 얼마나, 어떤 국면에서 닮아지는가"에 맞춰져야 한다.
1.2 수렴, 동조, 복제 — 반드시 갈라 두어야 하는 세 층위
이 연구의 개념적 척추는 세 단어의 구분이다. 이 구분을 흐려 두면 이후의 모든 수치가 의미를 잃기 때문에, 다소 장황하더라도 처음부터 분명히 해 둔다.
수렴(convergence) 은 같은 사건을 취재하는 과정에서 자연스럽게 발생하는 유사성이다. 검찰이 구속영장을 청구하면 어느 매체가 쓰든 '구속영장', '특정경제범죄가중처벌법', '증거인멸 우려' 같은 표현이 등장할 수밖에 없다. 사실이 같으므로 기사가 닮는 것이다. 수렴은 그 자체로 문제가 아니라, 저널리즘이 같은 현실을 다룬다는 자연스러운 증거에 가깝다.
동조(synchronization) 는 그 자연스러운 수렴의 수준을 넘어서는 유사성이다. 핵심은 '비교'에 있다. 어떤 국면의 기사들이 평소보다, 또는 같은 시기의 다른 종류 기사보다 유난히 더 비슷하다면, 그 초과분이 바로 동조다. 동조는 절대적인 유사도 수치 하나로 판정할 수 없으며, 반드시 비교군을 세워 상대적 상승으로 확인해야 한다. 이 연구가 사건 이전 기사와 같은 시기의 중립·발표성 기사를 집요하게 비교군으로 끌어들이는 이유가 여기에 있다.
복제(copying) 는 유사성의 원인을 겨냥한다. 두 기사가 같은 사실을 각자 독립적으로 서술한 것인지, 아니면 한쪽의 본문을 다른 쪽이 옮겨 적은 것인지의 문제다. 복제는 의미가 비슷하다는 것만으로는 판정할 수 없다. 같은 사건을 다루면 의미는 당연히 비슷해지기 때문이다. 복제의 결정적 증거는 의미가 아니라 문장과 어휘의 축자적 겹침이다. 그래서 우리는 의미 임베딩으로 후보를 좁힌 뒤, 실제 본문을 대조해 복제를 가려낸다.
세 층위는 포개져 있지만 같지 않다. 수렴은 어디에나 있고, 동조는 특정 국면에서 도드라지며, 복제는 그중 일부에서 확인된다. 이 보고서의 두 연구 질문은 이 사다리의 두 번째와 세 번째 칸에 해당한다.
[RQ1] 동조 — 사건 이후 부정 기사의 매체 간 유사성은, 사건 이전의 부정 기사 및 같은 시기의 중립·발표성 기사보다 통계적으로 유의하게 증가하는가?
[RQ2] 복제 — 사건 이후 부정 기사에서 관측된 유사성은 독립적 보도의 결과인가, 본문을 옮긴 복제인가, 그리고 복제의 규모는 어느 정도인가?
1.3 학술적 물음이자 실무의 현안
이 물음은 상아탑 안에만 머물지 않는다. 네이버 뉴스제휴위원회가 2026년에 개편·시행한 「뉴스 제휴 심사 및 운영 평가 규정」은 개별 기사가 먼저 송고된 기존 기사와 문장 단위로 얼마나 겹치는지를 정량 지표로 삼는다. 그 비교 대상은 자사 기사에 국한되지 않고 다른 매체의 기사까지 포함한다. 즉 '매체를 넘어선 본문 겹침'은 이미 플랫폼의 제재 기준으로 제도화되어 있다. 그러나 이 규정은 개별 기사 쌍의 중복 여부를 가릴 뿐, 특정 사건의 보도 전체에서 관측되는 유사성이 자연스러운 수렴인지, 비정상적 동조인지, 본문 복제인지를 재현 가능한 절차로 구분하지는 못한다. 이 연구가 제안하는 것은 바로 그 절차다. 학술적으로는 매체 간 의제 설정과 받아쓰기(churnalism) 연구를 잇고, 실무적으로는 포털의 뉴스 품질 관리와 중복 노출 관리에 곧바로 쓸 수 있는 의사결정 도구를 지향한다.
2. 선행 연구 — 세 갈래의 흐름이 만나는 지점
이 연구는 세 갈래의 연구 전통이 교차하는 자리에 서 있다. 첫째는 문서의 의미적 유사성을 벡터로 측정해 온 자연어처리의 흐름이고, 둘째는 한국어 뉴스를 대상으로 주제와 매체 차이를 분석해 온 텍스트 마이닝의 흐름이며, 셋째는 포털 환경의 어뷰징과 받아쓰기를 다뤄 온 언론학의 흐름이다.
의미 임베딩의 발전. 단어의 표면적 일치를 넘어 문맥과 의미를 비교하려는 시도는 BERT가 문맥에 따라 달라지는 단어 의미를 벡터로 표현하면서 본격화되었다. 다만 BERT는 문장쌍을 함께 입력해야 해서 대규모 문서 간 유사도를 반복 계산하기에 비효율적이었고, Sentence-BERT가 각 문장을 독립된 벡터로 변환해 직접 비교하도록 하면서 이 병목을 풀었다. 이어 SimCSE는 대조 학습으로 문장 임베딩의 구분력을 높였고, BGE-M3는 100여 개 언어와 긴 문서를 지원하는 다기능 임베딩을 제시했다. 이러한 임베딩은 다국어 뉴스 군집화, 계층적·스트림 군집화, 나아가 국가 간 보도 동조 측정으로까지 응용 범위를 넓혀 왔다. 한편 정보검색 분야에서는 문자 n-gram의 중복으로 본문 재사용을 탐지하는 기법이 축적되었으며, Nicholls는 이 기법으로 보도자료·통신사·언론사 기사 사이의 본문 재사용을 대규모로 분석했다. 이 연구가 '의미 임베딩으로 후보를 좁히고 문자 n-gram으로 복제를 확인'하는 이중 구조를 택한 것은 이 두 전통을 결합한 결과다.
대형언어모델을 평가자로. 최근에는 대형언어모델을 텍스트 품질·관계의 평가자로 세우고 그 판정을 인간과 비교하는 연구가 이어졌다. 특정 조건에서 모델 평가가 인간 평가를 보완할 수 있다는 보고와, 모델 판정의 성능·편향을 분석한 연구가 나왔고, 서로 다른 모델의 판정을 결합한 배심원(jury) 방식이 단일 모델의 편향과 판단 변동을 줄일 수 있음이 제시되었다. 이 연구의 복제 판정이 하나의 모델에 기대지 않고 다섯 모델의 다수결을 쓰는 근거가 여기에 있다.
한국어 뉴스와 포털 어뷰징. 한국어 뉴스 텍스트 마이닝은 동시출현 네트워크, 토픽 모델링, 사회연결망 분석을 결합하며 주제 구조를 규명해 왔으나, 매체별 보도 비교는 대체로 서너 곳에서 여섯 곳 정도의 주요 일간지에 한정되는 경향이 있었다. 포털에 함께 유통되는 수십 개 매체를 한꺼번에 비교한 연구는 상대적으로 드물다. 한편 포털 어뷰징 연구는 매체 지위별 행태, 구체적 사례와 전문가 인식, 제도·기술적 개선 방안을 다뤘지만 일부 매체나 특정 사례에 집중되곤 했다. 이 연구는 다섯 사건과 아흔 개 매체를 함께 놓고, 보도의 전반적 유사성(동조)과 실제 본문 재사용(복제)을 분리해 정량화한다는 점에서 이들 흐름을 한 걸음 확장한다.
세 흐름을 관통하는 이 연구의 위치는 이렇게 정리할 수 있다. 임베딩 연구는 '유사성을 어떻게 잴 것인가'를, 배심원 연구는 '판정을 어떻게 신뢰할 것인가'를, 언론학의 받아쓰기 연구는 '왜 이런 현상이 생기는가'를 각각 다뤄 왔다. 그러나 이 셋을 하나의 파이프라인으로 엮어, 실제 위기 사건의 대규모 코퍼스에 적용하고, 그 결과를 재현 가능한 절차로 제시한 연구는 드물었다. 특히 국내 연구에서는 매체 간 유사성을 '수렴·동조·복제'의 층위로 명시적으로 구분해 각각을 측정한 사례를 찾기 어렵다. 이 보고서가 채우려는 공백이 바로 그 지점이다.
3. 데이터 — 다섯 개의 위기, 하나의 공통점
3.1 왜 이 다섯 사건인가
분석 대상은 단기간에 여러 매체의 보도가 집중된 다섯 건의 기업 위기 사건이다. 다섯 사건은 우연히 모인 것이 아니라 두 가지 기준으로 선정되었다. (1) 경영권 분쟁·기업회생·개인정보 유출·정산 지연처럼 사건의 성격과 피해 유형이 서로 다르고, (2) 짧은 기간에 보도가 폭발적으로 집중되어 동조·복제를 관찰하기에 충분한 밀도를 갖췄다는 점이다. 성격이 다른 사건을 함께 놓은 이유는, 만약 어떤 결론이 특정 사건 유형에만 나타난다면 그것은 사건의 특수성일 뿐이지만, 성격이 다른 다섯 사건에서 같은 방향이 재현된다면 그것은 사건을 관통하는 구조적 현상이라고 말할 수 있기 때문이다.
각 사건의 맥락은 다음과 같다. 공교롭게도 다섯 사건 가운데 넷(고려아연·홈플러스·롯데카드·남양유업)은 사모펀드가 인수자·투자자·분쟁 당사자의 형태로 얽혀 있는데, 이는 최근 대기업 위기 보도의 상당수가 사모펀드발(發) 재무·지배구조 이슈에서 비롯되는 현실과 무관하지 않다(큐텐은 예외로, 자체 경영진의 정산 지연에서 비롯됐다). 다만 사건 선정은 이 공통점이 아니라 위의 두 기준에 따랐으며, 분석 대상은 어디까지나 이 사건들에 관한 언론 보도의 내용과 관계이지 해당 기업의 행위나 책임을 평가하는 것이 아님을 거듭 분명히 해 둔다.
고려아연 (2024.09.13 공개매수 → 2025.01.23 임시주주총회). 국내 비철금속 산업의 핵심 기업을 둘러싸고 MBK파트너스·영풍 연합과 최윤범 회장 측이 벌인 경영권 분쟁이다. 공개매수와 자사주 맞대응, 임시주주총회 표 대결이 숨 가쁘게 이어지는 동안, 논쟁은 단순한 지분 다툼을 넘어 '외국 자본이 대거 출자한 사모펀드가 국가기간산업을 적대적으로 인수해도 되는가', '세계 3위 규모의 국민연금은 어떤 의결권을 행사해야 하는가'라는 공적 쟁점으로 번졌다. 재계와 정치권, 학계가 동시에 목소리를 내면서 보도량이 폭증했고, 뒤에서 보게 될 '국민연금 토론회 기사의 통째 복제'(5.5절)도 바로 이 국면에서 나왔다.
홈플러스 (2025.03.04 기업회생 신청 → 2025.12.29 회생계획안). 사모펀드 인수 이후 누적된 재무 부담이 기업회생 신청으로 터진 사건이다. 단기채권 사태, 신용등급 강등을 둘러싼 수사, 협력업체·임차료·직원 급여 문제, 경영진의 사기·배임 혐의 수사와 구속영장 청구가 꼬리를 물며 1년 넘게 이어지는 장기 국면을 형성했다. 다섯 사례 가운데 사후 기사 수(21,718편)가 가장 많은 것도 이 지속성 때문이다. 회생 절차의 매 고비마다 법원의 결정을 전하는 속보가 쏟아졌고, 그 상당수가 여러 매체에 사실상 같은 문장으로 실렸다.
롯데카드 (2025.08.14 전산 해킹 → 2025.09.18 개인정보 유출 확인). 대규모 해킹으로 고객의 개인정보와 함께, 주민등록번호를 대체하는 암호화 식별자인 '연계정보(CI)'까지 유출된 사건이다. 금융·통신 보안의 근간을 건드린 사안인 만큼 감독당국의 긴급 점검, 영업정지 사전통지, 국회 청문회로 파장이 확산됐다. 규제기관의 발표가 보도의 주된 소재였기 때문에, 당국의 보도자료가 여러 매체에 그대로 옮겨지는 전형적 국면(5.5절의 방통위 점검 사례)이 두드러졌다.
남양유업 (2024.01.04 대법원 확정). 2021년부터 이어진 지분매각 분쟁이 대법원 확정으로 일단락된 장기 사건이다. 그 뒤로도 전 회장의 200억 원대 횡령 의혹 수사가 이어졌다. 다섯 사례 가운데 유일하게 사전 기사 수가 사후보다 많은 사례인데, 이는 확정 이전의 분쟁 보도가 오래 누적된 데서 비롯된다. 사건 규모 자체는 다른 넷보다 작지만 복제율은 오히려 가장 높게(18.2%) 나타났는데, 이는 소수의 발표성 속보가 여러 매체에 그대로 퍼졌을 때 작은 분모 위에서 그 비중이 크게 잡히는 구조와 관련된다.
큐텐/티메프 (2024.07.22 정산 지연 선언 → 2025.11.13 위메프 파산). 티몬·위메프의 대규모 미정산이 촉발한 이른바 '티메프 사태'다. 1조 5,950억 원 규모의 정산대금 미지급, 판매자·소비자의 연쇄 피해, 검찰 수사와 구영배 큐텐 대표를 비롯한 경영진의 구속영장 청구로 이어지며 전 국민적 관심사가 됐다. 검찰 수사의 각 단계를 전하는 속보가 분 단위로 쏟아졌고, 그중 '구영배 구속영장 청구' 속보는 아홉 개 매체에 코사인 0.99로 사실상 동일하게 실렸다(5.5절).
3.2 수집 규모와 매체 범위
회사명과 핵심 행위자, 주요 사건어를 검색어로 사용해 사건 전후 기사 77,118편을 수집했다. 사례별 사전·사후 분포는 <표 1>과 같다. 남양유업을 제외한 네 사건은 모두 사후 기사가 사전보다 많으며, 이는 사건 발생과 함께 보도가 집중되는 전형적 양상이다.
<표 1> 사례별 사전·사후 기사 수
| 사례 | 사전 | 사후 | 합계 |
|---|---|---|---|
| 고려아연 | 4,533 | 17,605 | 22,138 |
| 홈플러스 | 10,341 | 21,718 | 32,059 |
| 롯데카드 | 3,325 | 5,282 | 8,607 |
| 남양유업 | 2,271 | 1,959 | 4,230 |
| 큐텐 | 2,767 | 7,317 | 10,084 |
| 합계 | 23,237 | 53,881 | 77,118 |
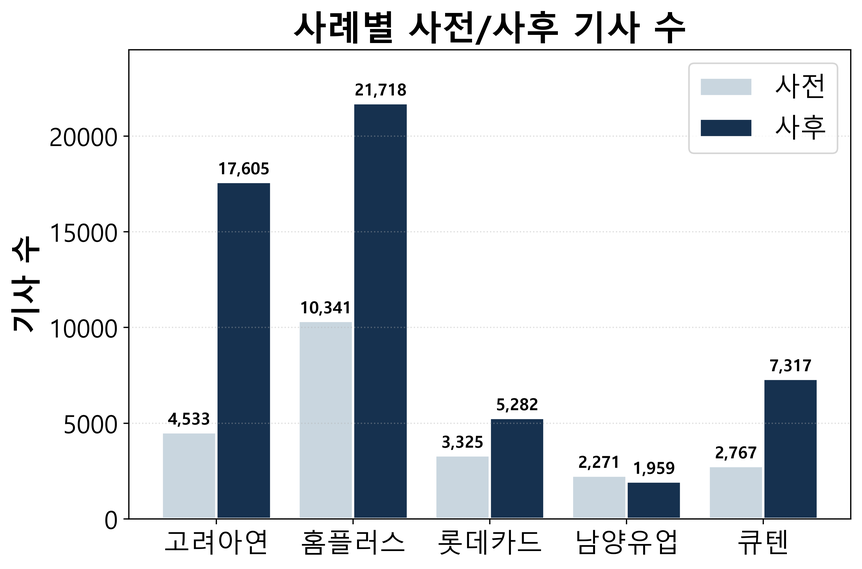
<그림 1> 사례별 사전·사후 기사 수(누적 막대)
매체 간 비교의 일관성을 위해 주요 매체를 일곱 유형 — 전국일간지·경제일간지·지역일간지·방송사·전문지·스포츠신문·인터넷신문 — 으로 구분하고, 이에 해당하는 90개 매체로 분석 범위를 한정했다. 통계적 안정성을 위해 해당 분석 구간에서 관련 기사가 두 편 미만인 매체는 지표 산출에서 제외했다. 본 보고서는 내부 검토용이므로 매체를 실명으로 표기하지만, 포털 공개본에서는 동일 내용을 일곱 유형 코드(A·B·C·E·F·G·H)로 익명화한다. 이는 특정 매체를 지목·낙인하기 위한 연구가 아니라 구조를 규명하기 위한 연구라는 취지를 지키기 위한 원칙이다.
3.3 관찰 기간과 비교 설계
각 사건이 발생해 보도가 본격화된 시점을 기준으로 사전과 사후를 나누었다. 검정은 사례 내부에서 사건 전후의 상대적 변화를 비교하는 방식으로 설계했으며, 사례를 통합할 때는 매체 평균을 관측 단위로 삼아 시점×유형의 2×2 상호작용을 검정했다. 관찰 기간의 절대 길이는 사례마다 다르지만, 동조는 같은 기간의 중립·보도를 대조로 한 상대적 차이이고 복제율은 사후 부정 기사 내부의 비율이므로, 기간 차이가 결론의 방향을 좌우할 여지는 제한적이다. 다만 동조의 강도가 시간에 따라 감소할 수 있다는 점에서, 동일 길이의 관찰 기간을 적용한 추가 검증은 후속 과제로 남겨 둔다.
4. 방법 — 수집에서 인간 검토까지
분석 절차는 적용 순서 그대로 여섯 단계로 이어진다. (1) 사건 관련성을 판정하고 기사 유형과 논조를 분류한 뒤, (2) 기사별 의미 임베딩과 매체 간 코사인 유사도를 산출하고, (3) 사람과 여러 모델의 판단으로 분류·임베딩·배심원의 타당성을 검토한다. 이어 (4) 시점과 유형을 교차해 동조를 측정하고, (5) 유사 기사쌍의 복제 여부를 판정한 뒤, (6) 인간 검토로 다시 확인한다. 이 장은 각 단계의 '무엇을'뿐 아니라 '왜 그렇게 했는가'를 함께 설명한다.
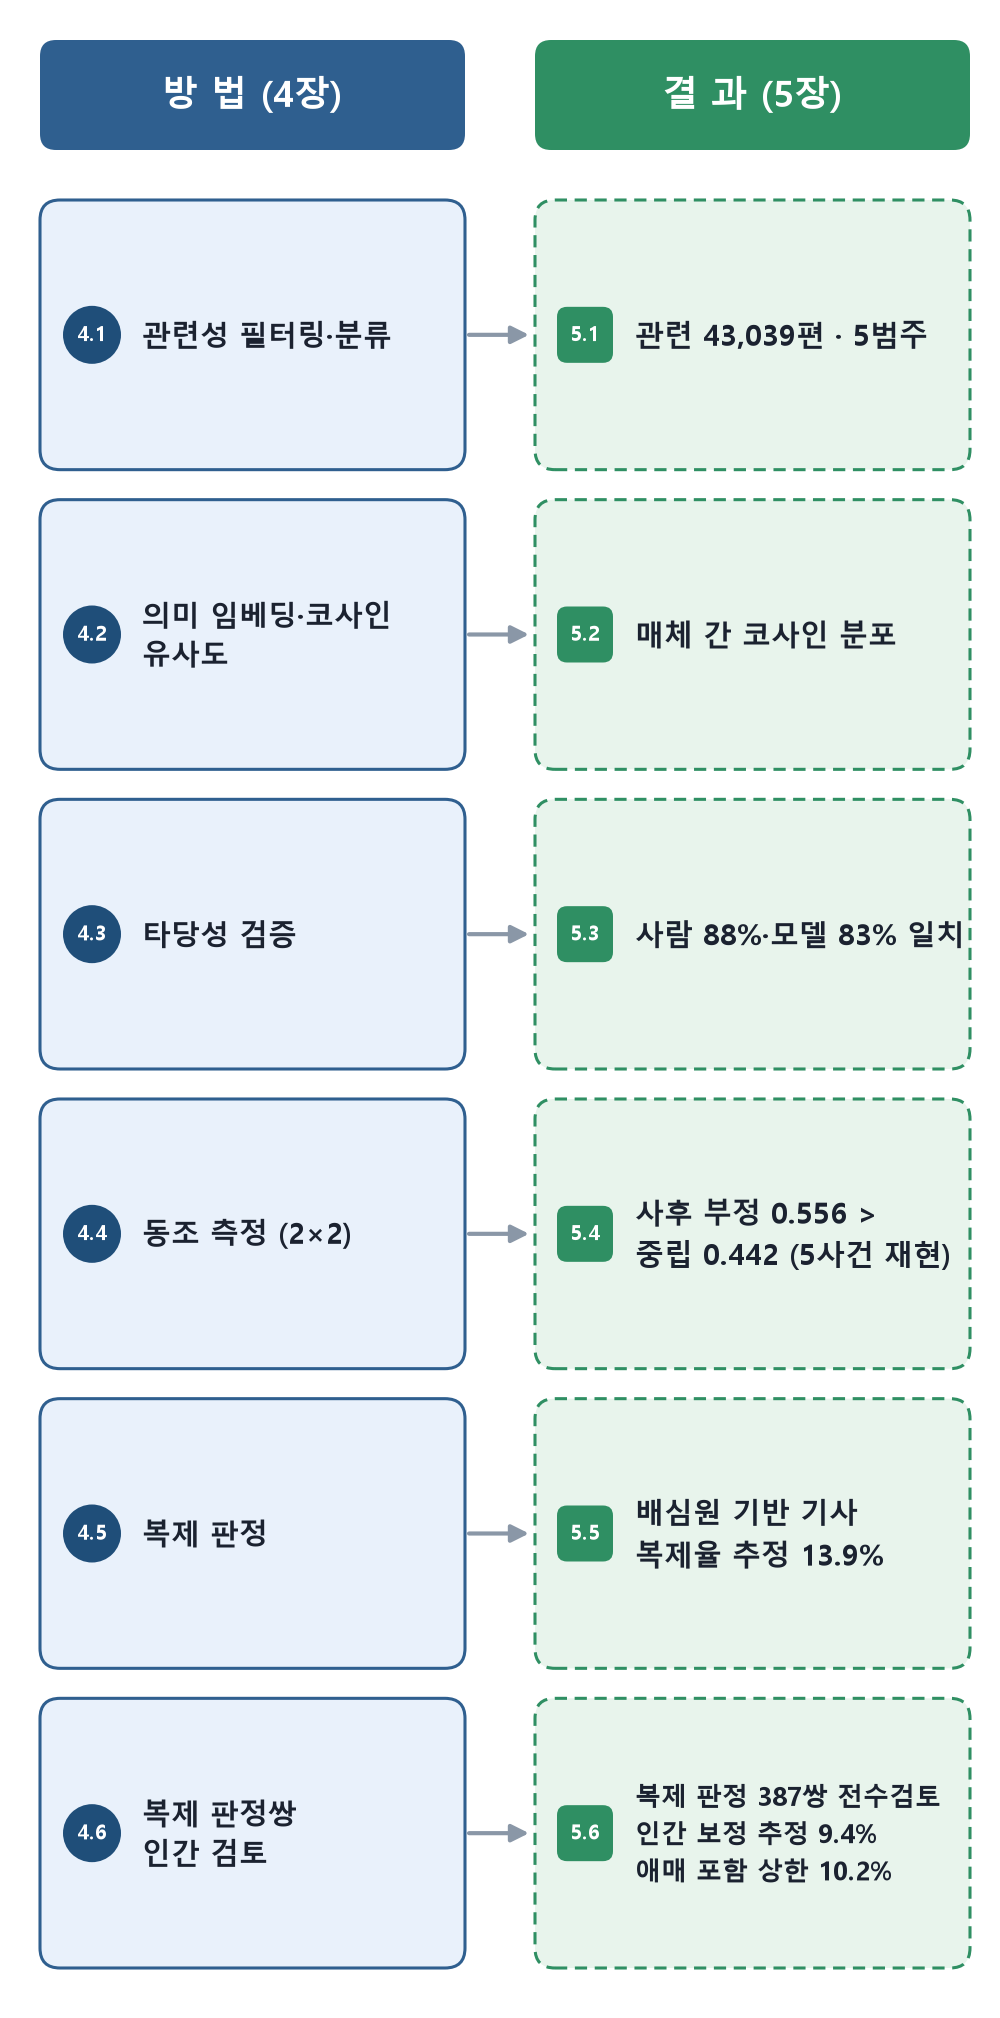
<그림 2> 연구 방법 개관
4.1 관련성 필터링과 다섯 범주 분류
회사명으로 기사를 폭넓게 수집하면 광고, 단신, 주가 목록, 동음이의어처럼 사건과 무관한 자료가 대거 섞인다. 예컨대 '큐텐'을 검색하면 건강기능식품 '코엔자임Q10' 기사가, '남양'을 검색하면 지명 '남양주' 기사가 딸려 온다. 그래서 먼저 사건 관련성을 판정해 무관 기사를 걷어 냈다. 관련 기사는 다시 유형에 따라 이슈 보도·발표성 보도기사·광고기사로 나누고, 이슈 보도에는 부정·중립·긍정의 논조를 부여했다. 두 기준을 결합하면 이슈-부정, 이슈-중립, 이슈-긍정, 보도기사, 광고기사의 다섯 범주가 만들어진다. 분류에는 gpt-4o-mini를 온도(temperature) 0으로 고정해 사용하고, 판정 결과를 저장해 이후 분석에 동일하게 적용함으로써 재현성을 확보했다. 동조·복제 분석의 주인공은 이슈-부정 기사이며, 같은 사후 구간의 중립·보도가 비교군, 광고는 건수만 집계하는 참고 범주다.
왜 하필 이슈-부정을 주 분석 대상으로 삼는가. 위기 사건에서 여론과 기업 가치에 실질적 영향을 주는 것은 부정적 프레임의 보도이며, 받아쓰기·동조가 사회적으로 문제되는 국면도 바로 이 대목이기 때문이다. 중립·발표성 보도를 비교군으로 세운 것은, '부정 기사만 유난히 닮아지는가, 아니면 모든 기사가 두루 닮아지는가'를 가르기 위해서다.
4.2 의미 임베딩과 코사인 유사도
각 기사의 제목과 본문은 OpenAI의 text-embedding-3-large를 이용해 3,072차원의 밀집 벡터로 변환했다. 임베딩 선택이 결과를 좌우하지 않는지 확인하기 위해 OpenAI 명사, BGE-M3 제목·본문, BGE-M3 명사의 세 방식을 추가로 산출했다(부록 B). 네 방식을 같은 기준으로 비교한 뒤, 다국어 표현력과 본문 정보의 반영 정도를 고려해 OpenAI 제목·본문 방식을 대표 결과로 채택했다.
두 기사의 의미적 유사성은 벡터를 L2 정규화한 뒤 내적으로 구하는 코사인 유사도로 측정했다. 코사인은 −1에서 1 사이의 값을 갖지만, 실제 뉴스 기사 쌍에서는 대체로 0.3~1.0 구간에 분포한다. 중요한 것은 임의의 임계값으로 유사/비유사를 미리 이분하지 않고, 연속적인 코사인 값 자체를 유사성의 척도로 사용했다는 점이다. 임계값은 나중에 복제 후보를 '선별'하는 단계에서만, 그것도 여러 값을 함께 제시하는 방식으로 도입한다.
4.3 무엇이 이 측정을 믿게 하는가 — 타당성 검증
자동화된 분류기와 임베딩이 사람의 판단과 얼마나 일치하는지 검증하지 않는다면, 이후의 모든 수치는 공중에 뜬다. 그래서 저자를 제외한 독립 연구자 5인과 서로 다른 공급자·계열의 대형언어모델 5종(GPT-4.1-mini, Claude Haiku 4.5, Gemini 2.5 Flash, Gemma-4-31B, GLM-4.7)에게 무작위 표본을 주고 기사 분류와 기사쌍 유사성을 독립적으로 판정하게 했다.
결과를 보면, 다섯 범주를 모두 똑같이 맞히는 완전 일치율은 사람 67%, 모델 55%로 그리 높지 않았다. 그러나 이는 중립과 긍정, 보도기사와 광고기사의 경계가 일부 기사에서 흐릿한 데서 비롯된 것으로, 정작 주 분석 단위인 이슈-부정 대 그 외의 이진 구분에서는 사람 다수결 88%, 모델 다수결 83%가 분류기와 일치했다. 핵심 축에서는 사람과 기계, 그리고 서로 다른 다섯 모델이 대체로 같은 판단에 이른 것이다. 코사인 유사도가 사람과 모델의 실제 유사성 판단에 부합한 비율도 임베딩 구성에 따라 71~81%로, 임베딩 공간의 거리를 보도 유사성의 척도로 삼을 근거가 마련되었다.
4.4 동조를 어떻게 '측정'하는가
동조는 서로 다른 매체의 기사 내용이 전반적으로 비슷해지는 현상이다. 여기서 반드시 걸러 내야 할 것이 자기반복이다. 한 매체가 같은 기사를 갱신하거나 재게시하면 그 매체 안에서 기사쌍의 유사도가 치솟는데, 이는 매체 '사이'의 수렴과는 전혀 다른 현상이다. 그래서 동조는 서로 다른 매체에 속한 기사쌍의 코사인만으로 측정하고, 같은 매체 안의 기사쌍은 계산에서 제외했다. 이를 매체 간(between-outlet) 유사도라 부른다.
또 하나의 설계상 결정은 관측 단위다. 기사쌍을 그대로 관측 단위로 쓰면, 하나의 기사가 수많은 쌍에 반복 등장하면서 쌍들 사이의 독립성 가정이 무너진다. 이를 피하기 위해 우리는 각 매체가 다른 매체의 기사와 이루는 코사인의 평균을 먼저 구하고, 이 '매체 평균'을 통계 검정의 관측 단위로 삼았다. 사례를 통합할 때도 동조는 각 사건 내부에서 매체 간 유사도로 계산한 뒤 사건별로 합산했다. 이는 고려아연 기사와 큐텐 기사처럼 서로 다른 사건의 무관한 쌍이 평균을 왜곡하지 않도록 하기 위한 장치다.
검정은 시점(사전·사후)과 유형(부정·중립보도)을 교차한 2×2 비교로 구성했다. 시간축에서는 부정 기사의 동조가 사건 이후 올랐는지를, 유형축에서는 부정 기사가 중립·보도보다 더 닮았는지를 본다. 검정에는 비모수 Mann-Whitney U 검정과 양측 Welch t 검정을 함께 적용해, 분포 가정에 따른 결과의 흔들림이 없는지 교차 확인했다.
4.5 복제를 어떻게 '판정'하는가
복제는 두 기사가 본문의 문장이나 어구를 상당 부분 축자적으로 공유해, 각자 독립적으로 썼다고 보기 어려운 경우로 정의한다. 여기서 코사인 유사도의 역할은 분명하다. 코사인은 복제를 '확정'하는 도구가 아니라 복제 '후보'를 좁히는 그물이다. 의미가 가까운 기사쌍을 걸러 낸 뒤, 실제 판정은 본문 대조로 넘어간다.
후보 기사쌍은 코사인 값에 따라 밴드로 나누어 판정했다. 코사인 0.95 이상인 쌍은 전수 판정하고, 0.50 이상 0.95 미만은 다섯 밴드로 층화표집했다. 각 후보쌍은 서로 다른 다섯 모델로 구성된 배심원에게 두 기사의 전체 본문과 함께, 문자 10-gram 자카드(Jaccard) 유사도를 참고 정보로 제시했다. 자카드는 두 기사에서 뽑은 문자 n-gram 집합의 교집합을 합집합으로 나눈 값으로, 동일 문구의 겹침 정도를 직접 드러낸다. 다만 문서 길이에 민감하므로 판정을 지배하는 기준이 아니라 보조 단서로만 썼다. 다섯 모델은 문장 순서·표현·어휘 중복을 종합해 각 쌍을 복제 또는 독립으로 판정하고, 그 다수결을 취했다. 하나의 모델에 의존하지 않은 이유는 단일 모델의 위치 편향·표현 길이 편향·자기강화 경향을 서로 다른 공급자의 모델을 섞어 상쇄하기 위해서다.
복제 규모를 제시할 때는 커버리지율과 복제율 추정치를 함께 사용했다. 낮은 임계값은 더 많은 유사쌍을 포착하지만 독립 보도까지 끌어안고, 높은 임계값은 후보를 좁히는 대신 복제 가능성이 큰 쌍에 집중한다. 두 지표는 이 상충 관계를 임계값별로 드러내기 위한 장치다. 산출 단위도 세심하게 구분했다. 커버리지율은 기사쌍 단위로, 복제율 추정치는 기사 단위로 제시했는데, 그 이유는 부록 C의 계산 예시에서 자세히 다룬다. 요컨대 복제율은 '복제에 관여한 기사가 전체의 얼마인가'를 보존하는 기사 단위가 더 적절하다는 판단이다.
4.6 마지막 관문 — 인간 검토
배심원이 복제로 판정한 기사쌍은 연구자 5인이 본문을 직접 대조해 다시 검토했다. 각 연구자는 두 기사에서 문장과 어구가 실제로 겹치는지 확인하고, 의견이 갈리면 논의를 거쳐 복제·독립·애매 가운데 하나로 합의했다. '애매'는 판정 불능이 아니라, 한 기사 안에서 복제된 부분과 새로 쓴 부분이 함께 나타나 어느 한쪽으로 딱 잘라 말하기 어려운 경우를 가리킨다. 여러 연구자가 같은 텍스트 증거를 놓고 이견을 조정해 합의에 이르는 이 방식은 팀 기반 정성 코딩의 표준 절차를 따른 것이다. 배심원의 복제 판정 가운데 82.9%가 이 인간 검토에서도 복제로 확인되었다. 자동화의 효율과 최종 판단의 검토 가능성을 함께 확보하려는 설계였다.
4.7 배심원은 어떻게 판단하는가 — 다섯 모델의 심의
'대형언어모델 배심원'이라는 장치는 다소 생소하므로, 그 작동 방식을 조금 더 풀어 설명한다. 핵심 발상은 재판의 배심 제도와 같다. 한 명의 판사(단일 모델)에게 판단을 맡기면 그 판사 개인의 성향·편향이 결과를 좌우하지만, 성향이 다른 여러 배심원에게 같은 증거를 보여 주고 다수결을 취하면 개인차가 상쇄되어 더 안정적인 판단에 이른다는 것이다.
이때 '성향이 다른' 배심원을 구성하는 일이 관건이다. 만약 다섯 모델이 모두 같은 회사의 같은 계열이라면, 이들은 같은 학습 데이터와 같은 편향을 공유해 사실상 한 명의 배심원이나 다름없다. 그래서 우리는 세 개의 서로 다른 상용 공급자(OpenAI·Anthropic·Google)의 모델과 두 개의 오픈 가중치 모델을 섞었다. 분류기로 사용한 모델이 OpenAI 계열이라는 점도, 나머지 네 모델을 포함한 다수결을 취함으로써 특정 공급자의 판단이 결과를 지배하지 않도록 통제했다.
각 배심원에게는 동일한 자료가 동일한 형식으로 제시된다. 두 기사의 전체 본문, 그리고 문자 10-gram 자카드 유사도라는 '어휘 겹침 지표'가 함께 주어지고, 각 모델은 문장 순서·표현·어휘 중복을 종합해 '복제' 또는 '독립'을 판정한다. 판정의 일관성을 위해 온도는 0으로 고정했다. 온도가 0이면 같은 입력에 대해 모델이 거의 같은 출력을 내므로, 재현성이 확보된다.
부록 A의 일치율 표를 자세히 보면 모델들의 '개성'이 드러난다. 부정 이진 분류처럼 판단이 비교적 명확한 과제에서는 다섯 모델이 모든 연구자와 대체로 80% 이상 일치해 개성이 잘 드러나지 않는다. 그러나 유사성 판정처럼 미묘한 과제에서는 편차가 커진다. GLM은 사람과의 일치율이 다른 모델보다 낮았고(연구자에 따라 38~51%), 오픈 가중치 모델인 Gemma는 오히려 상용 모델에 가까운 높은 일치율(77~89%)을 보였다. 이는 '공개 모델이므로 성능이 낮을 것'이라는 통념이 판정 과제에서는 성립하지 않음을 보여 준다. 바로 이런 개성의 차이 때문에, 어느 한 모델에 전권을 주는 대신 다수결로 결합하고 마지막에 인간이 재확인하는 설계가 정당화된다. 배심원은 방대한 후보를 일관되게 걸러 내는 데 탁월하지만, 최종 유죄 판결의 망치는 여전히 사람의 손에 있다.
4.8 분석의 규모와 재현성
이 연구의 신뢰성은 단지 방법의 정교함이 아니라 재현 가능성에서 나온다. 같은 절차를 같은 자료에 적용하면 누구든 같은 수치에 이르러야 하며, 그렇지 않다면 어떤 결론도 검증할 수 없다. 이를 위해 몇 가지 원칙을 지켰다.
먼저 분류 단계의 판정 결과는 모두 저장되어 재실행 시 동일하게 적용된다. 대형언어모델은 같은 입력에도 미세하게 다른 출력을 낼 수 있으므로, 온도를 0으로 고정하고 판정 결과를 캐시로 잠가 두어 재실행이 같은 결과를 내도록 했다. 임베딩 역시 기사별로 산출해 저장했으며, 관련 기사 집합과 임베딩의 길이가 일대일로 맞물리도록 정합성을 관리했다.
분석의 규모도 밝혀 둘 필요가 있다. 수집 기사는 77,118편, 관련 기사는 43,039편, 그중 동조·복제 분석의 무대가 된 사후 부정 기사는 21,260편이다. 이 21,260편에서 가능한 매체 간 기사쌍은 약 6,169만 쌍에 이른다. 이 방대한 쌍 전체를 사람이 검토하는 것은 불가능하며, 바로 이 지점에서 '의미 임베딩으로 후보를 좁히고, 배심원으로 1차 선별하고, 사람이 최종 확인하는' 3단 구조가 필연적으로 요구된다. 6,169만 쌍 가운데 코사인 0.8 이상은 0.35%로 좁혀지고, 그 안에서 배심원이 복제로 지목한 387쌍을 연구자 5인이 전수 대조했다. 규모의 문제를 절차의 설계로 푼 것이다.
매체 실명은 내부 검토용 본 보고서에서만 노출하며, 외부 공개본에서는 90개 매체를 일곱 유형의 코드(A 전국일간지, B 경제일간지, C 지역일간지, E 방송사, F 전문지, G 스포츠신문, H 인터넷신문)로 익명화한다. 코드와 실명을 잇는 매핑표는 별도로 관리해, 연구의 재현성과 매체 보호를 동시에 확보한다.
5. 결과 — 무엇이 보였는가
5.1 분류 분포 — 무엇이 분석에 들어왔는가
수집한 77,118편 가운데 사건 관련성을 통과한 43,039편을 분석 대상으로 삼고, 무관 기사 34,079편은 제외했다. 수집량의 44%만이 실제 분석에 들어온 셈인데, 이는 회사명 검색이 그만큼 많은 잡음을 끌어온다는 방증이자, 관련성 필터링이 왜 필수인지를 보여 준다. 관련 기사 중 이슈-부정이 22,899편으로 가장 많았고, 보도기사 10,656편, 이슈-중립 4,618편, 이슈-긍정 1,931편, 광고기사 182편이 뒤를 이었다. 부정 기사가 긍정 기사의 열 배를 넘는다는 사실 자체가, 위기 국면의 보도가 어느 방향으로 쏠리는지를 단적으로 드러낸다. 이슈-부정 22,899편은 다시 사전 1,639편과 사후 21,260편으로 나뉘며, 이 사후 부정 기사가 동조·복제 분석의 무대가 된다.
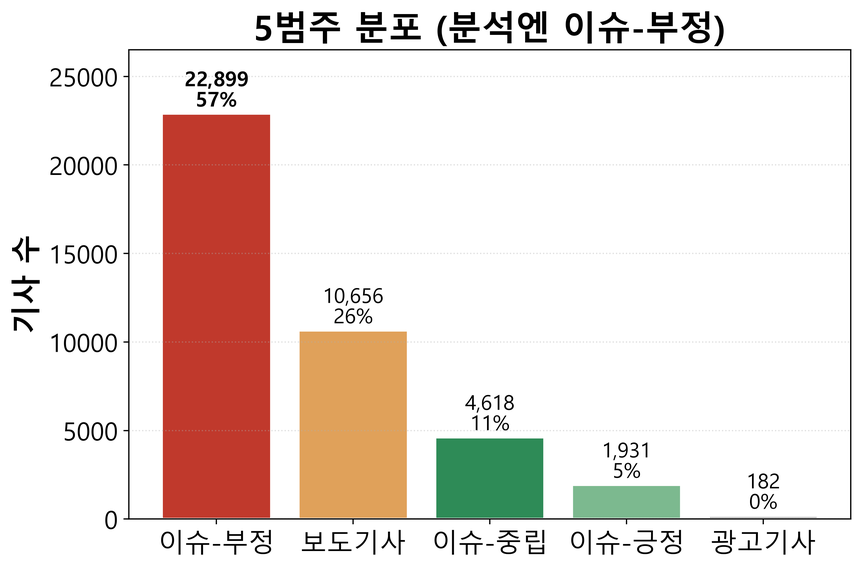
<그림 3> 관련 기사 5범주 분포
5.2 동조 — 부정 보도만 유난히 닮아진다
먼저 기사쌍 수준에서 보면, 사후 부정 기사쌍의 평균 코사인은 0.549로 같은 기간 중립·보도 기사쌍의 평균 0.479보다 뚜렷이 높았다. 이 차이는 일부 극단적으로 닮은 쌍에 국한된 것이 아니라 분포 전반에서 나타났다. 즉 '몇몇 복제된 쌍이 평균을 끌어올린 것'이 아니라, 부정 기사 전체가 중립·보도보다 조금씩 더 닮아 있는 구조다.
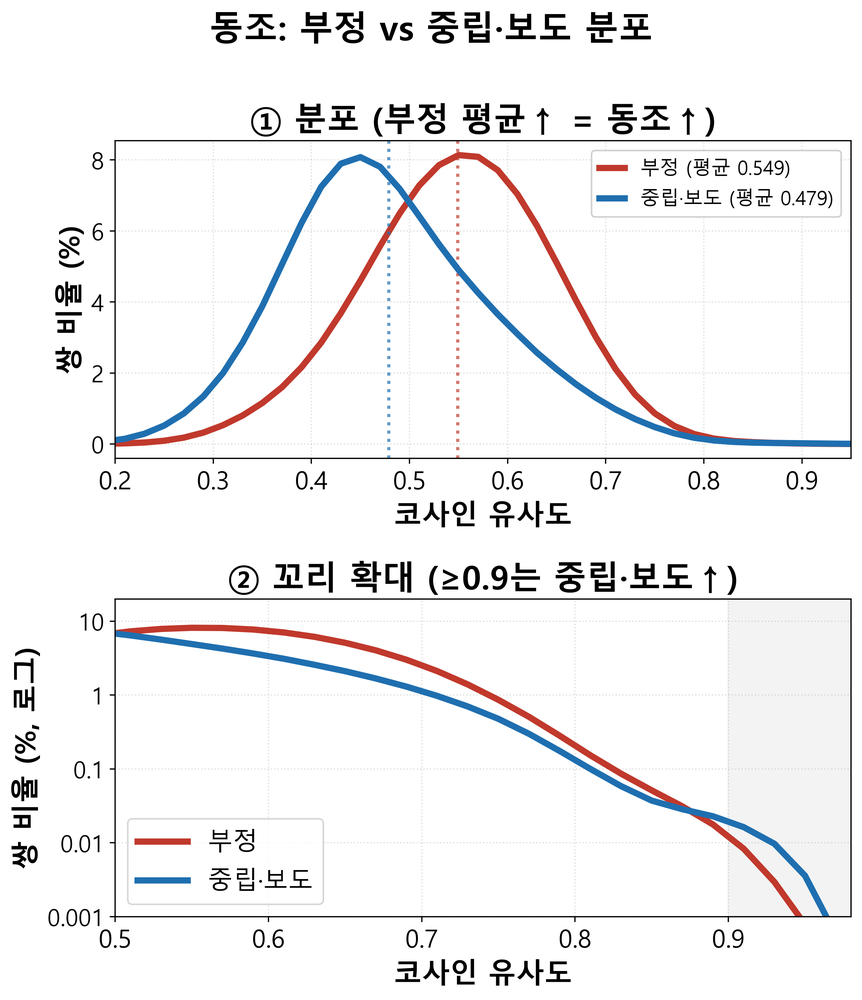
<그림 4> 매체 간 코사인 분포
관측 단위를 매체 평균으로 올려 2×2로 검정하면 그림은 더 선명해진다(<표 2>). 사후 부정 기사의 평균 동조는 0.556으로 같은 기간 중립·보도의 0.442보다 0.114 높았고(95% 신뢰구간 0.108–0.120), 이 격차는 통계적으로 강하게 유의했다. 시간축을 보면 부정 기사의 동조는 사건 이전 0.499에서 사후 0.556으로 올랐지만, 중립·보도는 0.436에서 0.442로 사실상 제자리였다. 다시 말해 사건이라는 사건은 부정 기사에서만 선택적으로 매체 간 유사성을 끌어올렸고, 중립·발표성 보도는 그 자리에 그대로 있었다. 이 '선택적 상승'이야말로 자연스러운 수렴과 구별되는 동조의 지문이다.
<표 2> 시점 × 유형 2×2 매체 간 동조 검정
| 비교 | 평균 | 평균 | MWU(z) | Welch(t) | |
|---|---|---|---|---|---|
| 사전 | 부정 vs 중립·보도 | 0.499 | 0.436 | 12.0*** | 13.2*** |
| 사후 | 부정 vs 중립·보도 | 0.556 | 0.442 | 20.7*** | 37.0*** |
| 부정 | 사전 vs 사후 | 0.499 | 0.556 | 13.8*** | 14.9*** |
| 중립·보도 | 사전 vs 사후 | 0.436 | 0.442 | 1.3 | 1.4 |
주: *** p<0.001. 부정 관측 수 319, 중립·보도 275.
주목할 것은 표의 마지막 두 줄이다. 부정 기사는 사전에서 사후로 유의하게 올랐지만(세 번째 줄), 중립·보도는 변화가 통계적으로 유의하지 않았다(네 번째 줄, p>0.05). 만약 사건이 모든 보도를 두루 닮게 만드는 것이라면 두 줄 모두 상승해야 한다. 그러나 오직 부정 기사만 움직였다. 이 대비가 동조의 존재를 증명한다.
이 방향성은 다섯 사례 어디에서도 어긋나지 않았다(<표 3>). 사후 구간에서 부정 기사의 동조는 모든 사례에서 중립·보도를 유의하게 웃돌았다. 특히 남양유업은 부정 0.595 대 중립·보도 0.418로 격차가 가장 컸는데, 이는 뒤에서 볼 복제율 1위와도 맞닿아 있다.
<표 3> 사례별 사후 부정 · 중립보도 동조
| 사례 | 부정 | 중립·보도 | MWU(z) | Welch(t) |
|---|---|---|---|---|
| 고려아연 | 0.574 | 0.482 | 8.6*** | 16.3*** |
| 홈플러스 | 0.534 | 0.417 | 10.9*** | 30.8*** |
| 롯데카드 | 0.543 | 0.412 | 9.0*** | 27.3*** |
| 남양유업 | 0.595 | 0.418 | 7.9*** | 28.3*** |
| 큐텐 | 0.553 | 0.478 | 9.6*** | 18.6*** |
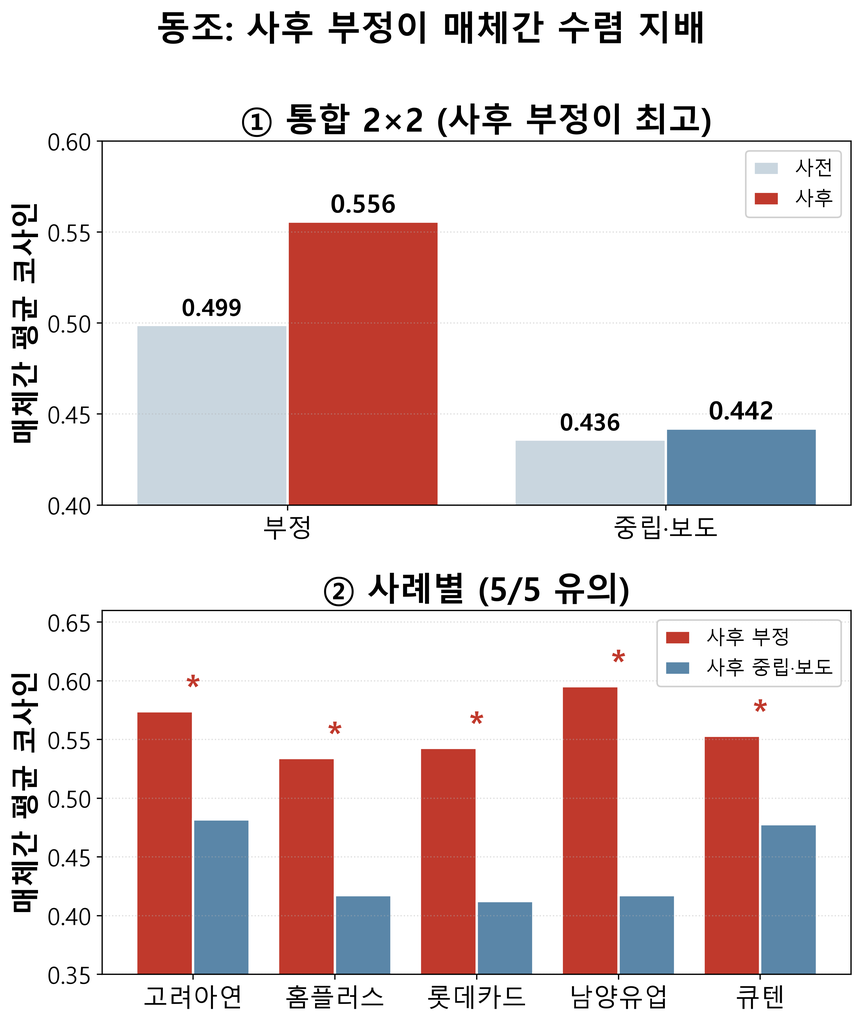
<그림 5> 동조 2×2 (통합·사례별)
주: *** p<0.001.
5.3 어떤 매체 유형이 서로 닮는가 — 유형별 동조 히트맵
동조가 부정 기사에서 선택적으로 상승한다는 사실을 확인했다면, 다음 질문은 자연스럽다. 그 닮음은 어떤 매체들 사이에서 두드러지는가? 이를 보기 위해 사후 부정 기사 21,260편을 매체 유형별로 묶고, 서로 다른 유형(및 같은 유형 내 서로 다른 매체) 사이의 평균 코사인을 사건 내부에서 계산해 7×7 행렬로 정리했다(<그림 6>). 전체 매체 간 평균은 0.549로, 논문 본문의 값과 정확히 일치한다.
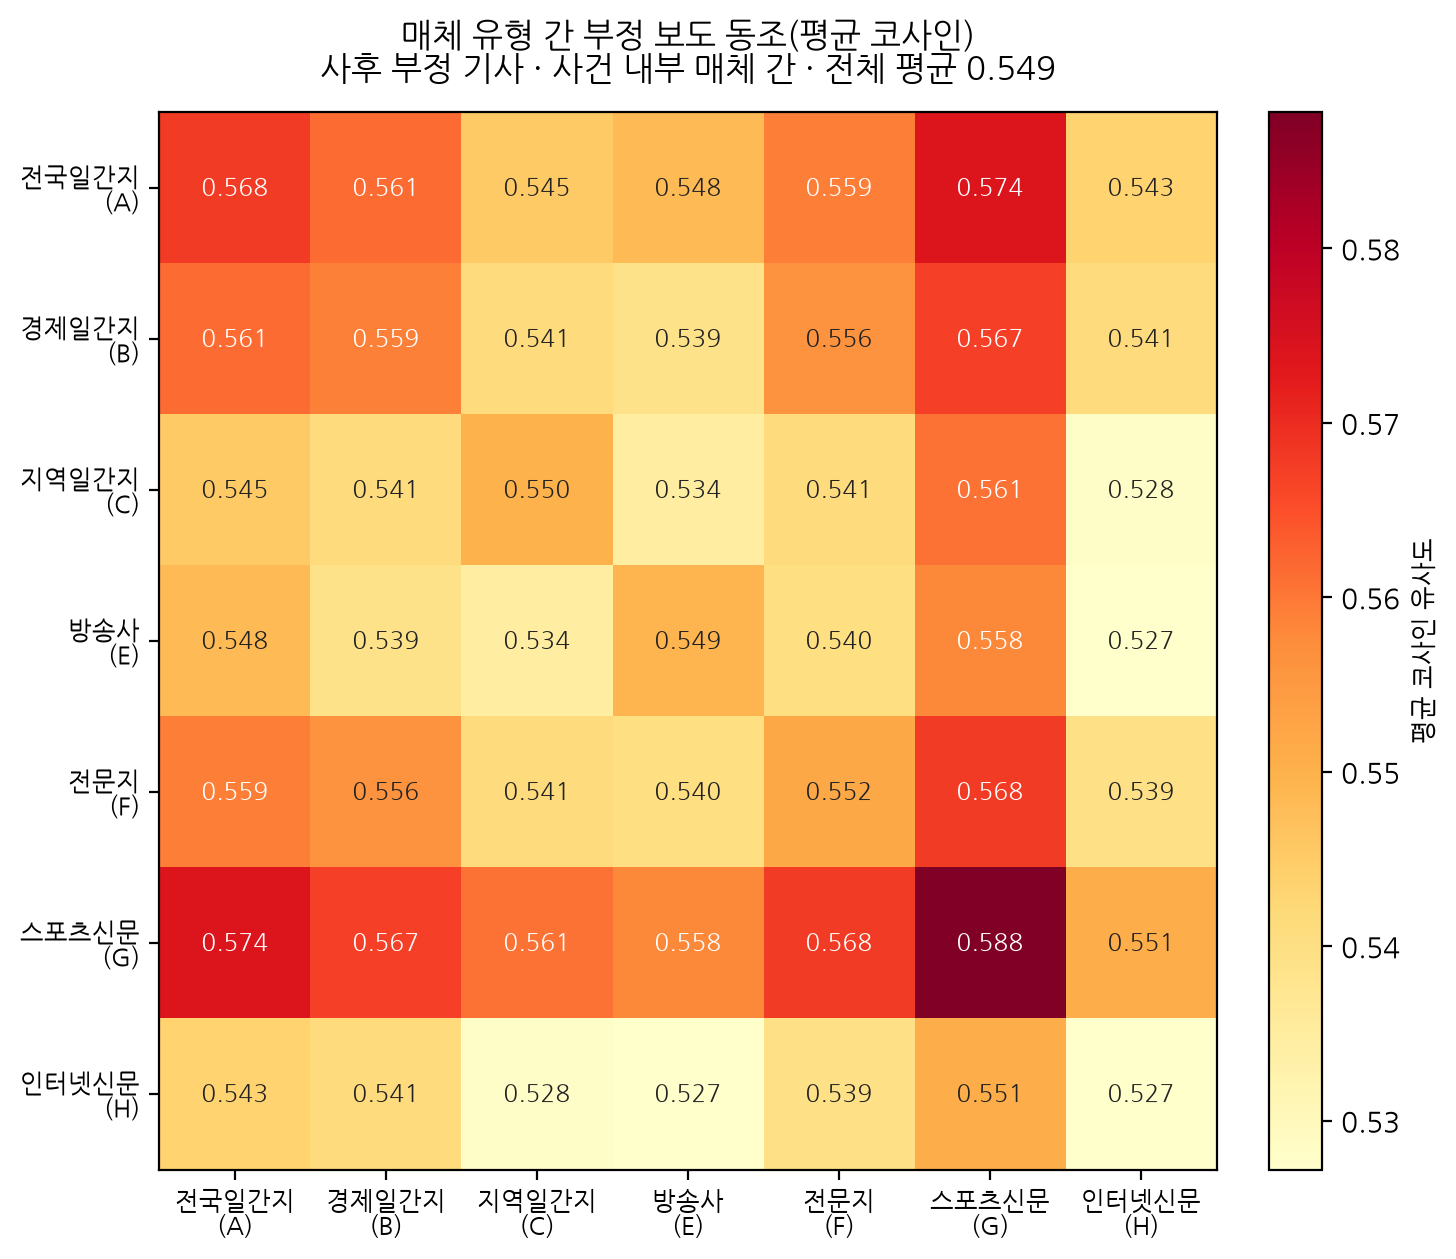
<그림 6> 매체 유형 간 부정 보도 동조 히트맵
행렬을 읽으면 몇 가지 규칙성이 드러난다. 첫째, 전국일간지(A, 유형 내 평균 0.568)와 경제일간지(B, 0.559) 가 유형 내부에서 가장 강하게 동조했고, 두 유형 사이(A–B 0.561)도 높았다. 위기 사건의 핵심 보도를 주도하는 종합·경제 일간지들이 서로 가장 촘촘히 닮아 있다는 뜻이다. 둘째, 인터넷신문(H, 0.527) 은 어느 유형과 견주어도 가장 낮은 동조를 보였다. 인터넷신문이 상대적으로 이질적인 기사를 생산한다기보다는, 매체 수가 많고 성격이 다양해 유형 내부의 결이 덜 균질하기 때문으로 해석된다. 셋째, 스포츠신문(G)이 표면상 가장 높은 값(0.588)을 보였으나, 이는 사후 부정 기사가 132편·3개 매체에 불과한 소표본에서 나온 값이므로 과대 해석을 경계해야 한다. 요컨대 실질적인 동조의 진앙은 전국·경제 일간지이며, 위기 보도의 '받아쓰기'가 이 중심부에서 가장 강하게 작동한다는 정황이다.
5.4 복제 — 얼마나 베꼈는가
지금까지의 결과는 "사건 이후 부정 기사들이 서로 더 닮아진다"는 사실을 확립했다. 그러나 동조는 아직 원인을 말하지 않는다. 부정 기사들이 닮아진 것은 같은 사실을 각자 충실히 취재했기 때문일 수도 있고, 한쪽의 본문을 다른 쪽이 옮겨 왔기 때문일 수도 있다. 동조의 지문을 확인했으니, 이제 그 닮음의 얼마만큼이 복제인가를 물을 차례다. 이것이 사다리의 마지막 칸이다.
사후 부정 기사쌍의 69.9%가 코사인 0.5 이상이었지만, 임계값을 높일수록 조건을 만족하는 쌍의 비율은 가파르게 떨어졌다(0.7 이상 5.5%, 0.8 이상 0.35%, 0.9 이상 0.012%). 중간 수준의 내용 유사성은 폭넓게 퍼져 있으나, 매우 높은 유사성은 소수에 집중되어 있다는 뜻이다. 바로 그 소수가 복제 후보다.
밴드별 배심원 판정에 밴드별 기사 수를 가중한 추정 복제율은 13.9%였다. 연구자 5인의 본문 검토로 보정하면 복제로 확인된 몫만 따져 9.4%, 복제와 변형이 뒤섞인 애매한 사례까지 포함한 상한이 10.2%였다(<표 4>). 즉 사후 부정 기사 열 편 가운데 한 편꼴은 다른 매체 기사의 본문을 실질적으로 옮겨 온 것으로 추정된다. 이 수치는 '모든 기사가 다 베꼈다'는 과장도, '복제는 없다'는 부인도 아닌, 그 사이의 실측값이다.
<표 4> 코사인 임계별 커버리지율 · 복제율 추정치
| 코사인 임계 | 커버리지율(기사쌍) | 복제율(배심원) | 복제율(인간 보정) |
|---|---|---|---|
| ≥ 0.5 | 69.9% | 13.9% | 9.4% |
| ≥ 0.7 | 5.5% | 13.9% | 9.4% |
| ≥ 0.8 | 0.35% | 13.9% | 9.4% |
| ≥ 0.9 | 0.012% | 11.2% | 8.1% |
| ≥ 0.95 | 0.0004% | 1.7% | 1.5% |
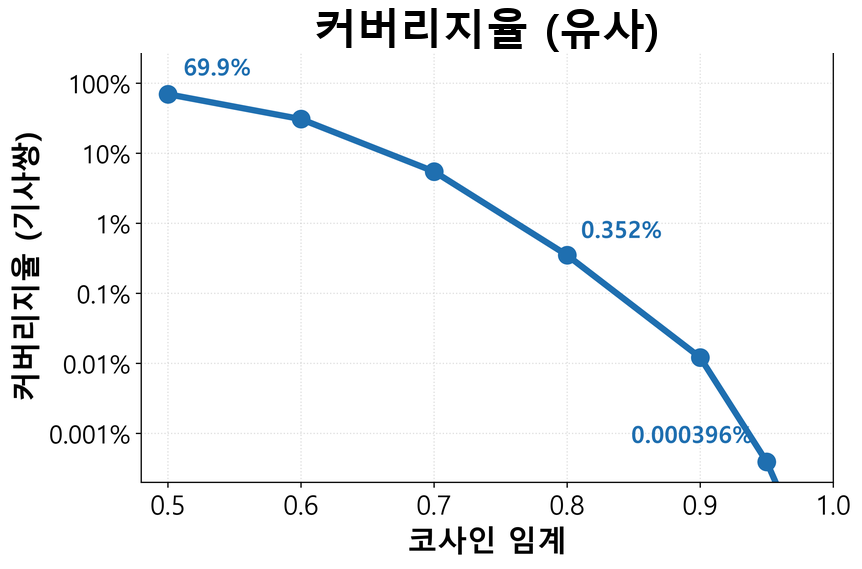
<그림 7> 커버리지율 (기사쌍)
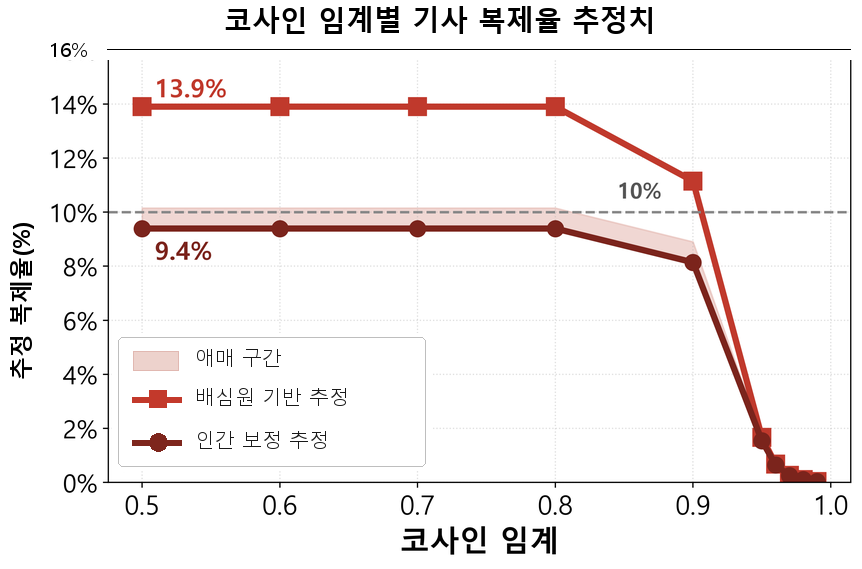
<그림 8> 코사인 임계별 기사 복제율 추정치
배심원과 인간의 판단은 코사인이 높을수록 더 잘 일치했다(<표 5>). 코사인 0.95 이상 구간에서는 배심원 복제 판정의 92%가 인간 검토에서도 복제로 확인된 반면, 0.80~0.90 구간에서는 45%로 떨어졌다. 이는 직관과 부합한다. 코사인이 아주 높은 쌍은 사실상 같은 글이어서 이견이 없지만, 중간대의 쌍은 '같은 사안을 각자 쓴 것'과 '옮긴 것'이 뒤섞여 있어 판단이 갈린다. 배심원 복제 판정 387쌍 전체로는 인간 확인율이 82.9%(복제 321·독립 38·애매 28)였다.
<표 5> 코사인 구간별 복제 판정 및 인간 검토
| 코사인 구간 | 배심원 복제쌍 | 인간 복제쌍 | 확인율 |
|---|---|---|---|
| 0.80–0.90 | 11 | 5 | 45% |
| 0.90–0.95 | 135 | 94 | 70% |
| 0.95 이상 | 241 | 222 | 92% |
| 합계 | 387 | 321 | 82.9% |
사례별로 보면 복제율은 남양유업이 인간 보정 기준 18.2%로 가장 높았고, 홈플러스 10.5%, 롯데카드 9.9%, 큐텐 8.3%, 고려아연 7.3% 순이었다(<표 6>). 인간 보정은 각 사례의 복제율 수준을 낮출 뿐 상대적 순위는 바꾸지 않았다. 남양유업이 1위인 것은 앞서 동조 격차(0.595 대 0.418)가 가장 컸던 것과 일관되며, 사건 규모가 상대적으로 작아 소수의 발표성 속보가 여러 매체에 그대로 퍼졌을 때 그 비중이 크게 잡히는 구조와도 관련된다.
<표 6> 사례별 복제 판정 및 기사 복제율 추정치
| 사례 | 분석 기사 수 | 확인율 | 복제율(배심원) | 복제율(인간 보정) |
|---|---|---|---|---|
| 고려아연 | 5,106 | 85% | 11.1% | 7.3% |
| 홈플러스 | 8,498 | 85% | 15.4% | 10.5% |
| 롯데카드 | 2,197 | 74% | 14.6% | 9.9% |
| 남양유업 | 595 | 68% | 25.3% | 18.2% |
| 큐텐 | 4,864 | 91% | 12.4% | 8.3% |
| 전체 | 21,260 | 82.9% | 13.9% | 9.4% |
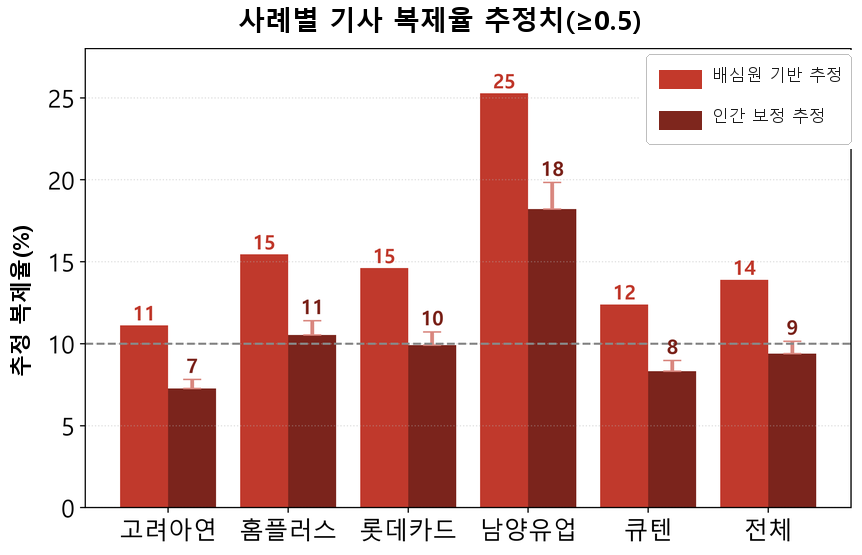
<그림 9> 사례별 기사 복제율 추정치
5.5 복제의 얼굴들 — 실제로 무엇이 겹쳤는가
숫자는 규모를 말해 주지만 장면을 보여 주지는 못한다. 복제가 실제로 어떤 모습인지, 배심원 다섯 모델이 만장일치로 '복제'로 판정한 쌍들(모두 코사인 0.95 이상 구간으로, 이 구간의 인간 검토 확인율은 92%에 이른다)을 직접 들여다보자. 아래 예시는 매체명을 실명으로 밝힌 내부 검토용이며, 겹침을 드러내기 위해 도입부 일부만 나란히 인용한다.
사례 1 — 큐텐 '구영배 구속영장' 속보가 아홉 개 매체로 (코사인 0.99). 검찰이 구영배 큐텐 대표에게 구속영장을 청구한 2024년 10월 4일, 같은 속보가 사실상 동일한 본문으로 최소 아홉 개 매체에 퍼졌다.
A10 — "티몬과 위메프의 대규모 미정산 사태를 수사하는 검찰이 구영배 큐텐 그룹 대표 등 핵심 경영진의 신병 확보에 나섰다. … 이들은 1조5950억원 상당의 물품 판매 등 정산대금을 가로챈 혐의를 받는다. … 검찰 관계자는 '사안의 중대성, 증거 인멸 가능성, 도주 우려 등을 종합적으로 고려했다'고 밝혔다."
B12 — "티몬과 위메프의 대규모 미정산 사태를 수사하는 검찰이 구영배 큐텐 그룹 대표 등 핵심 경영진의 신병 확보에 나섰다. … 이들은 1조5950억원 상당의 물품 판매 등 정산대금을 가로챈 혐의가 적용됐다. … 검찰 관계자는 '사안의 중대성, 증거 인멸 가능성, 도주 우려 등을 종합적으로 고려했다'고 설명했다."
문장 구조, 수치, 인용문까지 겹치고 차이는 '받는다/적용됐다', '밝혔다/설명했다'처럼 어미 수준에 그친다. B12가 담당 검사의 이름을 한 줄 덧붙인 것 정도가 눈에 띄는 차이의 전부다.
사례 2 — 고려아연 '국민연금 토론회' 기사의 문단 통째 복제 (코사인 0.99). 특정 학술 토론회를 전한 기사가 A01과 B06에서 도입부부터 발제 인용까지 한 글자도 다르지 않게 나타났다.
A01 / B06(동일) — "기업지배구조개발연구회는 지난 5월 28일 세종대학교에서 '국가기간산업 보호를 위한 국민연금 역할, 고려아연·MBK 사태를 중심으로'를 주제로 전문가 토론회를 개최하고 … 사모펀드의 단기 수익 추구가 국가 핵심기술 유출로 이어질 수 있다는 우려 속에 마련됐다. … 권재열 경희대 교수는 '국민연금은 세계 3위 규모의 공적 연기금으로 … 자본시장 전체에 미치는 영향이 크다'고 지적했다."
이 사례가 특히 의미심장한 이유는, 단순 사실 전달 속보가 아니라 특정 관점('MBK의 적대적 M&A', '국가 핵심기술 유출 우려')을 담은 프레임이 통째로 복제되었다는 점이다. 동일한 논조의 문단이 여러 매체의 지면에 그대로 옮겨질 때, 이용자는 서로 다른 매체를 통해 같은 관점을 반복 확인하게 된다.
사례 3 — 롯데카드 '방통위 긴급 점검'이 열한 개 매체로. 방송통신위원회의 연계정보 점검 발표(2025년 9월 22일)는 C18·B12를 비롯한 열한 개 매체에 거의 같은 문장으로 실렸다.
C18 — "방송통신위원회는 22일 롯데카드 고객 정보 유출과 관련, 주민등록번호를 암호화한 '연계정보'(Connecting Information)의 안전조치 및 관리 실태 등에 대한 긴급 점검을 실시한다. 연계정보란 주민등록번호 대신 이용자를 식별해 … 암호화한 정보다."
B12 — "방송통신위원회는 22일 롯데카드 고객 정보 유출과 관련, 주민등록번호를 암호화한 '연계정보'(Connecting Information)의 안전조치 및 관리 실태 등에 대한 긴급 점검을 실시한다고 밝혔다. 연계정보란 주민등록번호 대신 이용자를 식별해 … 암호화한 정보다."
사례 4 — 남양유업, 같은 원본이 방송체와 신문체로 갈아입다 (코사인 0.98). 홍원식 전 회장의 횡령 의혹 관련 검찰 소환 보도에서 E01와 B11는 같은 사실관계를 같은 순서로 전했는데, 흥미롭게도 문체만 서로 달랐다.
E01 — "홍원식 전 남양유업 회장의 200억대 횡령 의혹을 수사 중인 검찰이 회사의 전직 경영진을 소환했습니다. … 홍 전 회장 등은 회사 자기자본의 2.97%에 해당하는 201억여 원을 횡령한 의혹을 받습니다."
B11 — "홍원식 전 남양유업 회장의 200억원대 횡령 의혹을 수사 중인 검찰이 회사의 전직 경영진을 소환했다. … 홍 전 회장 등은 회사 자기자본의 2.97%에 해당하는 약 201억 2223만원을 횡령한 의혹을 받고 있다."
방송사는 '~했습니다'의 방송체를, 신문은 '~했다'의 문어체를 쓰지만, 자기자본 대비 2.97%라는 특이한 세부 수치와 문장 배열이 일치한다는 점에서 두 기사가 같은 원본을 공유했음을 시사한다. 문체 변환은 복제를 가리는 흔한 장치이지만, 임베딩과 배심원은 표면적 문체 차이 너머의 골격을 포착한다.
본 보고서가 살펴본 복제 클러스터에서 나타난 경향은 분명하다. 복제는 대체로 속보와 발표성 보도 — 구속영장 청구, 당국의 점검·발표, 토론회 전언 — 에 집중된다. 마감의 압박 속에서 '먼저 나온 기사'가 여러 매체로 빠르게 퍼지는 국면이다. 이는 복제가 저널리즘 전반의 병리라기보다, 특정 취재·유통 관행이 만들어 내는 국지적 현상임을 시사한다.
5.6 배심원과 인간 — 기계 판정은 믿을 만한가
마지막으로, 이 모든 복제 판정의 신뢰성 문제를 되짚는다. 배심원의 복제 판정 가운데 82.9%가 인간 검토에서도 복제로 확인되었다는 사실은 두 방향으로 읽힌다. 한편으로는 다섯 모델의 다수결이 인간 판단과 상당히 잘 맞아, 방대한 기사쌍을 일관된 기준으로 선별하는 1차 필터로 충분히 쓸 만함을 뜻한다. 다른 한편으로는 17% 남짓의 불일치가 존재하므로, 최종 판정을 기계에만 맡겨서는 안 된다는 경고이기도 하다. 그래서 이 연구는 배심원을 인간을 대체하는 심판이 아니라, 인간 검토로 가는 길을 좁혀 주는 후보 선별 장치로 자리매김했다. 자동화의 규모와 인간 판단의 신중함을 한 절차 안에 담으려는 설계다.
사례별로 나누어 보면 복제 확인율은 큐텐이 91%로 가장 높았고, 고려아연과 홈플러스가 각각 85%, 롯데카드 74%, 남양유업 68%로 나타났다. 모든 사례에서 배심원 복제 판정의 과반이 연구자 검토에서도 복제로 확인되었으며, 인간 보정 복제율은 남양유업 18.2%·홈플러스 10.5%·롯데카드 9.9%·큐텐 8.3%·고려아연 7.3%의 순서였다. 보정 이후에도 사례 간 상대적 순위는 배심원 추정치와 동일하여, 인간 검토는 각 사례의 복제율 수준을 낮출 뿐 사례 사이의 순서를 바꾸지는 않았다.
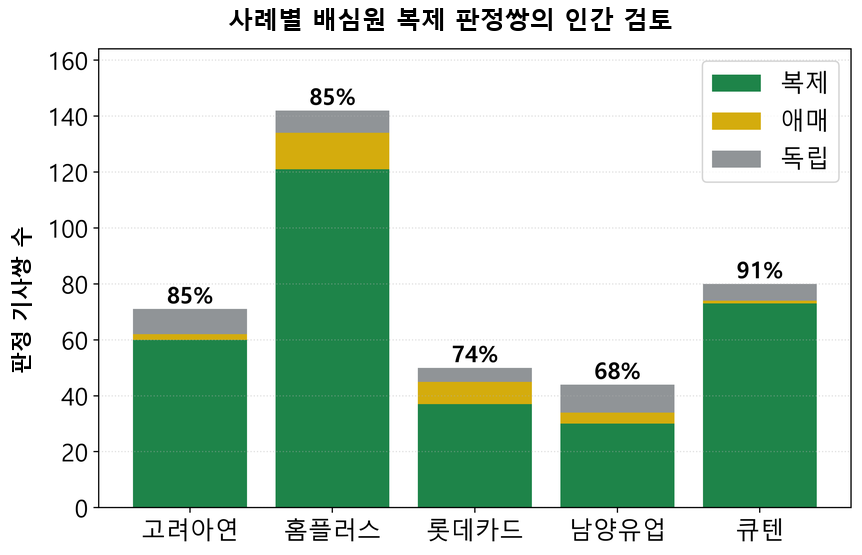
<그림 10> 배심원 복제 판정쌍의 사례별 인간 검토
6. 논의 — 무엇을 말할 수 있고, 무엇은 아직 아닌가
6.1 사건 이후 부정 보도의 선택적 동조가 뜻하는 것
이 연구의 첫 번째 기여는 사건 이후 부정 보도의 동조를 사건 이전 및 같은 시기의 다른 유형과 나란히 비교해 검정했다는 데 있다. 동일 사건을 다룬 기사가 서로 닮는 것은 자연스럽다. 그래서 사후 부정 기사만 떼어 놓고 "유사도가 높다"고 말하는 것은 아무것도 입증하지 못한다. 이 연구가 보인 것은 그 유사성이 선택적이라는 점이다. 사건은 부정 기사에서만 동조를 끌어올렸고 중립·발표성 보도는 움직이지 않았으며(표 2의 마지막 두 줄), 이 방향은 성격이 전혀 다른 다섯 사건에서 모두 재현되었다(표 3). 위기 국면에서 부정 프레임의 보도가 유독 서로를 향해 수렴하는 이 현상은, 포털 화면 위에서 이용자가 접하는 '관점의 폭'이 바로 그 국면에 좁아진다는 것을 뜻한다.
6.2 복제의 규모와 성격 — 만연이 아니라 집중
두 번째 기여는 의미적 유사성과 본문 복제를 분리해 탐지하는 절차를 제시하고, 그 규모를 실측했다는 점이다. 인간 보정 복제율 9.4%는 두 가지를 동시에 말한다. 하나는 복제가 결코 무시할 수 없는 규모로 실재한다는 것이고, 다른 하나는 그것이 보도 전체를 뒤덮은 것은 아니라는 것이다. 더 중요한 것은 복제의 분포다. 5.5절의 장면들이 보여 주듯 복제는 속보와 발표성 보도에 집중된다. 구속영장 청구, 당국의 점검·발표, 압수수색 같은 '먼저 쓴 기사가 곧 표준이 되는' 국면에서, 마감의 속도전이 본문 복제를 낳는다. 이는 복제가 개별 기자의 태만이라기보다 취재·유통 관행의 구조적 산물임을 시사한다.
6.3 원인을 어디까지 말할 수 있는가 — 해석의 한계
관측된 유사성의 원인을 해석할 때는 신중해야 한다. 매체 간 직접적 복제가 없더라도, 여러 매체가 통신사 기사나 기업 보도자료를 공통으로 사용하면 본문은 자연히 비슷해진다. 실제로 고유사 기사쌍에 포함된 기사 가운데 본문에 연합뉴스·뉴시스·뉴스1·연합인포맥스의 출처가 표시된 기사는 약 10%였고, 나머지 90%는 본문만으로는 출처를 확인할 수 없었다. 출처 표시를 지우거나 문장을 일부 손질한 경우 공통 자료의 흔적은 더 흐려진다. 게다가 분석 대상 90개 매체에 통신사 자체는 포함되지 않아, 유형만으로 유통 경로를 추적하는 데도 한계가 있다. 따라서 관측된 유사성이 매체 간 상호 영향에서 온 것인지 공통 출처의 공유에서 온 것인지를 인과적으로 가르는 일은 이 연구의 범위를 넘어선다. 다만 원인이 무엇이든, 이용자에게 노출되는 여러 매체의 기사 내용이 실제로 얼마나 닮아지는지는 코사인으로 관측할 수 있으며, 복제 판정 또한 법적 책임의 귀속이 아니라 본문 중복의 사실 확인에 초점을 둔다는 점을 분명히 해 둔다.
6.4 실무로의 다리 — 포털 뉴스 품질 관리를 위한 단계적 절차
이 연구가 제안하는 절차는 그대로 플랫폼의 의사결정 도구로 옮겨질 수 있다. (1) 운영 목적에 맞는 코사인 임계값을 정해 유사 기사쌍을 선별하고, (2) 여러 모델의 배심원 판정으로 복제 후보의 범위를 좁힌 뒤, (3) 일부 또는 전체 후보를 사람이 검토하는 3단 구조다. 임계값과 인간 검토 비율은 '정상 기사를 복제로 오판하는 비용'과 '실제 복제를 놓치는 비용' 사이의 균형에 따라 조정하면 된다. 중요한 것은 이 연구가 특정 임계값을 못 박아 제시하지 않는다는 점이다. 위기 국면과 평상시, 속보와 기획기사는 위험 수준이 다르므로, 플랫폼은 운영 목적과 위험 감수 수준에 따라 기준을 스스로 설정해야 한다. 이 연구는 그 설정에 필요한 근거와 절차를 제공한다. 네이버 제휴 평가 규정이 이미 '매체를 넘어선 문장 겹침'을 제재 기준으로 삼고 있는 만큼, 사건 단위로 동조·복제를 정량화하는 이 절차는 규정의 사후 적발을 넘어 사전·상시 모니터링으로 확장될 여지를 지닌다.
구체적인 운용 시나리오를 그려 보면 이 절차의 쓸모가 분명해진다. 첫째, 급증 국면 감시다. 특정 사건에 대한 기사가 짧은 시간에 폭증할 때, 매체 간 동조 지표가 평소·비교군 대비 급격히 상승하는지를 실시간으로 관측하면, 받아쓰기가 집중되는 국면을 조기에 포착할 수 있다. 둘째, 중복 노출 완화다. 이용자에게 기사 목록을 제시할 때, 코사인·자카드로 사실상 동일한 기사들을 하나의 묶음으로 접어 보여 주면, 같은 문장을 반복해서 읽게 되는 피로를 줄이고 화면의 실질적 다양성을 높일 수 있다. 셋째, 제재의 근거 제공이다. 개별 기사 쌍의 겹침만 보는 현행 방식에 사건 단위의 동조·복제 맥락을 더하면, 어떤 매체가 어떤 국면에서 반복적으로 본문을 옮겨 오는지를 근거와 함께 제시할 수 있다. 이때도 최종 판단에는 인간 검토가 개입해야 하며, 자동 지표는 어디까지나 '어디를 들여다볼지'를 좁혀 주는 역할에 머물러야 한다.
6.5 한계와 다음 걸음
이 연구는 주요 매체 90개와 네이버 노출 기사로 범위를 한정했으므로, 결과를 모든 언론사와 유통 경로에 그대로 일반화하기는 어렵다. 복제와 변형이 한 기사에 섞인 애매 사례 28쌍은 문장·단락 단위의 중복률을 별도로 측정할 필요가 있다. 앞으로의 과제로는 (1) 기업 보도자료와 기사 사이의 직접적 관계 분석, (2) 복제의 원본과 전파 순서(누가 먼저 쓰고 누가 받아썼는가)의 규명, (3) 더 많은 사건과 매체로의 확장, (4) 동일 길이 관찰 기간을 적용한 강건성 검증을 꼽을 수 있다. 의미 임베딩으로 후보를 좁히고 다중 모델 판정과 인간 검토를 결합하는 이 절차는 뉴스에 국한되지 않으며, 문서 중복과 내용 재사용을 판별해야 하는 다른 영역에도 이식할 수 있다.
7. 결론
포털이라는 하나의 창으로 세상을 보는 사회에서, 매체 간 보도가 얼마나 닮는지는 곧 이용자가 누리는 관점의 폭에 관한 문제다. 이 연구는 그 '닮음'을 수렴·동조·복제의 세 층위로 갈라, 다섯 건의 기업 위기 사건에서 각각을 정량적으로 측정했다. 그 결과 사건 이후 부정 보도의 매체 간 유사성은 사건 이전보다, 그리고 같은 시기의 중립·발표성 보도보다 선택적으로 상승했으며, 이 방향은 다섯 사례에서 예외 없이 재현되었다. 그 유사성 가운데 실제 본문 복제로 확인된 몫은 인간 보정 기준 9.4%였고, 복제는 속보와 발표성 보도에 집중되어 있었다.
방법론적으로 이 연구는 의미 임베딩(후보 선별)·문자 자카드(어휘 겹침)·다중 모델 배심원(일관된 판정)·인간 검토(최종 확인)를 하나의 재현 가능한 파이프라인으로 엮었다. 이 절차는 학술적으로는 매체 간 의제 설정과 받아쓰기 연구를 정량화의 지평으로 끌어오고, 실무적으로는 포털의 중복 노출 관리와 뉴스 품질 관리에 곧바로 쓸 수 있는 단계적 의사결정 도구를 제공한다. 남는 과제는 원인의 인과적 규명과 더 넓은 일반화이지만, '무엇이 얼마나 닮았는가'라는 물음에 대해 이 연구는 재현 가능한 답의 틀을 마련했다.
부록 A. 대형언어모델 배심원 구성과 연구자·모델 간 일치도
복제 판정과 분류·임베딩 검증에는 서로 다른 회사·계열의 대형언어모델 다섯 종을 사용했다. 세 개 상용 공급자의 모델(GPT-4.1-mini, Claude Haiku 4.5, Gemini 2.5 Flash)과 두 개의 오픈 가중치 모델(Gemma-4-31B, GLM-4.7)을 함께 써서 특정 회사나 계열의 판단이 결과를 지배하지 않도록 구성했다. 모든 모델에 동일한 프롬프트와 기사 정보를 제시하고 온도를 0으로 고정했으며, 모델별 판정과 근거를 기록해 재검토가 가능하도록 했다.
부정 이진 분류에서 사람 다수결은 분류기와 88%, 모델 다수결은 83% 일치했다. <표 A.1>과 <표 A.2>는 독립 연구자 5인과 모델 5종 사이의 직접 일치율이다. 이진 분류에서는 다섯 모델이 모든 연구자와 대체로 80% 이상 일치해 차이가 작았다. 반면 유사성 판정에서는 모델별 편차가 더 컸는데, 특히 GLM이 사람과의 일치율이 낮았고, 오픈 가중치 모델인 Gemma는 상용 모델에 가까운 일치율을 보였다. 공개 여부만으로 판정 성능을 재단하기 어렵다는 뜻이며, 성향이 다른 여러 모델을 결합하고 인간 검토로 재확인하는 설계의 정당성을 뒷받침한다.
<표 A.1> 분류(부정 이진) 연구자·모델 간 일치율
| GPT | Claude | Gemini | Gemma | GLM | |
|---|---|---|---|---|---|
| 연구자1 | 93% | 90% | 88% | 91% | 91% |
| 연구자2 | 83% | 82% | 80% | 83% | 83% |
| 연구자3 | 87% | 88% | 86% | 89% | 85% |
| 연구자4 | 83% | 80% | 80% | 81% | 81% |
| 연구자5 | 95% | 92% | 90% | 93% | 91% |
<표 A.2> 유사도 판정 연구자·모델 간 일치율
| GPT | Claude | Gemini | Gemma | GLM | |
|---|---|---|---|---|---|
| 연구자1 | 65% | 62% | 68% | 68% | 51% |
| 연구자2 | 82% | 63% | 75% | 77% | 44% |
| 연구자3 | 81% | 68% | 82% | 82% | 49% |
| 연구자4 | 94% | 59% | 87% | 89% | 38% |
| 연구자5 | 79% | 72% | 84% | 82% | 47% |
부록 B. 임베딩 선택에 대한 강건성
대표 방식(text-embedding-3-large 제목·본문) 외에 OpenAI 명사, BGE-M3 제목·본문·명사 방식을 추가로 산출해, 각 방식의 코사인이 사람과 모델의 실제 유사성 판단에 부합하는지 같은 기준으로 비교했다(<표 B.1>). 네 방식의 적합도는 사람 77~81%, 모델 71~81%로 비슷한 범위에 놓였다. 유사성 측정 결과가 특정 임베딩 모델이나 입력 구성에만 의존한다고 보기 어렵다는 뜻이다.
<표 B.1> 임베딩 방식별 적합도
| 임베딩 방식 | 사람 적합도 | 모델 적합도 |
|---|---|---|
| oai-large (제목+본문) | 81% | 75% |
| oai-large (명사) | 80% | 71% |
| bge-m3 (제목+본문) | 77% | 81% |
| bge-m3 (명사) | 80% | 77% |
부록 C. 커버리지율·복제율의 산출 단위
두 지표를 기사쌍과 기사 단위로 각각 계산하면 성격이 갈린다. 예를 들어 6편의 기사에서 가능한 15개 쌍 가운데 같은 6편이 유사쌍을 이룬다면, 유사쌍이 3개든 9개든 기사 단위 커버리지율은 모두 100%가 되지만 기사쌍 단위로는 20%와 60%로 달라진다. 반대로 복제율은, 3편이 서로 복제 관계인 경우와 6편이 두 편씩 짝지어 복제하는 경우 모두 기사쌍 기준으로는 20%로 같지만, 기사 기준으로는 각각 50%와 100%로 갈려 '복제에 관여한 기사 규모'를 구분해 준다. 이런 이유로 커버리지율은 기사쌍 단위로, 복제율 추정치는 기사 단위로 제시했다. 전체 자료(사후 부정 21,260편, 매체 간 기사쌍 약 6,169만 쌍)에 두 단위를 모두 적용한 결과는 아래와 같다.
<표 C.1> 코사인 임계별 커버리지율·복제율(단위별)
| 코사인 임계 | 커버리지율(기사쌍) | 커버리지율(기사) | 복제율(기사) | 복제율(기사쌍) |
|---|---|---|---|---|
| ≥ 0.5 | 69.9% | 100.0% | 13.9% | 0.025% |
| ≥ 0.6 | 30.8% | 99.5% | 13.9% | 0.025% |
| ≥ 0.7 | 5.5% | 97.4% | 13.9% | 0.025% |
| ≥ 0.8 | 0.35% | 81.8% | 13.9% | 0.025% |
| ≥ 0.9 | 0.012% | 19.2% | 11.2% | 0.0068% |
| ≥ 0.95 | 0.0004% | 1.7% | 1.7% | 0.0004% |
부록 D. 대표 복제 클러스터 — 하나의 속보가 몇 개 매체로
배심원이 복제로 판정한 기사쌍을 기사 단위로 연결(union-find)하면, '같은 속보가 여러 매체에 동일 본문으로 실린' 군집이 드러난다. 관여 매체 3곳 이상인 군집은 58개였으며, 상위 군집은 아래와 같다. 이 표는 복제가 개별 쌍의 문제가 아니라 하나의 사건 보도가 다수 매체로 동시에 번지는 국면임을 보여 준다.
<표 D.1> 관여 매체 수 상위 복제 클러스터
| 사례 | 관여 매체 수 | 대표 제목 | 최고 코사인 |
|---|---|---|---|
| 롯데카드 | 11 | 방통위, 롯데카드 정보유출 연계정보 긴급 점검 | 0.979 |
| 남양유업 | 11 | 검찰, '홍원식 前회장 200억 횡령 의혹' 남양유업 전 대표 소환 | 0.980 |
| 큐텐 | 9 | [속보] 검찰, '티메프 사태' 구영배 큐텐 대표 구속영장 청구 | 0.992 |
| 홈플러스 | 9 | 검찰, 홈플러스·MBK 압수수색…경영진 사기 혐의 수사 | 0.966 |
| 홈플러스 | 7 | 홈플러스, 이달 직원 급여 분할 지급…"자금 상황 한계 도달" | 0.976 |
| 큐텐 | 6 | 인터파크트리플, 티몬·위메프에 계약해지 통보 | 0.990 |
전체 58개 군집의 상세는 데이터 딜리버리 파일 `복제기사_데이터_딜리버리.xlsx`의 「대표_복제_클러스터」 시트를 참조.
본 보고서는 게재본 논문의 확장본으로, 수치와 표는 최종 게재본 및 분석 원자료와 정합하도록 검증되었다. 매체 유형별 동조 히트맵(그림 6)은 사후 부정 기사 21,260편의 의미 임베딩으로 직접 산출하였으며, 전체 매체 간 평균 0.549가 논문 본문 값과 일치함을 확인하였다.
참고문헌
[1] 김병욱, 정경환, 이승우, 양영욱, 장홍준(2025), "뉴스 문서 계층적·점증적 군집화 성능 향상을 위한 언어 모델 기반 문서 표현 방법 고찰," 데이타베이스연구, 41(1), 53-75.
[2] 네이버 뉴스제휴위원회(2026), 「뉴스 제휴 심사 및 운영 평가 규정」.
[3] 이제욱, 김현정(2022), "뉴스 토픽모델링과 소셜네트워크 분석을 통한 스포츠-인공지능 산업·기술 트렌드 분석," 한국스포츠학회지, 20(1), 715-737. (https://doi.org/10.46669/kss.2022.20.1.064)
[4] 이현재(2015), "포털 뉴스서비스에서의 기사 어뷰징 사례와 전문가 인식 연구 [석사학위논문, 건국대학교 언론홍보대학원]."
[5] 정안용, 박진영, 남윤재(2022), "텍스트마이닝과 네트워크분석을 활용한 스마트도시 언론보도 분석," Journal of The Korean Data Analysis Society, 24(4), 1563-1582. (https://doi.org/10.37727/jkdas.2022.24.4.1563)
[6] 조영신, 유수정, 한영주(2015), "포털 기사 공급 형태 및 매체 지위와 어뷰징과의 관계에 대한 탐색적 연구," 한국언론학보, 59(6), 314-338.
[7] 진설아, 허고은, 정유경, 송민(2013), "트위터 데이터를 이용한 네트워크 기반 토픽 변화 추적 연구," 정보관리학회지, 30(1), 285-302. (https://doi.org/10.3743/KOSIM.2013.30.1.285)
[8] 최정균, 진서훈, 최종후(2017), "텍스트 마이닝 기법을 이용한 언론사별 보도 변화 양상 탐구," Journal of The Korean Data Analysis Society, 19(5), 2509-2522. (https://doi.org/10.37727/jkdas.2017.19.5.2509)
[9] 한국언론진흥재단(2023), "2023 언론수용자 조사," 한국언론진흥재단.
[10] 한국언론진흥재단(2025), "2025 언론수용자 조사," 한국언론진흥재단.
[11] 함민정, 이상우(2018), "온라인 뉴스에서 발생하는 어뷰징 행태 분석," 정보사회와 미디어, 19(2), 91-120. (https://doi.org/10.52558/ISM.2018.08.19.2.91)
[12] 홍문기, 김병희(2016), "인터넷 뉴스 어뷰징의 실효적 피해구제를 위한 제도적·기술적 개선방안," 한국광고홍보학보, 18(2), 112-147. (https://doi.org/10.16914/kjapr.2016.18.2.112)
[13] Amigó, E., Gonzalo, J., Artiles, J., and Verdejo, F.(2009), "A comparison of extrinsic clustering evaluation metrics based on formal constraints," Information Retrieval, 12(4), 461-486. (https://doi.org/10.1007/s10791-008-9066-8)
[14] Bagga, A., and Baldwin, B.(1998), "Algorithms for scoring coreference chains," Proceedings of the LREC Workshop on Linguistic Coreference, 563-566.
[15] Besley, T., and Prat, A.(2006), "Handcuffs for the grabbing hand? Media capture and government accountability," American Economic Review, 96(3), 720-736. (https://doi.org/10.1257/aer.96.3.720)
[16] Broder, A. Z.(1997), "On the resemblance and containment of documents," Proceedings of the Compression and Complexity of Sequences (SEQUENCES 97), 21-29. (https://doi.org/10.1109/SEQUEN.1997.666900)
[17] Cascio, M. A., Lee, E., Vaudrin, N., and Freedman, D. A.(2019), "A team-based approach to open coding: Considerations for creating intercoder consensus," Field Methods, 31(2), 116-130. (https://doi.org/10.1177/1525822X19838237)
[18] Chen, J., Xiao, S., Zhang, P., Luo, K., Lian, D., and Liu, Z.(2024), "M3-Embedding: Multi-Linguality, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation," arXiv:2402.03216. (https://doi.org/10.48550/arXiv.2402.03216)
[19] Chen, X., Hale, S. A., Jurgens, D., Samory, M., Zuckerman, E., and Grabowicz, P. A.(2024), "Global news synchrony and diversity during the start of the COVID-19 pandemic," Proceedings of the ACM Web Conference 2024, 2639-2650. (https://doi.org/10.1145/3589334.3645645)
[20] Chiang, C.-H., and Lee, H.-Y.(2023), "Can large language models be an alternative to human evaluations?," Proceedings of ACL 2023, 15607-15631. (https://doi.org/10.18653/v1/2023.acl-long.870)
[21] Davies, N.(2008), "Flat earth news," London: Chatto & Windus.
[22] Devlin, J., Chang, M.-W., Lee, K., and Toutanova, K.(2019), "BERT: Pre-training of deep bidirectional transformers for language understanding," Proceedings of NAACL-HLT, 4171-4186. (https://doi.org/10.18653/v1/N19-1423)
[23] Gandy, O. H.(1982), "Beyond agenda setting: Information subsidies and public policy," Norwood, NJ: Ablex.
[24] Gao, T., Yao, X., and Chen, D.(2021), "SimCSE: Simple contrastive learning of sentence embeddings," Proceedings of EMNLP 2021, 6894-6910. (https://doi.org/10.18653/v1/2021.emnlp-main.552)
[25] Gilberg, S., Eyal, C., McCombs, M., and Nicholas, D.(1980), "The state of the union address and the press agenda," Journalism Quarterly, 57(4), 584-588. (https://doi.org/10.1177/107769908005700405)
[26] Hanley, H. W. A., and Durumeric, Z.(2025), "Hierarchical level-wise news article clustering via multilingual Matryoshka embeddings," Proceedings of ACL 2025, 2476-2492. (https://doi.org/10.18653/v1/2025.acl-long.124)
[27] Jackson, D., and Moloney, K.(2016), "Inside churnalism: PR, journalism and power relationships in flux," Journalism Studies, 17(6), 763-780. (https://doi.org/10.1080/1461670X.2015.1017597)
[28] Lee, J., and Berkowitz, D.(2004), "Third gatekeeping in Korea: The screening of first-edition newspapers by public relations practitioners," Public Relations Review, 30(3), 313-325. (https://doi.org/10.1016/j.pubrev.2004.05.004)
[29] Lewis, J., Williams, A., and Franklin, B.(2008), "A compromised fourth estate? UK news journalism, public relations and news sources," Journalism Studies, 9(1), 1-20. (https://doi.org/10.1080/14616700701767974)
[30] Mann, H. B., and Whitney, D. R.(1947), "On a test of whether one of two random variables is stochastically larger than the other," Annals of Mathematical Statistics, 18(1), 50-60. (https://doi.org/10.1214/aoms/1177730491)
[31] Manning, C. D., Raghavan, P., and Schütze, H.(2008), "Introduction to information retrieval," Cambridge University Press.
[32] McCombs, M. E., and Shaw, D. L.(1972), "The agenda-setting function of mass media," Public Opinion Quarterly, 36(2), 176-187. (https://doi.org/10.1086/267990)
[33] Miranda, S., Znotiņš, A., Cohen, S. B., and Barzdins, G.(2018), "Multilingual clustering of streaming news," Proceedings of EMNLP 2018, 4535-4544. (https://doi.org/10.18653/v1/D18-1483)
[34] Nicholls, T.(2019), "Detecting textual reuse in news stories, at scale," International Journal of Communication, 13, 4173-4197.
[35] OpenAI(2024), "New embedding models and API updates," OpenAI. (https://openai.com/index/new-embedding-models-and-api-updates/)
[36] Reese, S. D., and Danielian, L. H.(1989), "Intermedia influence and the drug issue: Converging on cocaine," In Communication campaigns about drugs (pp. 29-45). Lawrence Erlbaum.
[37] Reimers, N., and Gurevych, I.(2019), "Sentence-BERT: Sentence embeddings using Siamese BERT-networks," Proceedings of EMNLP-IJCNLP 2019, 3982-3992. (https://doi.org/10.18653/v1/D19-1410)
[38] Saldaña, J.(2015), "The coding manual for qualitative researchers (3rd ed.)," Los Angeles, CA: SAGE Publications.
[39] Saravanakumar, K. K., Ballesteros, M., Chandrasekaran, M. K., and McKeown, K.(2021), "Event-driven news stream clustering using entity-aware contextual embeddings," Proceedings of EACL 2021, 2330-2340. (https://doi.org/10.18653/v1/2021.eacl-main.198)
[40] Schiffrin, A.(2018), "Introduction to special issue on media capture," Journalism, 19(8), 1033-1042. (https://doi.org/10.1177/1464884917725167)
[41] Verga, P., Hofstätter, S., Althammer, S., Su, J., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P.(2024), "Replacing judges with juries: Evaluating LLM generations with a panel of diverse models," arXiv:2404.18796. (https://doi.org/10.48550/arXiv.2404.18796)
[42] Zhang, X.(2018), "Intermedia agenda-setting effect in corporate news: Examining the influence of The New York Times and The Wall Street Journal on local newspapers," Journal of Applied Journalism & Media Studies, 7(2), 245-263. (https://doi.org/10.1386/ajms.7.2.245_1)
[43] Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., and Stoica, I.(2023), "Judging LLM-as-a-judge with MT-Bench and Chatbot Arena," Advances in Neural Information Processing Systems (NeurIPS 2023), Datasets and Benchmarks Track. arXiv:2306.05685. (https://doi.org/10.48550/arXiv.2306.05685)