AI For All Lab · Research Portal · LLM 배심원
AI에게 채점을 맡길 때, 몇 명에게 물어야 하는가
한 모델에게 물을 것인가, 여러 모델의 중앙값 투표(중위수, median)를 쓸 것인가. 이 연구는 같은 AI에게 상황만 바꿔 제시하는 개체 내 설계로, 배심원 방식이 언제 이득이고 언제 무용한지를 인과적으로 규명한다.
질문 1
배심원은 언제 필요한가
쉬운 과제에도 여러 모델을 돌릴 가치가 있는가
질문 2
루브릭이면 충분하지 않은가
좋은 채점 기준표가 배심원을 대신할 수 있는가
질문 3
왜 독립 투표여야 하는가
앞선 답을 보여주면 무슨 일이 생기는가
논문 한 편을 한 페이지로 읽기
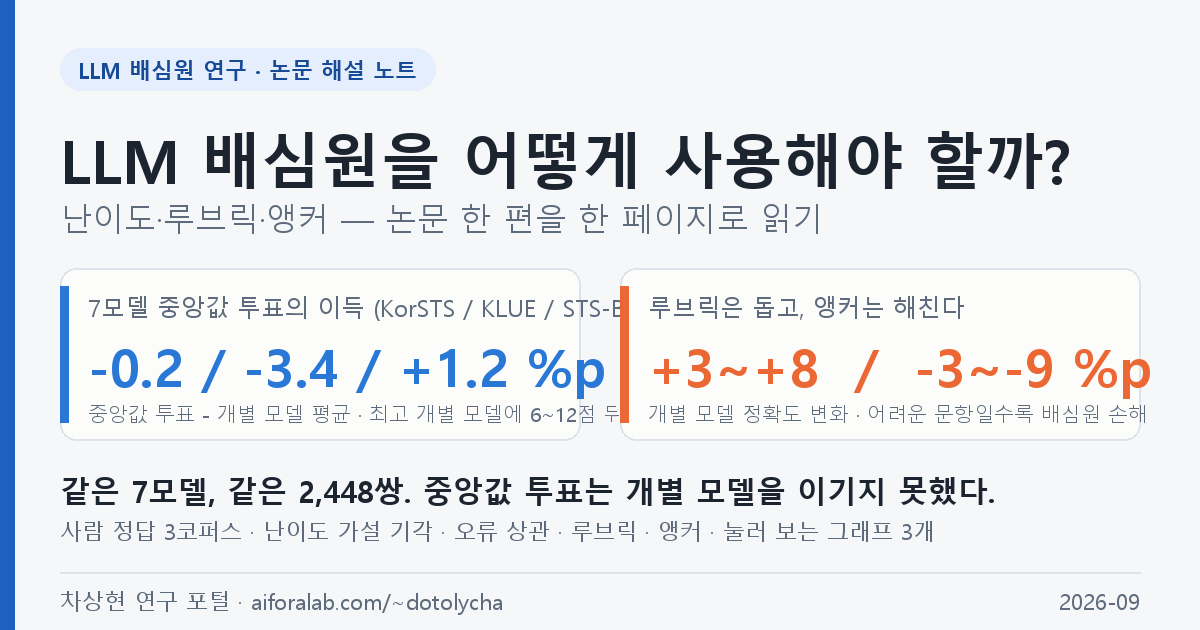
투고 원고(Do LLM Juries Beat Their Own Members? Difficulty, Rubrics, and Anchoring in Multi-LLM Similarity Grading on Human-Labelled Korean and English Benchmarks)의 논리를 결과 순서 그대로 12개 절로 정리한 해설 노트다. 아래 포털이 "무엇을 어떤 순서로 했나"의 기록이라면, 해설 노트는 "논문이 무엇을 주장하고 무엇으로 뒷받침하나"를 눌러 보는 그래프와 함께 설명한다.
왜 지금 중요한가
데이터 라벨링, 문서 분류, 답안 채점, 콘텐츠 심사가 빠르게 LLM에게 넘어가고 있다. 문제는 AI의 판정을 얼마나, 언제 믿을 수 있는가에 대한 근거 있는 지침이 아직 없다는 것이다.
비용의 문제
배심원 방식의 비용은 모델 수에 비례한다. 언제 하나로 충분하고 언제 여럿이 필요한지 알면 평가 비용이 몇 배 달라진다. 루브릭이 배심원을 대신할 수 있다면 절감 폭은 더 커진다.
신뢰의 문제
오류의 대가가 큰 평가에 AI 판정 활용이 늘고 있다. 그러나 모델들끼리 일치한다고 정답인 것은 아니며(일관성 ≠ 타당성; Norman et al., 2026), 사람은 제시된 AI 답에 동조하는 경향이 보고되어 있다(Rathi et al., 2025).
지식의 공백
배심원의 이득이 언제 생기고 사라지는지를 요인 조작으로 규명한 연구는 드물다. 오류 상관이 다수결 이득을 제약한다는 보고(Kim et al., 2025; Kohli, 2026)는 있으나, 왜, 어떤 조건에서는 비어 있다.
판정자 한 명에서 배심원단까지
| 연도 | 전환점 | 내용 |
|---|---|---|
| 2023 | 판정자 1명의 시대 | GPT-4 한 모델이 심판을 봤다. 장황성 편향과 위치 편향이 드러났다 (Zheng et al.; Liu et al.) |
| 2024 | 배심원 3명의 등장 | 서로 다른 회사의 작은 모델 3개가 큰 모델 하나보다 정확하고 비용은 1/7이었다 (Verga et al., PoLL) |
| 2025 | 오류 상관, 그리고 과의존 | 회사가 달라도 LLM들은 같은 문제를 같이 틀린다(Kim et al.). 사람은 과신하는 LLM 출력을 그대로 따른다(Rathi et al.) |
| 2026 | “9명 중 실효 2표” | 판정자 9명을 모아도 오류가 겹쳐 실질적으로 2표였다(Kohli). 일관성이 높다고 정답에 가까운 것도 아니었다(Norman et al.) |
세 가지 확증 가설
H1 · 배심원의 이득은 어려운 과제일수록 커진다
쉬운 문제는 모델 하나로 충분하다. 어려운 문제일수록 각 모델의 실수 지점이 갈리고, 그때 중앙값 투표가 실수를 지운다. 여기서 ‘어렵다’는 사람 정답 등급(1~5)으로 보고, 평가자별 점수가 있는 KLUE-STS에서는 사람 평가자 편차로도 본다. 배심원 자신의 불일치로 난이도를 정하면 같은 표로 기준도 정하고 성적도 매기는 순환이 되므로 쓰지 않는다.
H2 · 루브릭은 개별 모델과 배심원을 함께 올리는가
상세한 채점 기준표가 개별 모델의 정확도와 중앙값 투표의 정확도를 함께 올리는지, 그리고 루브릭이 있을 때 배심원 이득이 살아나는지를 검정한다. 루브릭과 중앙값 투표를 함께 검정한 선행연구는 없다.
H3 · 답을 보여주면 배심원은 무너지고, 루브릭은 이를 누그러뜨리는가
판정 전에 앞선 답을 보여주면 AI도 동조한다. 중앙값 투표가 첫 답의 메아리가 되어 배심원 이득이 사라지는지, 그리고 루브릭이 이 앵커 효과를 얼마나 줄이는지(루브릭 × 앵커 상호작용)를 함께 검정한다.
세 가설이 지지되면 나오는 지침
쉬운 과제는 개별 모델 하나 + 루브릭으로, 어려운 과제만 배심원으로, 투표는 항상 독립적으로.
같은 AI에게 다른 상황을
사람 실험처럼 설계하되 참가자는 전원 LLM 에이전트다. 동일한 에이전트에게 동일한 문항을 상황만 바꿔 제시한다. 같은 에이전트가 자기 자신의 통제집단이 되므로 판정의 변화가 곧 조작의 효과이며, 모델 차이로 생기는 변동이 원천적으로 제거된다.
| 요인 | 수준 | 연결 가설 |
|---|---|---|
| 과제 난이도 | 사람 정답 등급 1~5 (순서를 미리 정하지 않고 실측) + KLUE-STS 사람 평가자 편차 | H1 |
| 스코어 루브릭 | 없음 / 상세 제공 | H2 |
| 답 제시(앵커) | 블라인드 / 앞선 판정 제시(정답±1) | H3 |
| 루브릭 × 앵커 | 루브릭이 있을 때와 없을 때의 앵커 효과 차이 | H3 (완화) |
| 배심원 크기 | 1 · 3 · 5 · 7명 재표집 | 사후 분석 |
난이도
난이도는 사람 정답 등급(1~5)으로 본다. 처음에는 양 끝(1·5)이 쉽고 가운데(3)가 어렵다고 가정했지만, 순서를 강제하지 않고 등급마다 실측한 정확도를 그대로 보고한다. KLUE-STS는 평가자 5~7명의 개별 점수가 있어 사람 평가자 편차(표준편차)로도 난이도를 정한다.
실제 판정 프롬프트
다음 두 문장의 주제 유사도를 1(무관)~5(동일)로 판정하세요.


문장1: 오늘 오후부터 전국에 비가 내리겠습니다.


문장2: 오늘 오후 들어 전국적으로 비가 오겠습니다.


숫자 하나만 답하세요.
루브릭 조건에서는 5단계 채점 기준을 덧붙이고, 앵커 조건에서는
참고: 앞선 판정자는 이 쌍을 N점으로 판정했습니다를 덧붙인다.
N은 언제나 정답에서 한 칸 벗어난 값이다.
배심원 7인
계열 다양성을 최우선으로 삼았다. 오류 상관을 낮추는 것이 배심원의 제1원칙이기 때문이다(Verga et al., 2024). 전 모델 온도 0, 추론 비활성, 버전 고정으로 재현성을 확보했다. 배심원 판정은 7개 점수의 중앙값 투표(중위수, median)로 정한다. 비교 기준인 개별 모델 평균은 7개 모델을 각각 단독으로 썼을 때 정확도의 평균이다.
| # | 모델 | 계열 | 크기 | 실행 위치 | 단가 입력 / 출력 |
|---|---|---|---|---|---|
| 1 | Gemma 4 (8B) | Google 오픈 | 8B, 4비트 양자화 | 연구실 서버 (Ollama, RTX 3090 × 3) | 0 / 0 |
| 2 | Llama 3.1 (8B) | Meta 오픈 | 8B, 4비트 양자화 | 연구실 서버 | 0 / 0 |
| 3 | EXAONE 3.5 (7.8B) | LG 오픈 | 7.8B, 4비트 양자화 | 연구실 서버 | 0 / 0 |
| 4 | GPT-OSS 120B | OpenAI 오픈 | 120B MoE | Cerebras API | 0.25 / 0.69 |
| 5 | GPT-4o-mini | OpenAI 상용 | 비공개 (소형) | OpenAI API | 0.15 / 0.60 |
| 6 | Claude Haiku 4.5 | Anthropic 상용 | 비공개 (소형) | Anthropic API | 1.00 / 5.00 |
| 7 | Gemini 2.5 Flash | Google 상용 | 비공개 (소형) | Google Gemini API | 0.30 / 2.50 |
심판 구성 변경 이력
초기 후보는 9인이었다. 수집 안정성 문제로 Qwen 3.6이 제외되었고, GLM 4.7은 수집 완료 후 제공사 서비스가 종료되어 재현이 불가능해져 확정 구성에서 제외했다. 이후의 모든 결과는 위 7인 기준이다.
세 개의 자료를 각각 분석한다
같은 실험 설계를 서로 독립된 세 자료에 각각 적용한다. 하나가 다른 하나를 검증하는 관계가 아니다. 같은 질문을 세 번 묻고, 답이 자료와 언어를 넘어 재현되는지를 본다.
세 자료 모두 사람이 매긴 공개 벤치마크다. 정답은 사람 점수를 1~5 등급으로 옮긴 값이고, 배심원 7모델이 2,448쌍 전부를 네 조건에서 판정했다(68,544 판정, 결측 0).
| 자료 | 정답의 출처 | 규모 | 현황 |
|---|---|---|---|
| KorSTS | 사람 라벨 — 쌍별 평균 점수 | 1,379쌍 | 판정 38,612건 수집 · 1차 분석 완료 |
| KLUE-STS | 사람 라벨 — 주석자 7명 개별 점수 | 519쌍 | 판정 14,532건 수집 · 1차 분석 완료 |
| STS-B | 사람 라벨 — 영어 표준 벤치마크 | 550쌍 | 판정 15,400건 수집 · 1차 분석 완료 |
KLUE-STS가 갖는 별도의 쓸모
KLUE-STS는 주석자 7명의 개별 점수가 공개되어 있다. 사람들이 한 문항에서 얼마나 갈렸는지를 직접 셀 수 있으므로, 이 자료에서는 난이도를 사람의 불일치로도 정의할 수 있다. 다른 두 자료에서는 불가능한 분석이다.
사람 라벨 세 자료의 결과
같은 2×2 설계(루브릭×앵커)와 배심원 7모델로 세 자료를 분석한 결과다. 블라인드·무루브릭 기준, 배심원 = 7개 점수의 중앙값 투표(중위수, median), 정답 = 사람 등급 1~5. 배심원 이득 = 중앙값 투표 정확도 − 개별 모델 평균 정확도(7개 모델을 각각 단독으로 썼을 때 정확도의 평균)(%p), 문항 단위 부트스트랩 2,000회 95% CI. 그림과 해설은 위 논문 해설 노트에 있다.
배심원 vs 개별 모델 — 중앙값 투표는 개별 모델 평균을 못 이긴다
| 지표 | KorSTS (사람·한) | KLUE-STS (사람·한) | STS-B (사람·영) |
|---|---|---|---|
| 문항수 | 1,379 | 519 | 550 |
| 개별 모델 평균 정확일치 | 30.8% | 17.6% | 35.1% |
| 최고 개별 모델 | 39.9% (Claude Haiku 4.5) | 26.2% (Llama 3.1) | 42.4% (EXAONE 3.5) |
| 중앙값 투표 (7모델) | 30.6% | 14.3% | 36.4% |
| 배심원 이득 [95% CI] | −0.2 [−1.5, +1.2] | −3.4 [−4.7, −2.0]* | +1.2 [−0.5, +3.0] |
| 중앙값 투표가 앞서는 개별 모델 수 (7개 중) | 4 | 0 (동률 2) | 4 |
| 최고 개별 모델과의 차이 | −9.3 | −11.9 | −6.0 |
| 배심원 ±1 인접 | 78.4% | 51.6% | 76.5% |
| 순위상관 ρ (중앙값 투표 vs 사람 등급) | 0.79 | 0.83 | 0.83 |
| 배심원 크기 1 → 3 → 5 → 7명 | 30.8 → 31.2 → 30.9 → 30.6% | 17.6 → 15.6 → 14.9 → 14.3% | 35.1 → 36.3 → 36.6 → 36.4% |
* = 95% CI가 0을 포함하지 않음. 세 자료 어디에서도 중앙값 투표가 개별 모델 평균을 유의하게 넘지 못하고, 최고 개별 모델이 6~12점 앞선다. 중앙값 투표가 앞서는 개별 모델은 7개 중 0~4개이며, 3코퍼스 × 4조건 × 5등급 = 60개 셀 어디에서도 7개 전부를 앞서지 못한다(아래 개별 모델별 표). 배심원을 1명에서 7명으로 늘려도 정확도는 그대로다(모든 부분집합 평균). 순위는 잘 맞지만(ρ 0.79~0.83) 사람 등급을 그대로 맞히지는 못한다.
H1 — 사람 등급별 배심원 이득 (개별 모델 평균 → 중앙값 투표, Δ)
H1은 어려운 문항일수록 배심원 이득이 커진다고 예측했다. 결과는 반대다. 등급 1~3에서 배심원이 개별 모델 평균보다 유의하게 나쁘고, 5등급(그리고 KorSTS의 4등급)에서만 좋다. 등급 2·3은 개별 모델 자신에게도 가장 어려운 등급이라, 배심원은 도움이 가장 필요한 곳에서 실패한다. H1 기각.
| 사람 등급 | KorSTS | KLUE-STS | STS-B |
|---|---|---|---|
| 1 (무관) | 24.1 → 20.3 (−3.8*) | 7.9 → 4.4 (−3.5*) | 30.9 → 30.9 (0.0) |
| 2 | 11.6 → 7.0 (−4.5*) | 4.2 → 2.2 (−1.9) | 8.1 → 3.6 (−4.4*) |
| 3 | 20.9 → 11.3 (−9.7*) | 9.4 → 1.9 (−7.5*) | 7.3 → 5.5 (−1.8) |
| 4 | 44.1 → 56.7 (+12.6*) | 17.1 → 9.1 (−8.1*) | 56.8 → 58.2 (+1.4) |
| 5 (동일) | 67.1 → 73.1 (+6.0*) | 84.4 → 96.4 (+11.9*) | 72.6 → 83.6 (+11.0*) |
| KLUE-STS 사람 평가자 편차 | n | 개별 모델 평균 | 중앙값 투표 | 이득 [95% CI] |
|---|---|---|---|---|
| 하위 (SD 0.00–0.50) | 198 | 32.6% | 31.3% | −1.3 [−3.7, +1.2] |
| 중간 (0.53–0.76) | 149 | 10.1% | 3.4% | −6.7 [−8.8, −4.8]* |
| 상위 (0.80–1.75) | 172 | 7.0% | 4.1% | −2.9 [−4.9, −0.7]* |
단위 %, 괄호 안은 이득 %p, * = 95% CI가 0 미포함. 사람 등급별 n: KorSTS 374/242/284/323/156, KLUE-STS 159/89/106/110/55, STS-B 110씩. KLUE-STS에서 사람 평가자 편차는 개별 모델 오류와 상관이 있고(ρ = 0.35) 등급 2·3에서 가장 크다. 모델과 무관한 난이도 정의로도 배심원은 어려운 문항에서 진다. 이유는 개별 모델들이 같은 방향(위쪽)으로 함께 틀려 중앙값이 그 오류를 물려받기 때문이다.
H2 — 루브릭 효과 (문항 단위 부트스트랩 95% CI)
루브릭은 개별 모델과 배심원을 함께 올린다. 세 자료 모두 개별 모델 평균과 중앙값 투표가 함께 오르지만, 루브릭 조건에서도 배심원 이득은 −0.9 / −5.0 / +0.3으로 살아나지 않는다. 즉 루브릭은 배심원을 대신하는 것이 아니라 개별 모델과 배심원을 같은 폭으로 밀어 올린다. H2 지지.
| 자료 | 루브릭 효과 (개별 모델) | 루브릭 효과 (중앙값 투표) | 루브릭 조건의 배심원 이득 |
|---|---|---|---|
| KorSTS | +8.4 [+7.4, +9.3]* | +8.7 [+6.9, +10.4]* | −0.9 |
| KLUE-STS | +4.7 [+3.7, +5.7]* | +3.6 [+2.2, +5.2]* | −5.0 |
| STS-B | +3.2 [+2.1, +4.3]* | +1.8 [0.0, +3.7]* | +0.3 |
단위 %p. 루브릭 효과는 앵커 유무를 평균한 문항 쌍 차이(루브릭 있음 − 없음). 4등급 문항에서는 루브릭이 표를 5점 쪽으로 밀어 올려(KorSTS 5점 표 39 → 60%, STS-B 42 → 56%) 4등급 정확도가 오히려 내려간다.
H3 — 앵커 효과와 루브릭의 완화 (문항 단위 부트스트랩 95% CI)
앵커는 개별 모델과 배심원을 함께 내리며 표를 앵커값 쪽으로 끌어당긴다. 배심원은 앵커에 개별 모델보다 더 크게 무너진다(앵커에 끌린 일곱 표가 앵커값으로 수렴하면 중앙값이 따라간다). 루브릭이 앵커 효과를 누그러뜨리는 상호작용은 한국어 두 자료에서만 유의하고 STS-B에서는 유의하지 않다. H3 지지, 루브릭의 완화는 부분 지지.
| 자료 | 앵커 효과 (개별 모델) | 앵커 효과 (중앙값 투표) | 루브릭 × 앵커 (완화) | 표 = 앵커값 비율 (앵커 제시 / 블라인드) |
|---|---|---|---|---|
| KorSTS | −8.6 [−9.3, −7.9]* | −12.6 [−14.2, −11.0]* | +8.7 [+7.6, +9.8]* | 52.0% / 38.8% |
| KLUE-STS | −3.8 [−4.6, −3.1]* | −3.4 [−4.7, −2.0]* | +3.1 [+1.9, +4.4]* | 47.3% / 35.9% |
| STS-B | −2.8 [−3.8, −1.8]* | −4.4 [−6.3, −2.5]* | +0.5 [−0.9, +1.8] | 41.9% / 39.7% |
단위 %p. 앵커 효과는 루브릭 유무를 평균한 문항 쌍 차이(앵커 제시 − 블라인드). 완화 = 루브릭 있을 때의 앵커 효과 − 없을 때의 앵커 효과(개별 모델). 앵커를 보이면 개별 모델의 순위도 뒤집힌다(블라인드 대비 순위 상관 −0.18~0.32).
다국면 Rasch — 심판 능력 θ (로짓, 자료별)
정답 여부를 θ(심판) − β(문항) + 조건으로 모형화해 심판 능력과 문항 난이도를 분리. θ가 높을수록 난이도를 통제한 뒤에도 잘 맞히는 심판.
| 심판(모델) | KorSTS | KLUE | STS-B |
|---|---|---|---|
| Claude Haiku 4.5 | +0.28 | −0.04 | +0.61 |
| GPT-4o-mini | +0.37 | +0.32 | +0.19 |
| EXAONE 3.5 | +0.35 | −0.04 | +0.72 |
| GPT-OSS 120B | −0.61 | −0.50 | −0.45 |
| Gemini 2.5 Flash | −0.40 | −0.52 | −0.21 |
| Gemma 4 | −0.18 | −0.36 | +0.10 |
| Llama 3.1 | +0.19 | +1.13 | −0.97 |
| 문항SD / 심판SD | 2.78 / 0.37 | 3.51 / 0.54 | 3.74 / 0.55 |
세 자료 모두 문항SD ≫ 심판SD — 맞고 틀림의 변동이 심판보다 문항 난이도에서 훨씬 크다. KLUE 문항난이도 β는 사람 주석자 편차와 ρ = +0.37로 정렬(타당성).
개별 모델별 정확일치와 순위
같은 문항을 개별 모델 하나로만 채점했을 때의 정확일치다. 중앙값 투표는 어느 코퍼스·조건에서도 7개 모델 전부를 앞서지 못한다. 상위 3개(EXAONE 3.5, GPT-4o-mini, Claude Haiku 4.5)와 하위 2개(Gemma 4, GPT-OSS 120B)는 대체로 고정이지만, Llama 3.1은 KLUE-STS에서 1위, STS-B에서 7위로 코퍼스에 따라 크게 움직인다. 코퍼스 간 순위 상관은 KorSTS–STS-B 0.71, KorSTS–KLUE 0.52, KLUE–STS-B 0.20이다. 루브릭을 주면 순위가 거의 유지되지만(블라인드 대비 0.82~0.86), 앵커를 보이면 순위가 뒤집힌다(−0.18~0.32).
| 모델 | 블라인드 | 루브릭 | 앵커 | 루브릭+앵커 |
|---|---|---|---|---|
| Gemini 2.5 Flash | 26.9 (4) | 27.3 (5) | 16.2 (5) | 21.8 (6) |
| Gemma 4 (8B) | 23.4 (7) | 26.8 (6) | 23.4 (2) | 30.2 (4) |
| EXAONE 3.5 (7.8B) | 35.8 (3) | 46.0 (2) | 7.8 (7) | 43.3 (1) |
| GPT-4o-mini | 39.1 (2) | 48.6 (1) | 16.8 (4) | 29.9 (5) |
| GPT-OSS 120B | 23.9 (6) | 24.3 (7) | 15.2 (6) | 18.9 (7) |
| Claude Haiku 4.5 | 39.9 (1) | 36.0 (3) | 18.7 (3) | 34.4 (3) |
| Llama 3.1 (8B) | 26.5 (5) | 35.0 (4) | 26.8 (1) | 35.4 (2) |
| 중앙값 투표 | 30.6 | 33.9 | 12.7 | 26.7 |
| 중앙값 투표가 앞서는 개별 모델 수 (7개 중) | 4 | 3 | 1 | 2 |
| 모델 | 블라인드 | 루브릭 | 앵커 | 루브릭+앵커 |
|---|---|---|---|---|
| Gemini 2.5 Flash | 14.6 (5) | 13.7 (7) | 12.5 (3) | 12.7 (7) |
| Gemma 4 (8B) | 14.3 (6) | 14.3 (5) | 13.9 (2) | 15.6 (5) |
| EXAONE 3.5 (7.8B) | 18.3 (3) | 25.2 (3) | 4.6 (7) | 17.9 (3) |
| GPT-4o-mini | 18.5 (2) | 32.9 (1) | 8.7 (5) | 17.9 (4) |
| GPT-OSS 120B | 14.3 (7) | 14.3 (6) | 12.5 (4) | 13.1 (6) |
| Claude Haiku 4.5 | 17.3 (4) | 18.7 (4) | 8.1 (6) | 22.2 (2) |
| Llama 3.1 (8B) | 26.2 (1) | 26.4 (2) | 25.4 (1) | 30.1 (1) |
| 중앙값 투표 | 14.3 | 15.8 | 8.9 | 14.5 |
| 중앙값 투표가 앞서는 개별 모델 수 (7개 중) | 0 (동률 2) | 3 | 3 | 2 |
| 모델 | 블라인드 | 루브릭 | 앵커 | 루브릭+앵커 |
|---|---|---|---|---|
| Gemini 2.5 Flash | 35.6 (4) | 31.5 (6) | 32.9 (4) | 31.1 (5) |
| Gemma 4 (8B) | 34.2 (5) | 37.3 (4) | 34.5 (3) | 39.3 (3) |
| EXAONE 3.5 (7.8B) | 42.4 (1) | 45.3 (2) | 41.3 (2) | 44.9 (1) |
| GPT-4o-mini | 42.0 (2) | 49.3 (1) | 22.9 (7) | 35.3 (4) |
| GPT-OSS 120B | 31.8 (6) | 32.7 (5) | 24.5 (6) | 30.9 (6) |
| Claude Haiku 4.5 | 37.8 (3) | 43.8 (3) | 42.4 (1) | 44.9 (2) |
| Llama 3.1 (8B) | 22.0 (7) | 26.7 (7) | 26.0 (5) | 22.4 (7) |
| 중앙값 투표 | 36.4 | 38.4 | 32.2 | 33.8 |
| 중앙값 투표가 앞서는 개별 모델 수 (7개 중) | 4 | 4 | 3 | 3 |
모델 등급은 동등하지 않다: 8B급 로컬 오픈 모델 3개(연구실 서버, 4비트 양자화), 상용 소형 API 3개, 120B MoE 오픈 모델 1개(Cerebras API). 단가와 실행 환경은 모델 비용·등급 표 참조.
자료·프로그램 내려받기
투명성·재현성 검토용 패키지: llm_jury_repro_20260911.zip (1.3 MB). 문항 파일 3종과 판정 원자료 68,544건(jsonl), 집계·그림 스크립트, 결과 파일과 그림, README(프롬프트·실행법)를 담았다. API 키와 서버 정보는 포함하지 않는다. 표 파일: 개별 모델 정확도·순위 · 모델 비용·등급.
지금까지 한 것
사람 라벨 세 자료의 진행 상황이다. KorSTS·KLUE-STS·STS-B 수집·분석과 확증 분석·다국면 Rasch·논문 원고까지 완료했다.
KorSTS — 판정 수집·1차 분석
1,379쌍 × 심판 7 × 조건 4 = 38,612판정, 실패 0. 사람 라벨 기준 적중률 확보.
KLUE-STS — 판정 수집·사람 불일치 난이도
519쌍 · 14,532판정. 주석자 7명 편차를 난이도로 한 분석까지 수행.
STS-B — 교차언어 확인
550쌍 · 15,400판정. 결과가 언어를 넘어 재현되는지 확인.
세 자료 통합 보고
자료별 적중률·순위상관·배심원 이득·배심원 크기를 나란히 정리. 위 결과 섹션에 공개.
다국면 Rasch 모형
심판 능력·문항 난이도를 분리 추정. 문항SD ≫ 심판SD(난이도 분리 유효), KLUE 문항난이도 β vs 사람 편차 ρ=+0.37.
확증 분석 — 부트스트랩 95% CI
H2 루브릭↑·H3 앵커↓는 세 자료 모두 유의, 루브릭의 앵커 완화는 한국어 두 자료에서만 유의. H1은 등급 1~3과 KLUE 사람 편차 중·상위 구간에서 배심원 이득이 유의하게 마이너스(기각).
논문 원고 v7·해설 노트
사람 라벨 세 자료, 난이도(등급·사람 편차), 루브릭, 앵커, 배심원 크기로 범위를 확정해 영문 원고를 작성. v7은 투고 체크리스트에 맞춰 제목 페이지 분리·익명 원고·그림 파일 분리·DOI를 반영. 논문 전체를 한 페이지로 읽는 해설 노트 공개.
개별 모델 비교·재현 패키지
개별 모델별 정확도·순위 표(코퍼스 × 조건), 모델 비용·등급 표, 판정 원자료 68,544건과 프로그램을 담은 재현 패키지를 위 결과 섹션에 공개.
앞으로 할 것
분석은 완료돼 위 지금까지 한 것으로 올렸다. 남은 것은 투고 준비다.
투고 준비
제목과 결론 문구 확정(교수님 상의), 재현 패키지(결과 섹션의 자료·프로그램 내려받기)를 공개 저장소에 기탁해 DOI 확보, 선언문 등 제출 서류 정리.
논문
가제 「Do LLM Juries Beat Their Own Members? Difficulty, Rubrics, and Anchoring in Multi-LLM Similarity Grading on Human-Labelled Korean and English Benchmarks」 — 사람 라벨 세 자료의 결과를 본론으로, Information Processing & Management(SCIE/SSCI) 투고를 목표로 한다. 제목은 확정 전이다.
참고문헌
APA 7판 형식. 영문 알파벳순.
- Fasolo, B., Heard, C., & Scopelliti, I. (2025). Mitigating cognitive bias to improve organizational decisions: An integrative review, framework, and research agenda. Journal of Management. https://doi.org/10.1177/01492063241287188
- Ham, J., Choe, Y. J., Park, K., Choi, I., & Soh, H. (2020). KorNLI and KorSTS: New benchmark datasets for Korean natural language understanding. Findings of the ACL: EMNLP 2020. [KorSTS]
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. https://doi.org/10.48550/arXiv.2506.07962
- Kim, S., Shin, J., Cho, Y., Jang, J., Longpre, S., Lee, H., … Seo, M. (2024). Prometheus: Inducing fine-grained evaluation capability in language models. ICLR 2024. https://doi.org/10.48550/arXiv.2310.08491
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv. https://doi.org/10.48550/arXiv.2605.29800
- Liu, Y., Iter, D., Xu, Y., Wang, S., Xu, R., & Zhu, C. (2023). G-Eval: NLG evaluation using GPT-4 with better human alignment. EMNLP 2023, 2511–2522. https://doi.org/10.18653/v1/2023.emnlp-main.153
- Norman, J. D., Rivera, M. U., & Hughes, D. A. (2026). Reliability without validity: A systematic, large-scale evaluation of LLM-as-a-judge models across agreement, consistency, and bias. arXiv. https://doi.org/10.48550/arXiv.2606.19544
- Park, S., Moon, J., Kim, S., et al. (2021). KLUE: Korean Language Understanding Evaluation. NeurIPS 2021, Datasets and Benchmarks Track. [KLUE-STS]
- Rathi, N., Jurafsky, D., & Zhou, K. (2025). Humans overrely on overconfident language models, across languages. arXiv. https://doi.org/10.48550/arXiv.2507.06306
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., … Perez, E. (2024). Towards understanding sycophancy in language models. ICLR 2024. https://doi.org/10.48550/arXiv.2310.13548
- Verga, P., Hofstätter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., … Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv. https://doi.org/10.48550/arXiv.2404.18796
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., … Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. NeurIPS 2023, Datasets and Benchmarks Track. https://doi.org/10.48550/arXiv.2306.05685